OSS Scanner: Anthropic prüft Open Source auf Lücken, ohne Menschen dazwischen
Die Modelle finden inzwischen mehr Sicherheitslücken, als Menschen prüfen können. Diesen Engpass beschreibt Anthropic selbst, und der neue Dienst OSS Scanner, seit dem 8. Oktober 2026 verfügbar, soll ihn umgehen. Ausgewählte Open-Source-Projekte bekommen regelmäßige Sicherheitsscans durch Anthropics stärkste Modelle, darunter Claude Mythos, kostenlos. Die Berichte gehen direkt an die Maintainer, ohne dass ein Mensch sie vorher geprüft hat, und sie werden nicht veröffentlicht.
Der Engpass ist der Mensch
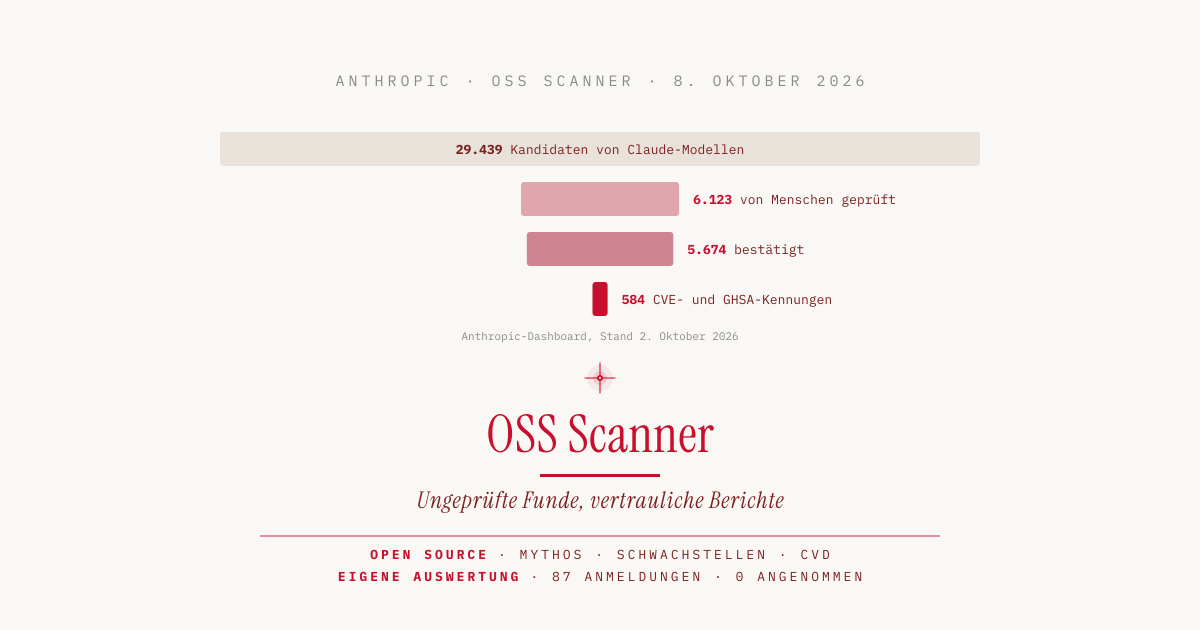
Anthropic lässt seine Modelle seit Monaten wichtige Open-Source-Projekte nach Schwachstellen durchsuchen, unter anderem im Rahmen von Project Glasswing, dem Programm, in dem ausgewählte Partner Zugang zu Mythos bekommen. Das öffentliche Dashboard mit Stand vom 2. Oktober 2026 zeigt die Größenordnung für den Zeitraum seit November 2025.
| Kennzahl (Anthropic) | Wert |
|---|---|
| Kandidaten für Schwachstellen | 29.439 |
| davon von sechs externen Sicherheitsfirmen geprüft | 6.123 |
| davon bestätigt | 5.674 (92,7 %) |
| an Maintainer gemeldet | 6.157 in 591 Projekten |
| vergebene Kennungen | 219 CVEs und 365 GHSAs |
| eingespielte Patches | 516 |
Eine CVE ist eine öffentliche, weltweit eindeutige Kennung für eine Schwachstelle, eine GHSA die entsprechende Kennung in der Advisory-Datenbank von GitHub. Die gemeldeten 6.157 Funde setzen sich laut Dashboard aus 1.333 Meldungen nach Prüfung durch die Firmen und 4.824 direkt von Anthropic verschickten Meldungen zusammen. Eine unabhängige Auswertung dieser Zahlen ist mir nicht bekannt.
Den Stau zeigen sie trotzdem. Von knapp 30.000 Kandidaten hat ein Mensch gut ein Fünftel angesehen. Das Dashboard nennt die unabhängige menschliche Prüfung ausdrücklich den begrenzenden Schritt.
Einen Ausweg haben Maintainer selbst gezeigt. Viele baten nach den ersten geprüften Berichten darum, gleich alles zu bekommen, auch Ungeprüftes mit Patch-Vorschlägen. Fast 5.000 solcher Berichte hat Anthropic laut Ankündigung auf diesem Weg verschickt. OSS Scanner macht daraus ein reguläres Angebot.
Ein Pull Request als Anmeldung
Die Anmeldung läuft über einen Pull Request im Repository anthropics/oss-scanner. Ein Projekt legt dort ein Verzeichnis mit einer project.yaml an, die Repository und Kontaktadresse nennt, dazu ein Dockerfile, das alle Abhängigkeiten installiert und das Projekt baut.
repo: https://github.com/example/project
primary_contact: security@example.org
dockerfile: .oss-scanner/Dockerfile
threat_model: .oss-scanner/threat_model.md
Laut README baut Anthropic das Projekt in einer isolierten virtuellen Maschine mit Netzzugang und verschiebt sie danach in ein Netz ohne Internet. Erst dort beginnt der Scan. Die Ergebnisse kommen per E-Mail, auf Wunsch mit PGP verschlüsselt. Ein Bericht enthält einen eigenständigen Reproduzierer, also ein Programm oder eine Eingabe, die den Fehler auslöst, dazu eine Erklärung der Lücke, wo möglich eine Bisektion, also die Suche nach dem Commit, der den Fehler eingeführt hat, und wenn vorhanden einen Patch-Vorschlag.
Das optionale Bedrohungsmodell in threat_model.md empfiehlt das README ausdrücklich. Darin beschreibt ein Projekt, wo nicht vertrauenswürdige Eingaben ankommen, was außerhalb des Rahmens liegt und wie es Schweregrade einstuft, etwa ob eine SQL-Injection nach der Anmeldung als hoch oder kritisch gilt. Ohne diese Datei arbeitet der Scanner mit eigenen Annahmen. Laut Ankündigung haben einige Maintainer Anthropic zurückgemeldet, dass der Scanner Schweregrade überschätzt oder das Bedrohungsmodell eines Projekts missversteht.
Trefferquote laut Anthropic, Urteil der Maintainer
Anthropic hat eine frühe Version an Dutzenden Projekten erprobt. Laut Ankündigung prüften die Penetrationstester, die auch Anthropics reguläre Funde begutachten, 97 als kritisch oder hoch eingestufte Funde aus 48 Projekten. 85 davon (88 %) erfüllten die Anforderungen des regulären Meldeprozesses. Von den übrigen zwölf waren elf echt, aber Duplikate bekannter Fehler, und nur einer war ein Fehlalarm.
Die Ankündigung zitiert zudem Stimmen von PostgreSQL, der OpenSSL Corporation, wolfSSL und HotCRP. Laut wolfSSL waren von 74 Berichten alle bis auf zwei gültig, fünf wurden zu CVEs. Anton Arapov von der OpenSSL Corporation schreibt, die Berichte seien so gut wie die von Menschen, manchmal besser. Diese Zitate hat Anthropic ausgewählt, ein Querschnitt sind sie nicht.
Den Kontrast liefert ein anderes Projekt. Im Januar 2026 hat curl sein Bug-Bounty-Programm eingestellt, weil KI-generierte Berichte das kleine Sicherheitsteam überrollten. Nach Angaben von Maintainer Daniel Stenberg waren 2025 nur rund fünf Prozent der Meldungen echte Schwachstellen. Die beiden Befunde stammen aus verschiedenen Projekten, mit verschiedenen Modellen und verschiedenen Absendern. Sie legen aber nahe, dass sich die Qualität modellgenerierter Berichte zumindest bei gezielten Scans deutlich verbessert hat.
Anmeldungen: 87 Pull Requests, keine angenommen
Der Dienst richtet sich nach den Kriterien von Google OSS-Fuzz, einem Dauertest, der Software mit zufälligen Eingaben auf Abstürze prüft, an etablierte Projekte mit „kritischer Bedeutung für Infrastruktur und Nutzersicherheit“. Wie viele Projekte sich trotzdem anmelden, zeigt das Anmelde-Repository. Ich habe am 9. Oktober um 9 Uhr über die GitHub-API nachgezählt, gut 13 Stunden nachdem das Repository angelegt wurde.
| Stand der Anmeldungen (eigene Auswertung) | Anzahl |
|---|---|
| Pull Requests insgesamt | 87 |
| offen | 76 |
| geschlossen | 11 |
| angenommen | 0 |
Unter den offenen Anmeldungen finden sich bekannte Namen wie NestJS und das ABP Framework, aber auch MCP-Server für 3D-Drucker, Hobbyprojekte und die statische Webseite eines Cafés. Alle elf geschlossenen Anmeldungen bekamen dieselbe Rückfrage, wie verbreitet das Projekt sei. Bei einer Anmeldung stellte das automatische Prüfskript des Repositorys fest, dass die Commits nicht von der Person stammten, die den Pull Request geöffnet hatte, sondern von Claude. Ein Einzelfall, aber ein bezeichnender.
Gründe für die enge Auswahl nennt Anthropic nicht. Naheliegend sind die Rechenkosten, denn Anthropic übernimmt sie vollständig, das ist aber meine Vermutung. Die Folge ist, dass die vielen kleinen Projekte, aus denen große Software zusammengesetzt ist, vorerst außen vor bleiben.
Vertrauliche Berichte, fehlende Advisories
Laut README gilt für die ungeprüften Berichte keine Offenlegungsfrist, und Anthropic veröffentlicht sie nicht. Erst wenn ein Fund später im regulären Prozess von einem Menschen bestätigt wird, kann er 90 Tage nach dieser Bestätigung öffentlich werden. Die Nutzungsbedingungen verpflichten Teilnehmer, die Berichte vertraulich zu behandeln, bis die Lücke behoben ist.
Für alle, die diese Software einsetzen, kann daraus eine Lücke werden. Werkzeuge für Software Composition Analysis, die Abhängigkeiten auf bekannte Schwachstellen prüfen, gleichen Versionen mit CVE- und GHSA-Datenbanken ab. Behebt ein Projekt einen Fund ohne Advisory, also ohne öffentliche Sicherheitsmeldung, schlagen diese Werkzeuge nicht an. Niemand erfährt dann, dass ein Update dringend wäre.
Auf dieses Problem weist eine Analyse von Rajesh Beri hin. Die bisherigen Zahlen lassen die Größe der Lücke ahnen, belegen sie aber nicht. Auf 6.157 gemeldete Funde kommen 584 Kennungen und 516 Patches. Wie viele Funde still behoben wurden, wie viele noch offen sind und wie viele sich als Duplikat erledigt haben, geht aus dem Dashboard nicht hervor.
OSS-Fuzz, auf das sich Anthropic beruft, macht es anders. Dort werden Funde nach 90 Tagen öffentlich oder sobald ein Fix veröffentlicht ist, je nachdem, was zuerst eintritt. Anthropic behält sich laut FAQ vor, für hochkritische Funde künftig ebenfalls eine Frist einzuführen.
Die Haftung ist laut Nutzungsbedingungen auf 1.000 Dollar begrenzt, und die Berichte kommen ausdrücklich ohne Gewähr. Ob eingereichter Code in das Training von Modellen einfließt, dazu habe ich in FAQ und Nutzungsbedingungen nichts gefunden (Stand 9. Oktober).
f451 im Selbstversuch
Wie viel Arbeit eine Anmeldung macht und was ein Modell mit Bedrohungsmodell findet, habe ich an meinem eigenen Projekt f451 ausprobiert. Eine echte Anmeldung hätte keine Chance gehabt, das Wiki ist erst seit Ende September öffentlich. Die Werkzeuge im Repository lassen sich aber auch ohne Anmeldung nutzen.
Für f451 brauchte es drei Dateien. Die project.yaml nennt Repository und Kontakt. Das Dockerfile installiert die Abhängigkeiten des pnpm-Monorepos, prüft die Typen, baut API, MCP-Dienst und Weboberfläche und lässt die Markdown-Tests laufen, die ohne Container auskommen. Das Bedrohungsmodell beschreibt, wo bei f451 fremde Eingaben ankommen, nämlich in Markdown-Seiten, Uploads, der HTTP-API und beim MCP-Dienst, und wie Befunde einzustufen sind.
tools/validate.py akzeptierte die Anmeldung. tools/check baute f451 anschließend so, wie es der Scanner tut. Erst entsteht das Image mit Netzzugang, dann legt das Werkzeug die Schicht des Scanners darüber und startet das Ergebnis ohne Netz. Der f451-Teil dauerte gut zwei Minuten, der ganze Lauf knapp drei. Aufschlussreich ist die Schicht des Scanners. Sie installiert Claude Code samt Compilern und Debuggern in das Image. Das legt nahe, dass der Scanner als Agent im gebauten Projekt arbeitet. Ein praktisches Detail am Rande ist, dass tools/check Docker voraussetzt. Mit Podman brauchte es eine kleine Weiterleitung.
Den Scanner selbst betreibt nur Anthropic. Als Annäherung habe ich Claude Code mit Opus 5.5 und demselben Bedrohungsmodell auf einen frischen Klon von f451 angesetzt. Das ist weder Mythos noch Anthropics Scan-Pipeline, aber dieselbe Art Werkzeug mit denselben Vorgaben. Nach 55 Schritten und knapp zehn Minuten lag ein Bericht vor. Der Lauf hat 4,43 Dollar gekostet.
| Ergebnis des Scans (eigener Test) | Anzahl |
|---|---|
| Schweregrad hoch | 4 |
| mittel | 1 |
| niedrig | 1 |
| unbestätigt | 1 |
Die vier schweren Befunde waren eine HTML-Injection, weil die Weboberfläche bereits bereinigtes HTML mit einem regulären Ausdruck zerlegte, eine Umgehung der Rechteprüfung über prozentkodierte Pfade bei direkt erreichbarer API, eine Volltextsuche, die über Präfixabfragen Inhalte oberhalb der Vertraulichkeitsgrenze eines Tokens verriet, und eine Prüfung, die Entwürfe gegen die Vertraulichkeitsstufe der veröffentlichten Fassung statt gegen ihre eigene bewertete. Die ersten beiden habe ich selbst nachgestellt. Zwei der vier betrafen ausgerechnet die Vertraulichkeitsstufen aus Version 1.1, eine Funktion, die keine zwei Wochen alt war.
Alle vier sind in f451 1.2.13 behoben. Damit stand ich vor genau der Frage, die dieser Artikel stellt, und habe zwei Advisories in der Datenbank von GitHub veröffentlicht. GHSA-c436-86vv-rgwc fasst die drei Befunde rund um API-Tokens mit Schweregrad hoch zusammen, GHSA-4rm8-qwpg-m3r8 beschreibt die HTML-Injection. Sie ist dort als mittel eingestuft, weil die Content Security Policy der Weboberfläche das Ausführen eingeschleuster Skripte verhindert. Wer f451 betreibt, erfährt so über die üblichen Werkzeuge, dass ein Update nötig ist.
Eine Lehre betraf das Werkzeug selbst. Ich hatte den Agenten mit --allowedTools auf Lesewerkzeuge beschränken wollen. Die Option ergänzt aber nur die vorhandenen Freigaben, sie schränkt nichts ein. Weil meine Einstellungen Bash erlauben, hat der Agent zwei Befunde außerhalb des Repositorys mit einem eigenen Skript nachgestellt. Das war hilfreich, aber nicht vorgesehen. Wer einen Scan wirklich auf Lesen begrenzen will, schließt Bash zusätzlich mit --disallowedTools aus.
Gewinn für Maintainer, Lücke für Nutzer
Für ein großes, gut besetztes Projekt spricht viel für die Teilnahme. Es bekommt kostenlos Funde mit Reproduzierer und Patch-Vorschlag, und zwar früher als über den Umweg menschlicher Prüfer. Laut Anthropic bauen Angreifer Exploits für bekannte Lücken inzwischen in Minuten, da zählt jeder Tag Vorsprung. Wer mitmacht, sollte das Bedrohungsmodell schreiben. Laut README ist es der Weg, die Einstufung der Schweregrade zu steuern, und es zwingt ein Projekt, die eigene Angriffsfläche einmal aufzuschreiben.
Für alle, die diese Projekte nur nutzen, verschiebt sich etwas. Ein Teil der Sicherheitsarbeit an zentraler Open-Source-Software läuft künftig zwischen einem KI-Anbieter und den Maintainern ab, ohne öffentliche Spur. Ob ein Fix eine Kennung bekommt, entscheidet jedes Projekt selbst. Wer Anthropic im Commit nennen will, verwendet laut FAQ eine Berichtskennung im Format ANT-2026-…. Die Suche danach in Commit-Logs ist ein Notbehelf, denn die Nennung ist freiwillig.
Der Scanner findet die Lücke. Ob die Öffentlichkeit davon erfährt, entscheidet er nicht.
Quellen
- Anthropic, Launching an opt-in vulnerability-finding service for open-source software (8. Oktober 2026): anthropic.com
- OSS Scanner, FAQ: red.anthropic.com/oss-scanner
- OSS Scanner, Nutzungsbedingungen: red.anthropic.com/oss-scanner/terms
- Repository und README: github.com/anthropics/oss-scanner
- Anthropic, CVD-Dashboard, Stand 2. Oktober 2026: red.anthropic.com/2026/cvd
- OSS-Fuzz, Bug Disclosure Guidelines: google.github.io/oss-fuzz
- The Register, Curl shutters bug bounty program (21. Januar 2026): theregister.com
- Rajesh Beri, Anthropic’s OSS Scanner Skips Human Review and the Public Advisory (8. Oktober 2026): beri.net
- f451, Advisories zu 1.2.13: GHSA-c436-86vv-rgwc, GHSA-4rm8-qwpg-m3r8
- Eigene Auswertung der Pull Requests im Repository
anthropics/oss-scannerüber die GitHub-API, 9. Oktober 2026 - Eigener Test:
tools/validate.pyundtools/checkausanthropics/oss-scannermit f451 (main, Commitc9e5ce2), Scan mit Claude Code und Opus 5.5, Podman 6.0.2 auf macOS 27.2, MacBook Pro M3 Max, 9. Oktober 2026