AWS Cloud Practitioner 03: Compute
Rechenleistung gibt es bei AWS in vielen Formen. Es gibt sie als virtuelle Maschine, die wir nach Laufzeit mieten, als Container ohne eigenen Server oder als Funktion, die nur läuft, wenn ein Ereignis eintrifft. Die Prüfung fragt selten nach Konfigurationsdetails, aber sehr oft danach, welcher Dienst und welche Kaufoption zu einem beschriebenen Szenario passt. Diese Zuordnung bauen wir in diesem Teil auf, und am Ende legen wir eine Lambda-Funktion im eigenen Account an und messen ihren Kaltstart.
EC2 als Baukasten für virtuelle Server
Amazon EC2 (Elastic Compute Cloud) ist der klassische Weg, in AWS Rechenleistung zu bekommen. Eine Instanz setzt sich aus wenigen Bausteinen zusammen. Das AMI (Amazon Machine Image) liefert Betriebssystem und vorinstallierte Software, der Instanztyp bestimmt CPU und Arbeitsspeicher, dazu kommen Storage, eine Security Group als Firewall und optional User Data. User Data ist ein Bootskript, das beim ersten Start der Instanz einmal mit Root-Rechten läuft, etwa um Pakete zu installieren.
AMIs gibt es aus mehreren Quellen. AWS stellt öffentliche AMIs bereit, eigene erzeugen wir aus einer konfigurierten Instanz (Teil 04), und im AWS Marketplace bieten Drittanbieter vorkonfigurierte AMIs an, teils mit kostenpflichtiger Software.
Instanztypen folgen einem festen Namensschema. In m5.2xlarge steht m für die Klasse, 5 für die Generation und 2xlarge für die Größe innerhalb der Klasse. Für die Prüfung genügt es, die Familien ihrem Einsatzzweck zuzuordnen.
| Familie | typischer Einsatz |
|---|---|
| General Purpose | ausgewogene Last, Webserver, Code-Repositories, kleine bis mittlere Datenbanken |
| Compute Optimized | Batch-Verarbeitung, Medien-Transcoding, HPC, dedizierte Game-Server |
| Memory Optimized | In-Memory-Datenbanken, Analyse großer Datenmengen im RAM |
| Storage Optimized | hoher lokaler I/O, Datenbanken mit hohem Durchsatz, Datenverarbeitung |
Dazu kommt Accelerated Computing mit GPUs oder anderen Beschleunigern, etwa für Grafik und Machine Learning.
Die Security Group kennt nur Allow-Regeln und ist stateful. Eine erlaubte eingehende Verbindung darf also automatisch antworten, ohne dass wir dafür eine ausgehende Regel brauchen. Im Ausgangszustand ist eingehender Verkehr gesperrt und ausgehender offen. Daraus ergibt sich eine beliebte Diagnosefrage. Läuft ein Verbindungsversuch in einen Timeout, blockiert meist die Security Group. Kommt dagegen connection refused, ist das Paket angekommen, aber auf dem Port lauscht keine Anwendung.
Einige Ports sollten wir auswendig kennen: 22 für SSH und SFTP, 21 für FTP, 80 für HTTP, 443 für HTTPS und 3389 für RDP (Windows-Remotedesktop). EC2 Instance Connect öffnet eine SSH-Sitzung direkt im Browser, braucht dafür aber ebenfalls Port 22 in der Security Group.
Bei EC2 bleibt laut Shared Responsibility Model viel Arbeit bei uns. Wir pflegen das Gastbetriebssystem samt Sicherheitspatches, die installierte Software, die Regeln der Security Group, die Berechtigungen über IAM und unsere Daten. AWS verantwortet Hardware, Netz und Rechenzentren, also auch den Austausch defekter Server.
Wer eine Datenbank auf EC2 selbst betreibt, übernimmt Patches, Backups und Hochverfügbarkeit selbst. Der Exam Guide verlangt, diese Variante gegen eine managed Datenbank abwägen zu können (Task 3.4). Die Verschiebung der Verantwortung kennen wir aus dem Shared-Responsibility-Modell in Teil 01, die managed Datenbanken folgen in Teil 05.
Kaufoptionen: Rabatt gegen Bindung
Dieselbe Instanz kann sehr unterschiedlich viel kosten, je nachdem, wie wir sie kaufen. Der Exam Guide nennt in Task 4.1 sieben Kaufoptionen. Je mehr wir uns binden oder je mehr Unsicherheit wir akzeptieren, desto größer der Rabatt gegenüber On-Demand.
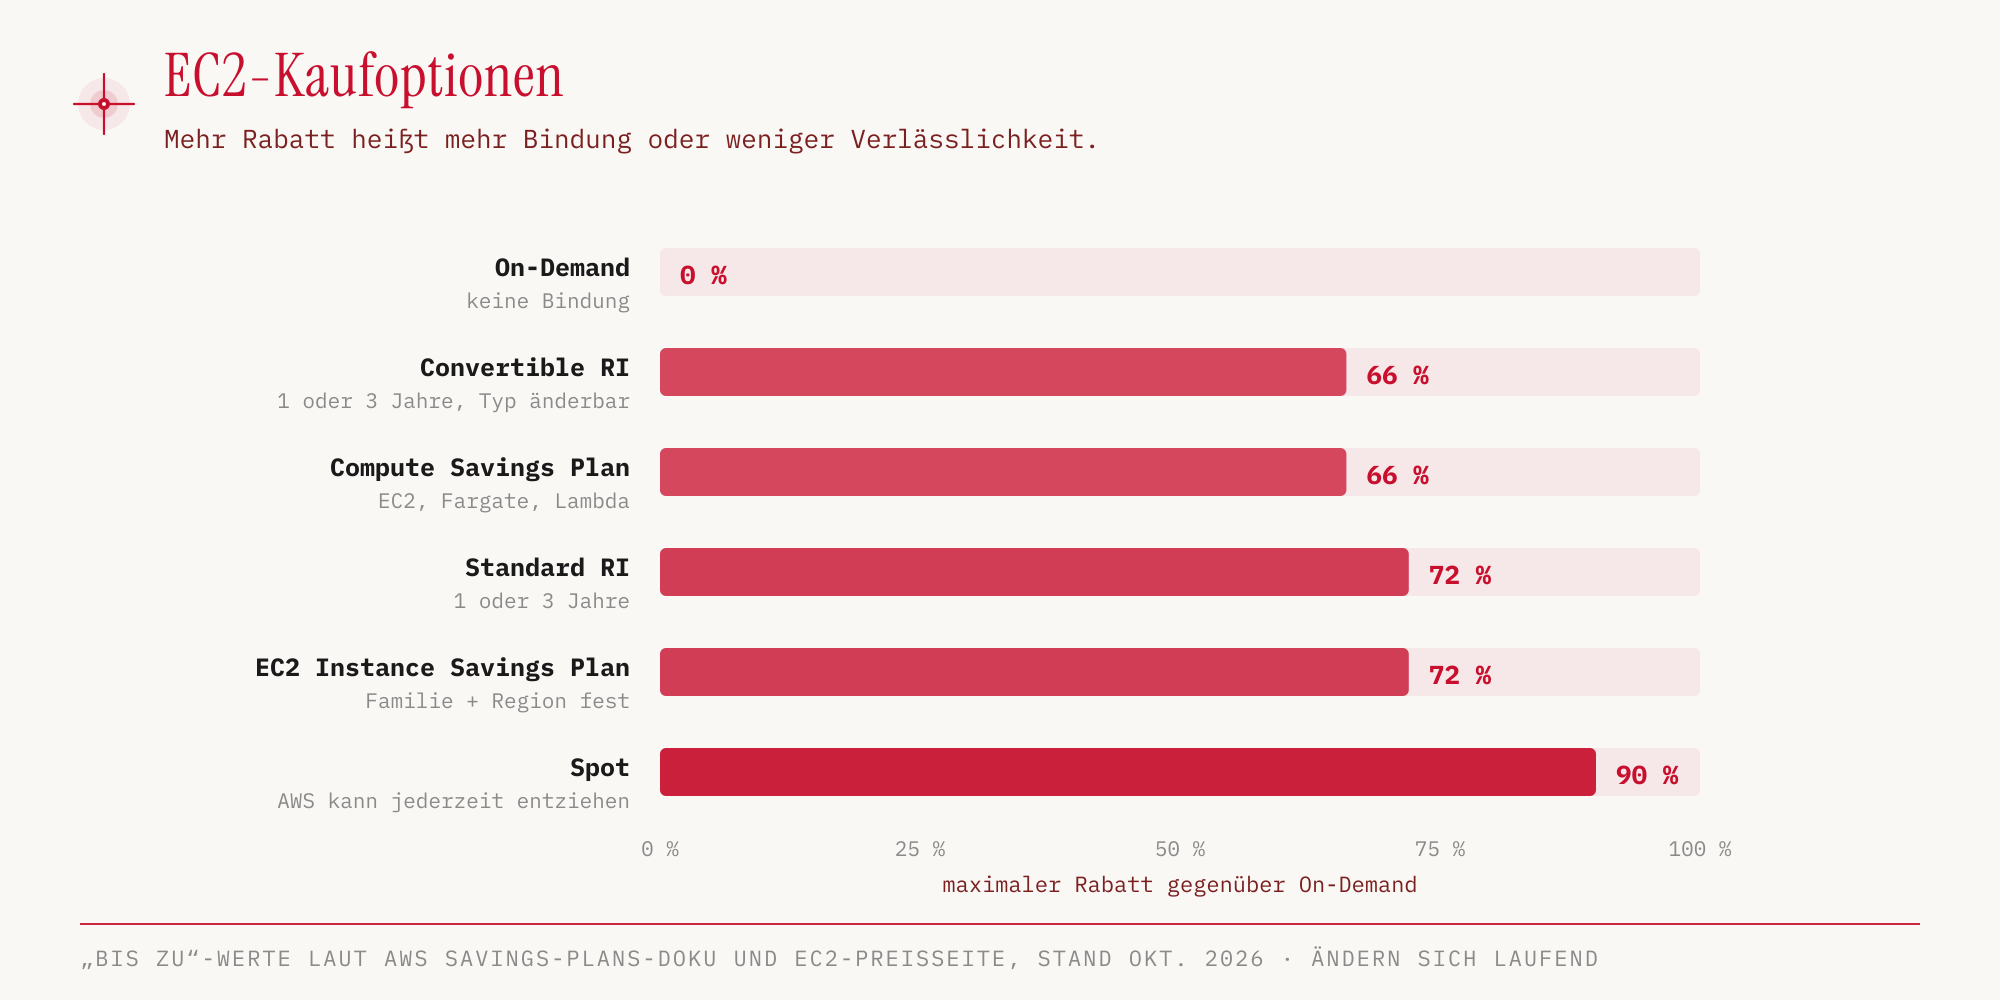
Die Höchstwerte stammen aus der Savings-Plans-Doku und der EC2-Preisseite (Stand 2026-10-25). Sie sind Momentaufnahmen, die AWS jederzeit ändern kann, und die Prüfung fragt nicht nach den Prozenten, sondern nach der Reihenfolge und dem passenden Szenario.
| Option | Wann sie passt |
|---|---|
| On-Demand | kurze, unvorhersehbare Last; Linux und Windows werden sekundengenau abgerechnet, mindestens 60 Sekunden |
| Reserved Instances | Dauerlast über 1 oder 3 Jahre, etwa eine Datenbank; Zahlung No, Partial oder All Upfront; Standard RIs lassen sich auf dem RI Marketplace weiterverkaufen, Convertible RIs nicht |
| Savings Plans | Dauerlast mit Zusage auf einen Stundenbetrag statt auf eine Instanz; Compute Savings Plans gelten auch für Fargate und Lambda |
| Spot Instances | fehlertolerante Arbeit wie Batch, Analyse, Bildverarbeitung; AWS kann die Instanz jederzeit zurückholen, daher nie für kritische Jobs oder Datenbanken |
| Dedicated Host | ein ganzer physischer Server für uns, mit Sicht auf Sockel und Kerne; für Lizenzen, die an Sockel oder Kerne gebunden sind (BYOL), und Compliance |
| Dedicated Instance | Hardware, die wir mit keinem anderen AWS-Kunden teilen, aber ohne Kontrolle über die Platzierung auf dem Host |
| Capacity Reservation | garantierte Kapazität in einer bestimmten AZ; kostet den On-Demand-Preis, auch wenn wir sie nicht nutzen, ohne Laufzeitbindung |
Laut Exam Guide sind Reserved Instances in gewissem Rahmen flexibel und werden in AWS Organizations über die konsolidierte Abrechnung zwischen Accounts geteilt (Task 4.1). Außerdem garantieren Savings Plans keine Kapazität. Wer beides braucht, kombiniert sie laut AWS-Doku mit einer On-Demand Capacity Reservation. Die Verwechslung von Rabatt und Kapazitätsgarantie ist eine typische Falle.
Wer bei Dedicated Hosts eigene Lizenzen mitbringt (BYOL), behält sie mit AWS License Manager im Blick. Der Dienst verwaltet Softwarelizenzen in AWS und im eigenen Rechenzentrum und verfolgt, wie viele davon in Gebrauch sind.
Elastic Load Balancing verteilt, Auto Scaling passt die Menge an
Eine einzelne Instanz ist ein Single Point of Failure. Sobald wir mehrere Instanzen über mehrere AZs verteilen, brauchen wir einen gemeinsamen Einstiegspunkt davor. Das ist die Aufgabe von Elastic Load Balancing (ELB). Ein Load Balancer verteilt die Anfragen, prüft per Health Check, welche Instanzen gesund sind, kann SSL/TLS terminieren und stellt einen einzigen DNS-Namen bereit, den Clients ansprechen.
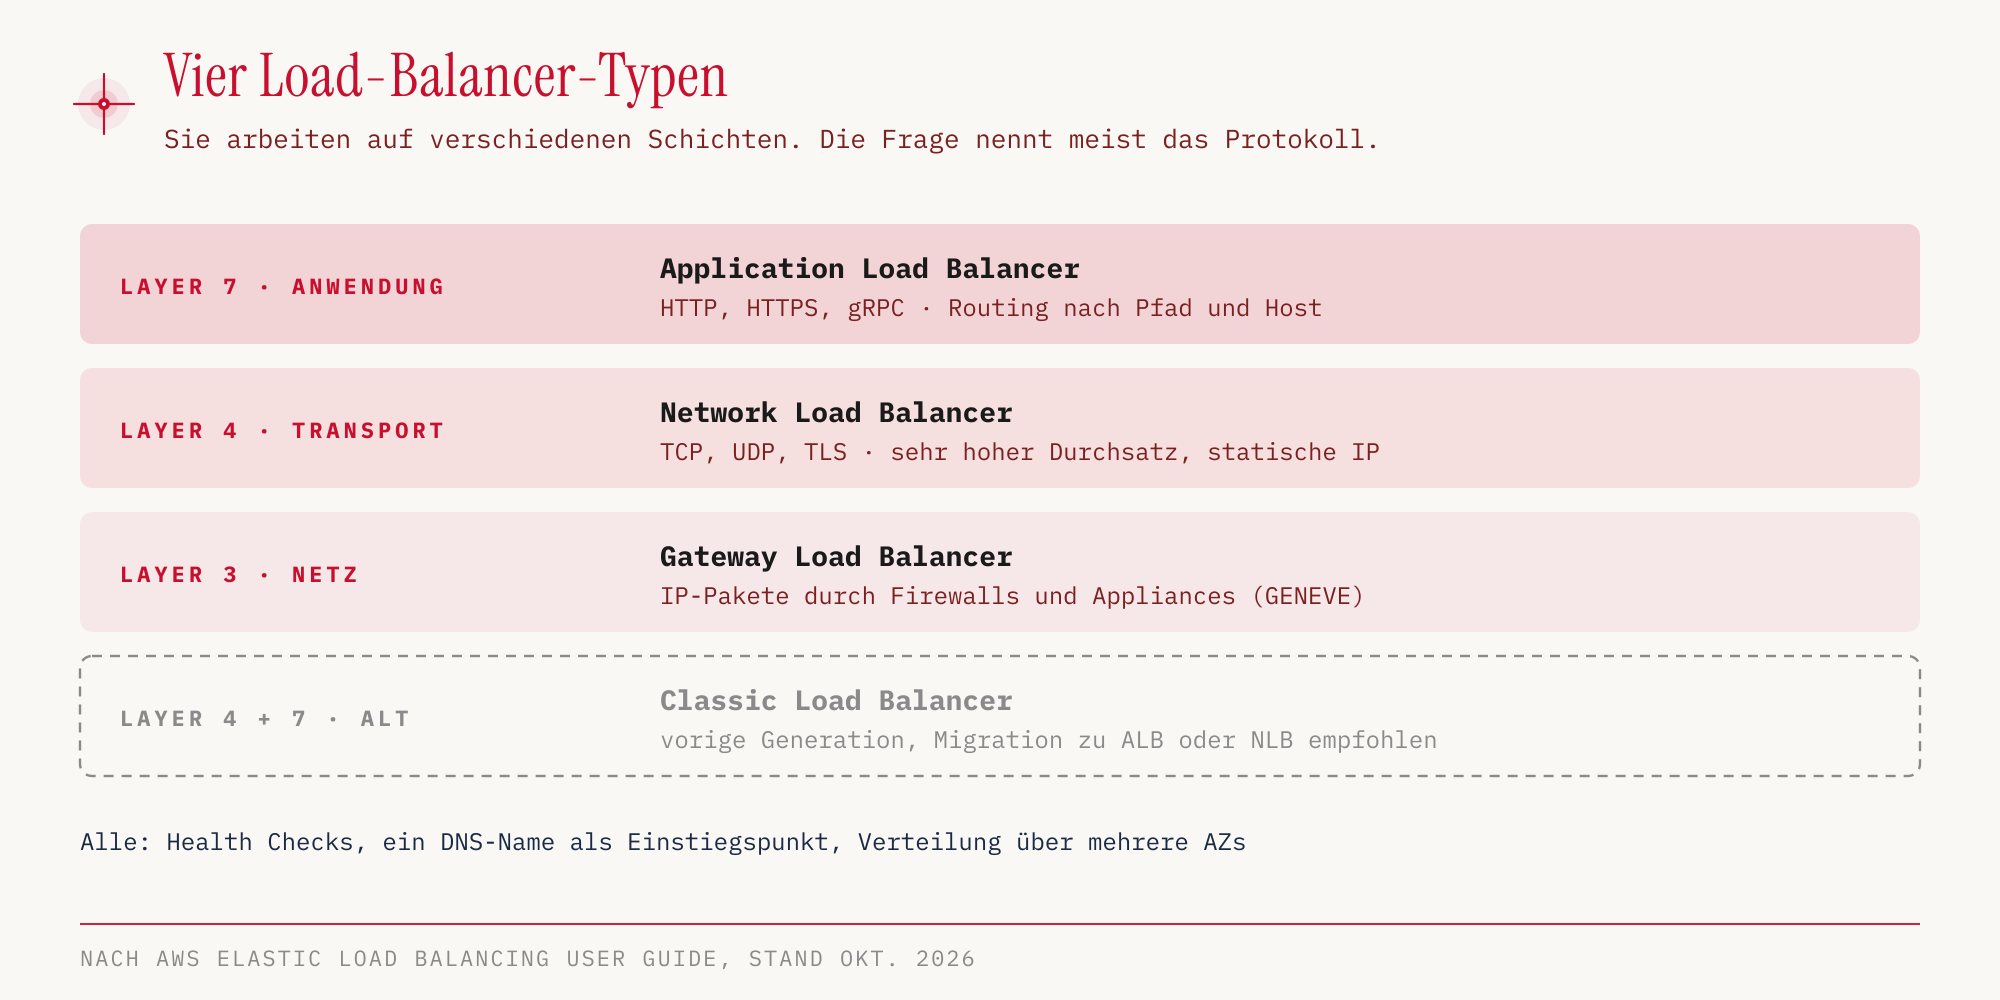
AWS bietet vier Typen an, die sich in der Netzwerkschicht unterscheiden, auf der sie entscheiden.
| Typ | Schicht | typisches Stichwort |
|---|---|---|
| Application Load Balancer (ALB) | Layer 7 | HTTP/HTTPS, Webanwendungen, Routing nach Pfad oder Host |
| Network Load Balancer (NLB) | Layer 4 | TCP/UDP, extreme Performance |
| Gateway Load Balancer (GWLB) | Layer 3 | Firewalls und andere virtuelle Appliances von Drittanbietern |
| Classic Load Balancer (CLB) | ältere Generation | Migration zu ALB oder NLB empfohlen |
Den Classic Load Balancer gibt es weiterhin. Am 15. August 2022 endete nur EC2-Classic, die alte Netzwerkplattform, und mit ihr die CLBs, die darin liefen. CLBs in einer VPC existieren weiter, AWS empfiehlt aber die Migration zu ALB oder NLB.
Erreichbar sind alle Typen über ihren DNS-Namen, eine eigene Domain hängen wir per Route-53-Alias davor (Teil 06). Der Network Load Balancer hat zusätzlich pro AZ eine feste IP-Adresse, bei einem öffentlichen NLB auf Wunsch eine Elastic IP. Wir können ihn deshalb auch direkt per IP ansprechen, etwa wenn die Firewall eines Kunden nur freigegebene Adressen durchlässt. Die IPs eines Application Load Balancer wechseln dagegen, ihn sprechen wir immer über den DNS-Namen an.
Beim Routing ist es umgekehrt. Der ALB liest auf Layer 7 Host und Pfad einer Anfrage und kann shop.example.com und api.example.com an verschiedene Zielgruppen schicken. Der NLB sieht auf Layer 4 nur IP-Adresse, Port und Protokoll. Seine Listener können laut Doku Verkehr gewichtet auf mehrere Zielgruppen verteilen, und bei einem Dual-Stack-NLB können Regeln IPv4 und IPv6 trennen. Nach Host oder Pfad routen kann er nicht. Auch bei einem TLS-Listener wählt er per SNI nur das passende Zertifikat, nach Domain verteilen kann er nicht.
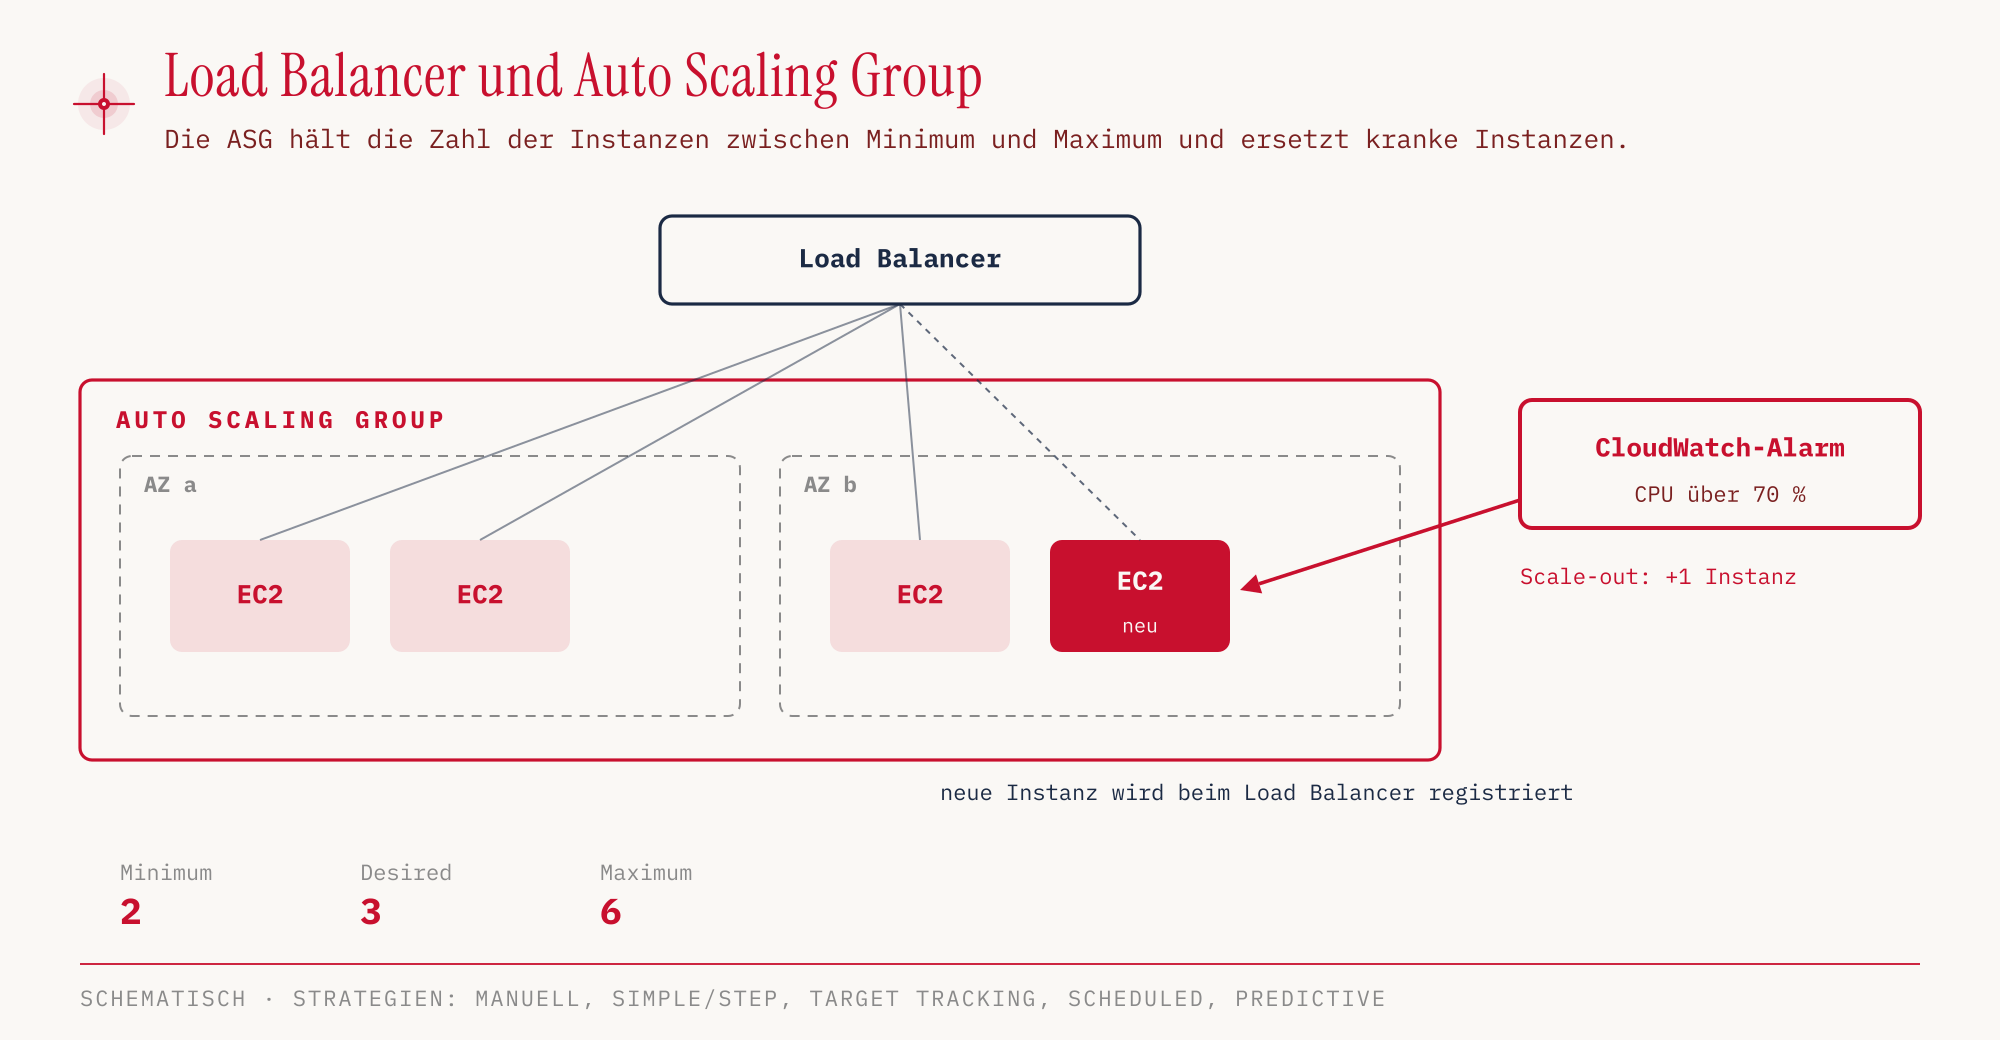
Der Load Balancer verteilt nur die Last auf vorhandene Instanzen. Wie viele es sind, entscheidet die Auto Scaling Group (ASG). Wir legen eine Mindestzahl, eine gewünschte Zahl und eine Höchstzahl fest. Die ASG ersetzt ungesunde Instanzen, startet bei Bedarf neue und registriert sie beim Load Balancer. Das ist die Elasticity aus Teil 01 in technischer Form.
| Skalierungsstrategie | Auslöser |
|---|---|
| Manual | wir ändern die gewünschte Anzahl von Hand |
| Simple / Step Scaling | ein CloudWatch-Alarm überschreitet eine Schwelle |
| Target Tracking | ein Zielwert wird gehalten, etwa CPU bei 40 % |
| Scheduled | bekannte Muster, etwa jeden Montag um 9 Uhr mehr Kapazität |
| Predictive | Prognose per Machine Learning aus der bisherigen Last |
Lambda rechnet nur, wenn etwas passiert
Bei EC2 bezahlen wir für eine Instanz, solange sie läuft, ob sie gerade arbeitet oder nicht. AWS Lambda dreht das um. Wir laden nur Code hoch, und AWS führt ihn aus, sobald ein Ereignis eintrifft. Server, Patches und Skalierung sind Sache von AWS. Das nennt man serverless, obwohl natürlich weiterhin Server laufen, nur eben nicht unsere.
Das typische Beispiel ist die Bildverarbeitung nach einem Upload.
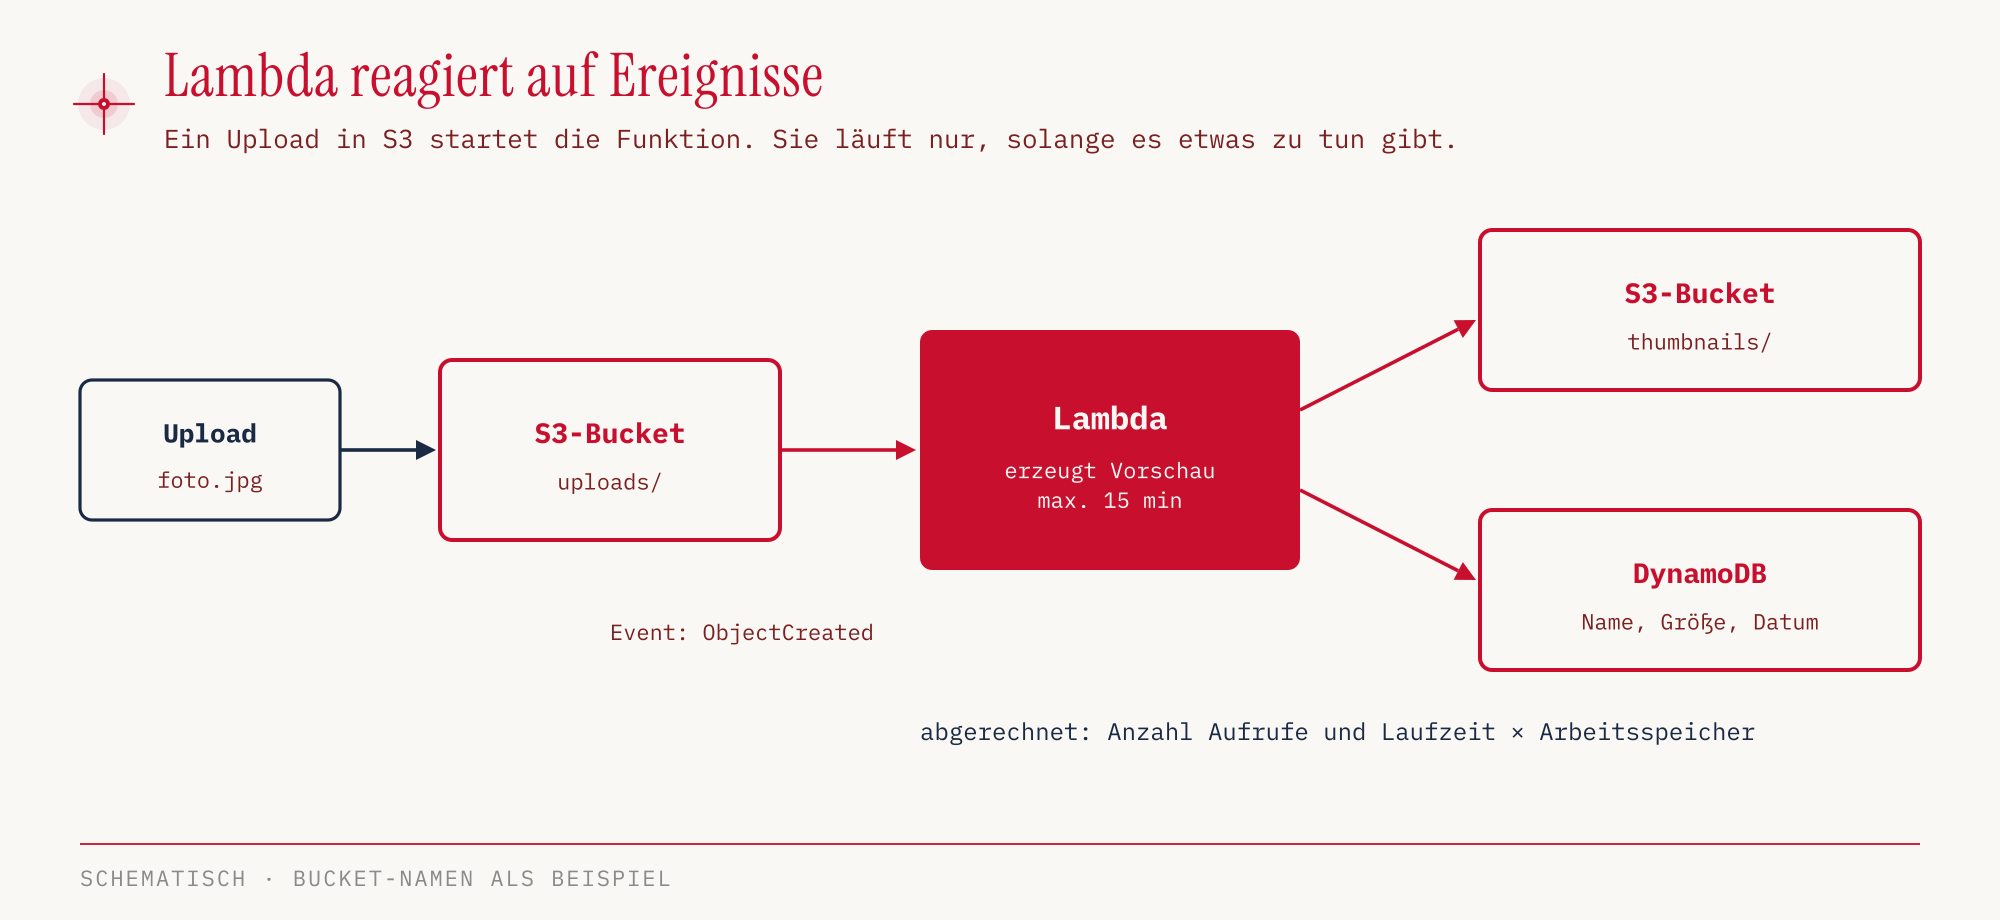
Lambda hat harte Grenzen. Eine Ausführung darf höchstens 15 Minuten dauern, der Arbeitsspeicher reicht bis 10.240 MB (Lambda-Quotas, Stand 2026-10-25). Abgerechnet wird pro Aufruf und nach Laufzeit mal zugewiesenem Speicher, gemessen in GB-Sekunden. 1 Million Aufrufe und 400.000 GB-Sekunden pro Monat sind laut AWS dauerhaft kostenlos, im Free Plan wie im Paid Plan. Die CPU-Leistung teilt Lambda proportional zum eingestellten Arbeitsspeicher zu, mehr Speicher bedeutet also auch mehr Rechenleistung (AWS Knowledge Center).
Wer eine API für eine Lambda-Funktion braucht, setzt Amazon API Gateway davor. Es stellt serverless REST-, HTTP- und WebSocket-APIs bereit und ist das übliche Eingangstor für Lambda-Backends. Für einen zeitgesteuerten Job, also einen Cron-Ersatz, löst dagegen Amazon EventBridge die Funktion nach Zeitplan aus.
Container mit ECS, Fargate und EKS
Zwischen der eigenen Instanz und der Funktion liegen Container. Ein Docker-Image bündelt Anwendung und Abhängigkeiten und läuft überall gleich. AWS bietet dafür mehrere Dienste mit ähnlichen Namen und klar getrennten Aufgaben.
| Service | Merksatz |
|---|---|
| Amazon ECS | Docker-Container orchestrieren, im EC2-Modus auf Instanzen, die wir selbst bereitstellen |
| AWS Fargate | Container serverless betreiben, keine EC2-Instanzen zu verwalten |
| Amazon EKS | managed Kubernetes, auf EC2 oder Fargate |
| Amazon ECR | private Registry für Docker-Images |
| AWS Batch | Batch-Jobs als Docker-Image, auf EC2, Spot oder Fargate, auch wenn sie länger laufen als Lambda erlaubt |
| Amazon Lightsail | einfache virtuelle Server und fertige Stacks zum planbaren Paketpreis, ohne automatisches Skalieren |
Die häufigste Verwechslung betrifft ECS und Fargate. ECS ist der Orchestrierer, Fargate ist eine Betriebsart, bei der AWS die darunterliegenden Server stellt. Kubernetes in der Frage führt fast immer zu EKS. Lightsail ist die Antwort, wenn jemand ohne Cloud-Erfahrung schnell einen einfachen Webserver mit planbaren Kosten will.
Hands-on
Wir legen eine kleine Python-Funktion an, rufen sie zweimal auf und lesen die Abrechnung aus den Logs. Die Funktion braucht eine IAM-Rolle, damit Lambda in CloudWatch Logs schreiben darf. Wie Rollen und temporäre Credentials funktionieren, steht in Teil 02. Wir nutzen die CLI, weil sich Befehle anders als Klicks in der Konsole wiederholen lassen. Der Exam Guide fragt diese Unterscheidung zwischen einmaliger Operation und wiederholbarem Prozess ab (Task 3.1).
Der Code in index.py:
def handler(event, context):
    name = event.get('name', 'Welt')
    print('Aufruf fuer', name)
    return {'message': f'Hallo {name}', 'memory_mb': context.memory_limit_in_mb, 'remaining_ms': context.get_remaining_time_in_millis()}
memory_mb kommt als String zurück, remaining_ms ist die Restlaufzeit bis zum Timeout in Millisekunden.
Die Vertrauensrichtlinie trust.json erlaubt dem Lambda-Dienst, die Rolle anzunehmen.
{
  "Version": "2012-10-17",
  "Statement": [{
    "Effect": "Allow",
    "Principal": { "Service": "lambda.amazonaws.com" },
    "Action": "sts:AssumeRole"
  }]
}
Rolle anlegen, Code packen, Funktion erzeugen:
aws iam create-role --role-name ccp-demo-lambda-role \
  --assume-role-policy-document file://trust.json
aws iam attach-role-policy --role-name ccp-demo-lambda-role \
  --policy-arn arn:aws:iam::aws:policy/service-role/AWSLambdaBasicExecutionRole

zip fn.zip index.py

# Der Rollen-ARN enthält die eigene Account-ID, deshalb lesen wir ihn aus
ROLE_ARN=$(aws iam get-role --role-name ccp-demo-lambda-role \
  --query Role.Arn --output text)

aws lambda create-function --function-name ccp-demo-hello \
  --runtime python3.13 --architectures arm64 \
  --memory-size 128 --timeout 10 \
  --handler index.handler \
  --role "$ROLE_ARN" \
  --zip-file fileb://fn.zip \
  --region eu-central-1
In der Konsole: Lambda → Event Functions → Create Event Function → Author from scratch → Function name, Runtime → Additional settings → ARM64 architecture → Create Event Function. Python 3.13 finden wir im Runtime-Dropdown unter „Other supported“. Die Ausführungsrolle legt die Konsole selbst an (ccp-demo-hello-role-… mit einer eigenen Policy AWSLambdaBasicExecutionRole-…), trust.json und die beiden iam-Befehle entfallen dort. Den Code tragen wir danach im Tab Code ein und klicken Deploy. Die Datei heißt in der Konsole lambda_function.py, der Handler lambda_function.lambda_handler, die Funktion im Code also lambda_handler statt handler.
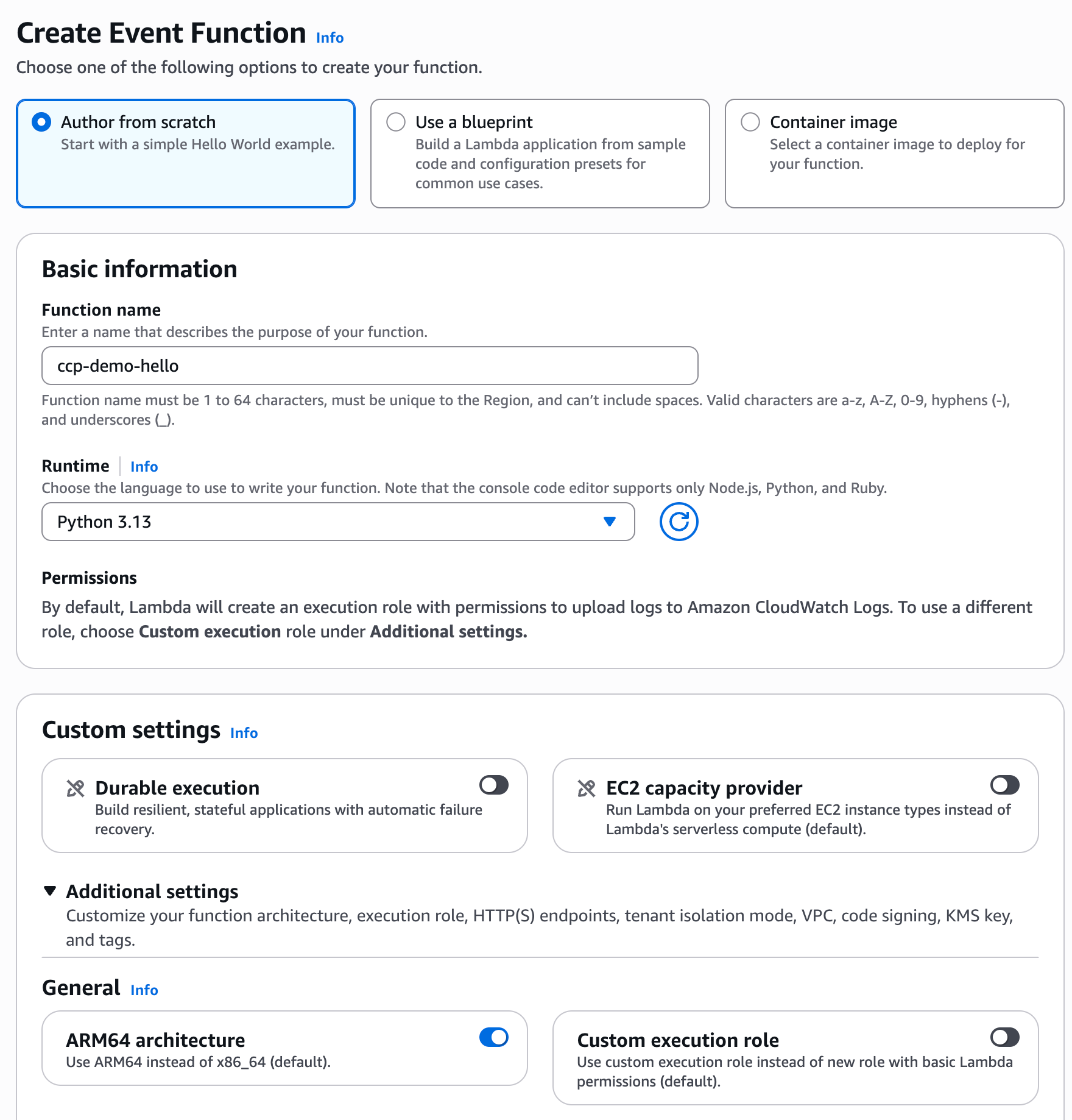
Jetzt rufen wir die Funktion auf:
aws lambda invoke --function-name ccp-demo-hello \
  --cli-binary-format raw-in-base64-out \
  --payload '{"name":"rotecodefraktion"}' \
  response.json --region eu-central-1
cat response.json
{
    "StatusCode": 200
}
{"message": "Hallo rotecodefraktion", "memory_mb": "128", "remaining_ms": 10000}
Die Ausgabe ist gekürzt, die CLI meldet zusätzlich die ausgeführte Version. Ein zweiter Aufruf mit {"name":"CLF-C02"} lieferte ebenfalls Status 200. Am Client gemessen dauerte der erste Aufruf 725 ms, der zweite 539 ms. Interessanter ist, was Lambda selbst protokolliert und abrechnet.
aws logs filter-log-events \
  --log-group-name /aws/lambda/ccp-demo-hello \
  --filter-pattern "?INIT_START ?REPORT" \
  --query 'events[].message' --output text --region eu-central-1
INIT_START Runtime Version: python:3.13.mainlinev2.v43 ...
REPORT ... Duration: 2.03 ms  Billed Duration: 68 ms  Memory Size: 128 MB  Max Memory Used: 35 MB  Init Duration: 65.38 ms
REPORT ... Duration: 1.62 ms  Billed Duration: 2 ms ...
Die Ausgabe ist gekürzt, Request-IDs und weitere Felder lassen wir weg.
In der Konsole: Tab Test → Create new event → Event name, Event JSON → Test. Unter „Executing function: succeeded“ und Details stehen Response, Duration, Billed duration, Init duration und die letzten 4 KB des Log output, der Link „logs“ führt zur CloudWatch-Log-Gruppe.
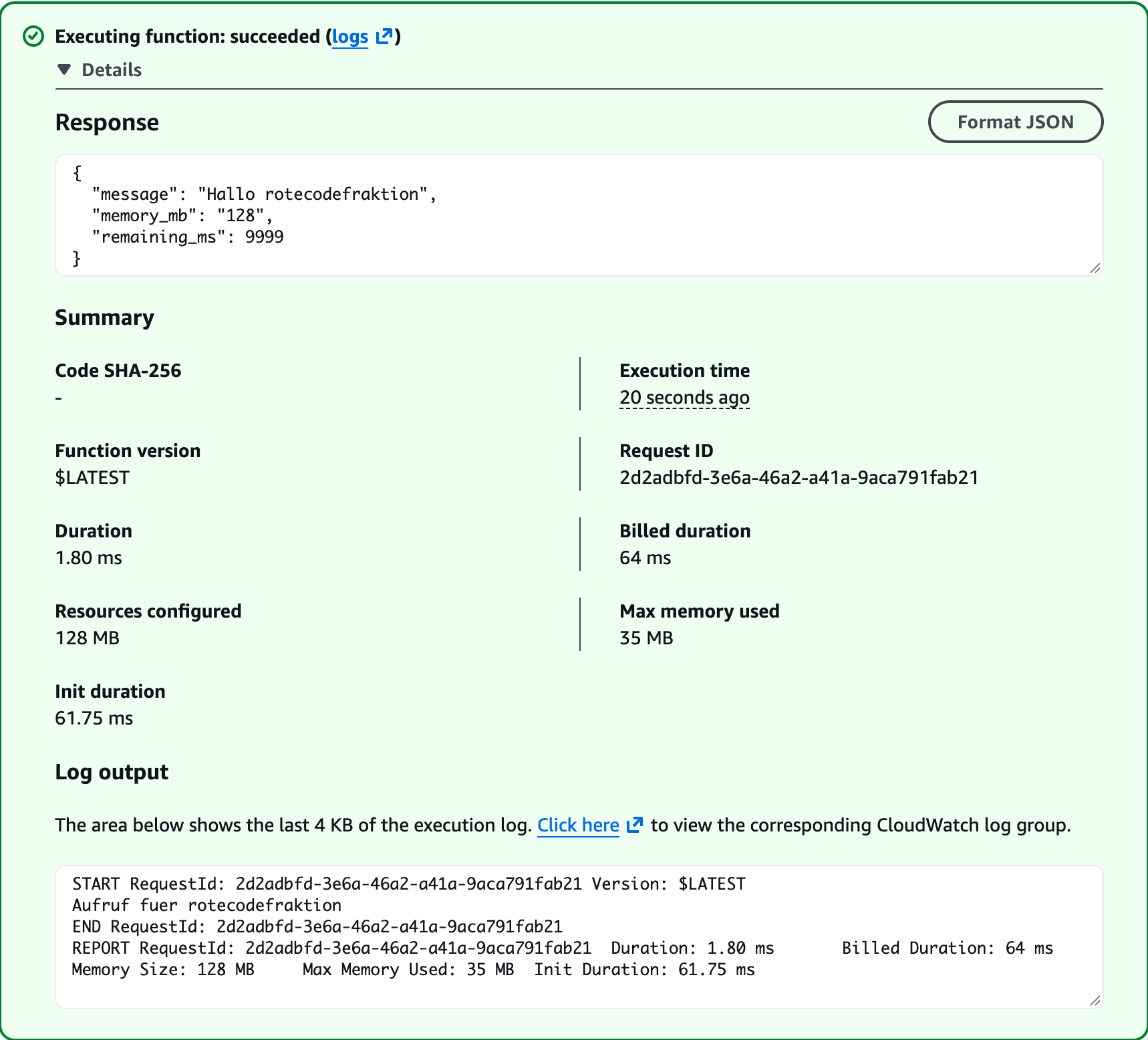
Der Screenshot stammt aus einem zweiten Lauf, ebenfalls mit Kaltstart, daher die leicht anderen Zeiten.
Der erste Aufruf war ein Kaltstart. Lambda musste zuerst eine Ausführungsumgebung hochfahren und die Python-Runtime laden, das zeigen die Zeile INIT_START und die Init Duration von 65,38 ms. Der eigentliche Code lief nur 2,03 ms. Abgerechnet wurden trotzdem 68 ms, also Init-Phase und Laufzeit zusammen.
Seit dem 1. August 2025 rechnet AWS die Init-Phase laut AWS Compute Blog auch bei ZIP-Funktionen mit verwalteten Runtimes ab.
Beim zweiten Aufruf war die Umgebung noch warm, es gab keine Init-Phase, und abgerechnet wurden 2 ms. Bei 128 MB fällt das im Free Tier nicht ins Gewicht. Bei Funktionen mit viel Speicher und vielen Kaltstarts wird die Init-Phase zum Posten auf der Rechnung.
Aufräumen, damit nichts liegen bleibt:
aws lambda delete-function --function-name ccp-demo-hello --region eu-central-1
aws logs delete-log-group --log-group-name /aws/lambda/ccp-demo-hello --region eu-central-1
aws iam detach-role-policy --role-name ccp-demo-lambda-role \
  --policy-arn arn:aws:iam::aws:policy/service-role/AWSLambdaBasicExecutionRole
aws iam delete-role --role-name ccp-demo-lambda-role
Wer die Funktion in der Konsole angelegt hat, löscht statt ccp-demo-lambda-role die automatisch erzeugte Rolle ccp-demo-hello-role-… und die dazugehörige Policy AWSLambdaBasicExecutionRole-… (IAM → Roles bzw. IAM → Policies).
Die Funktion bleibt bei diesem Umfang im kostenlosen Kontingent. Ressourcen, die wir länger stehen lassen oder öfter aufrufen, können nach Ablauf oder Überschreiten des Free Tier Kosten erzeugen.
Für die Prüfung
| Stichwort in der Frage | Antwort |
|---|---|
| kurzfristige, unvorhersehbare Last, keine Bindung | On-Demand |
| Dauerlast über 1 oder 3 Jahre, Instanztyp fest | Standard Reserved Instance oder EC2 Instance Savings Plan |
| Rabatt, der auch Fargate und Lambda abdeckt | Compute Savings Plan |
| fehlertolerant, darf unterbrochen werden, maximal günstig | Spot Instances |
| Lizenz pro Sockel oder Kern, Compliance verlangt eigenen Server | Dedicated Host |
| Hardware mit keinem anderen Kunden teilen, ohne Sicht auf Sockel und Kerne | Dedicated Instance |
| mitgebrachte Lizenzen (BYOL) verwalten und ihre Nutzung verfolgen | AWS License Manager |
| vorkonfiguriertes Image eines Drittanbieters | AMI aus dem AWS Marketplace |
| Wer pflegt Gast-OS-Patches und Security-Group-Regeln einer EC2-Instanz? | der Kunde |
| Wer tauscht defekte Server-Hardware unter EC2 aus? | AWS |
| Kapazität in einer AZ garantiert, ohne Laufzeitbindung | Capacity Reservation |
| Routing nach Pfad oder Host (Domain), HTTP/HTTPS | Application Load Balancer |
| feste IP-Adresse, z. B. für die Firewall-Freigabe beim Kunden | Network Load Balancer (oder Global Accelerator vor einem ALB) |
| TCP/UDP, extreme Performance | Network Load Balancer |
| Firewall-Appliances von Drittanbietern einbinden | Gateway Load Balancer |
| Instanzzahl automatisch an Last anpassen | Auto Scaling Group |
| Code ohne Server, ereignisgesteuert, unter 15 Minuten | AWS Lambda |
| serverlose REST- oder WebSocket-API vor Lambda | Amazon API Gateway |
| viele Batch-Jobs als Docker-Image, länger als 15 Minuten | AWS Batch |
| Container ohne EC2-Verwaltung | AWS Fargate |
| Kubernetes | Amazon EKS |
| private Docker-Registry | Amazon ECR |
| einfacher Webserver zum Festpreis | Amazon Lightsail |
| Verbindung läuft in den Timeout | Security Group prüfen |
Typische Fallen:
- Savings Plans reservieren keine Kapazität. Garantierte Kapazität gibt es nur mit einer Capacity Reservation.
- Feste IP-Adressen hat nur der NLB, Routing nach Domain nur der ALB. Erreichbar per DNS-Name sind beide.
- Der Classic Load Balancer ist nicht abgeschaltet. Abgeschaltet wurde 2022 EC2-Classic.
- Spot ist nie die Antwort für Datenbanken oder kritische Jobs, auch wenn es die günstigste Option ist.
- Lambda endet nach 15 Minuten. Längere Jobs gehören zu AWS Batch, Fargate oder EC2.
- Lambda führt kein beliebiges Docker-Image aus. Ein Container-Image für Lambda braucht einen Runtime Interface Client, der mit dem Lambda-Dienst spricht, und muss in einem Amazon-ECR-Repository derselben Region liegen. Wer ein vorhandenes Image unverändert betreiben will, landet bei ECS oder Fargate.
- ECS ist nicht automatisch serverless. Erst mit Fargate entfällt die Verwaltung der Instanzen.
Quellen
- Exam Guide CLF-C02, Domain 3 und 4
- In-Scope-Services CLF-C02
- Savings Plans und Reserved Instances im Vergleich
- Amazon EC2 Pricing
- Amazon EC2 On-Demand Pricing
- Migration vom Classic Load Balancer
- Classic Load Balancer, Document History
- Lambda-Quotas
- AWS Lambda Pricing und Free Tier
- AWS Compute Blog: Lambda rechnet die INIT-Phase ab
- Reserved Instances im RI Marketplace verkaufen
- Capacity Reservations: Preise und Abrechnung
- EC2 User Data
- Network Load Balancer: DNS-Name und IP-Adressen
- Network Load Balancer: Listener
- Gateway Load Balancer
- Unterschiede zwischen EC2 und Lightsail
- Shared Responsibility Model
- EC2 User Guide: kostenpflichtige AMIs im AWS Marketplace
- AWS License Manager User Guide
- Knowledge Center: Lambda-Kosten senken (Speicher und CPU)
- Lambda Developer Guide: Funktion aus einem Container-Image
Im nächsten Teil geht es um Storage, von EBS und EFS bis zu den Speicherklassen von S3.
