AWS Cloud Practitioner 04: Storage
Jede Anwendung braucht einen Ort für ihre Daten, und AWS bietet dafür nicht einen Dienst, sondern eine ganze Familie. Es gibt Platten, die an genau einer EC2-Instanz hängen, Dateisysteme, die viele Instanzen gleichzeitig nutzen, und einen Objektspeicher, der Dateien in praktisch beliebiger Menge über eine API ausliefert. In der Prüfung CLF-C02 tauchen diese Dienste vor allem als Zuordnungsfragen auf, bei denen ein kurzes Szenario den passenden Speicher verlangt. Schauen wir uns an, wie EBS, Instance Store, EFS, FSx und S3 funktionieren, wofür wir sie nehmen und wo die typischen Verwechslungen liegen.
Block, Datei, Objekt
Die Speicherdienste lassen sich nach der Art sortieren, wie ein Programm auf die Daten zugreift. Ein Block Storage verhält sich wie eine Festplatte, das Betriebssystem legt darauf sein eigenes Dateisystem an. Ein File Storage ist ein fertiges Dateisystem im Netz, das mehrere Rechner gleichzeitig einbinden. Ein Object Storage kennt weder Platte noch Verzeichnisbaum, er speichert einzelne Objekte unter einem Schlüssel.
| Art | Dienste | Wer greift zu | Typischer Einsatz |
|---|---|---|---|
| Block | EBS, Instance Store | eine EC2-Instanz | Betriebssystem, Datenbank auf EC2 |
| Datei | EFS, FSx | viele Instanzen gleichzeitig | gemeinsame Verzeichnisse |
| Objekt | S3 | jeder Berechtigte über die API | Backups, Medien, Logs, statische Websites |
Wer diese drei Arten auseinanderhalten kann, löst einen großen Teil der Storage-Fragen bereits über das Ausschlussprinzip.
EBS und Instance Store hängen an einer Instanz
Amazon EBS (Elastic Block Store) ist ein Netzlaufwerk. Die Instanz sieht es wie eine eingebaute Festplatte, die Daten liegen aber im Netz der Availability Zone und überleben deshalb das Stoppen oder Beenden der Instanz. Ein EBS-Volume gehört deshalb zu genau einer Availability Zone. Eine Instanz in eu-central-1a kann kein Volume aus eu-central-1b einbinden. Wer Daten in eine andere AZ bringen will, erstellt einen Snapshot und legt daraus in der Ziel-AZ ein neues Volume an.
Abgerechnet wird bei EBS die bereitgestellte Größe, nicht die belegte. Ein Volume mit 100 GB kostet also auch dann voll, wenn nur 10 GB darauf liegen.
Snapshots dienen zugleich als Backup. Für selten benötigte Snapshots gibt es EBS Snapshots Archive. Das Archiv kostet laut AWS 0,0125 US-Dollar pro GB und Monat statt 0,05 US-Dollar im Standard-Tier, also 75 Prozent weniger. Dafür gilt eine Mindestdauer von 90 Tagen, und ein Restore dauert 24 bis 72 Stunden und kostet 0,03 US-Dollar pro GB (us-east-1, Stand Oktober 2026, Preise sind Momentaufnahmen). Gegen versehentliches Löschen von Snapshots hilft der Recycle Bin, aus dem sich gelöschte Snapshots wiederherstellen lassen.
Beim Beenden einer Instanz entscheidet das Attribut Delete on Termination, was mit den Volumes passiert. Standardmäßig wird ein beim Start angelegtes Root-Volume mitgelöscht, nachträglich angehängte Volumes bleiben bestehen.
Der Instance Store ist das Gegenmodell. Er sitzt physisch im Host-Rechner, auf dem die Instanz läuft, und liefert dadurch sehr niedrige Latenz und hohen I/O. Einen Neustart übersteht er. Wird die Instanz gestoppt, in den Ruhezustand versetzt oder beendet, sind die Daten weg. Er eignet sich deshalb nur für Daten, die sich jederzeit neu erzeugen lassen.
| EBS | Instance Store | |
|---|---|---|
| Ort | Netzlaufwerk in einer AZ | Platte im Host |
| Stop oder Terminate | Daten bleiben (außer Root-Volume mit Delete on Termination) | Daten sind verloren |
| Umzug in andere AZ | über Snapshot | nicht vorgesehen |
| Stärke | dauerhaft, per Snapshot zu sichern | maximale Leistung |
Aus einer konfigurierten Instanz lässt sich eine AMI (Amazon Machine Image) erzeugen, also ein vorkonfiguriertes Image mit Betriebssystem und Software, aus dem neue EC2-Instanzen starten (zu EC2 selbst siehe Teil 03). AMIs gelten pro Region und lassen sich in andere Regionen kopieren. EC2 Image Builder automatisiert das Bauen, Testen und Verteilen solcher Images.
EFS und FSx teilen Dateien
Ein EBS-Volume hängt an einer Instanz. Sollen mehrere Instanzen dieselben Dateien sehen, braucht es ein Dateisystem im Netz. Amazon EFS (Elastic File System) ist ein verwaltetes Dateisystem für Linux-Instanzen, das regional angelegt wird. Instanzen aus mehreren AZs binden es gleichzeitig ein. Anders als bei EBS bezahlen wir bei EFS nur den tatsächlich belegten Speicher, eine Größe legen wir vorab nicht fest.
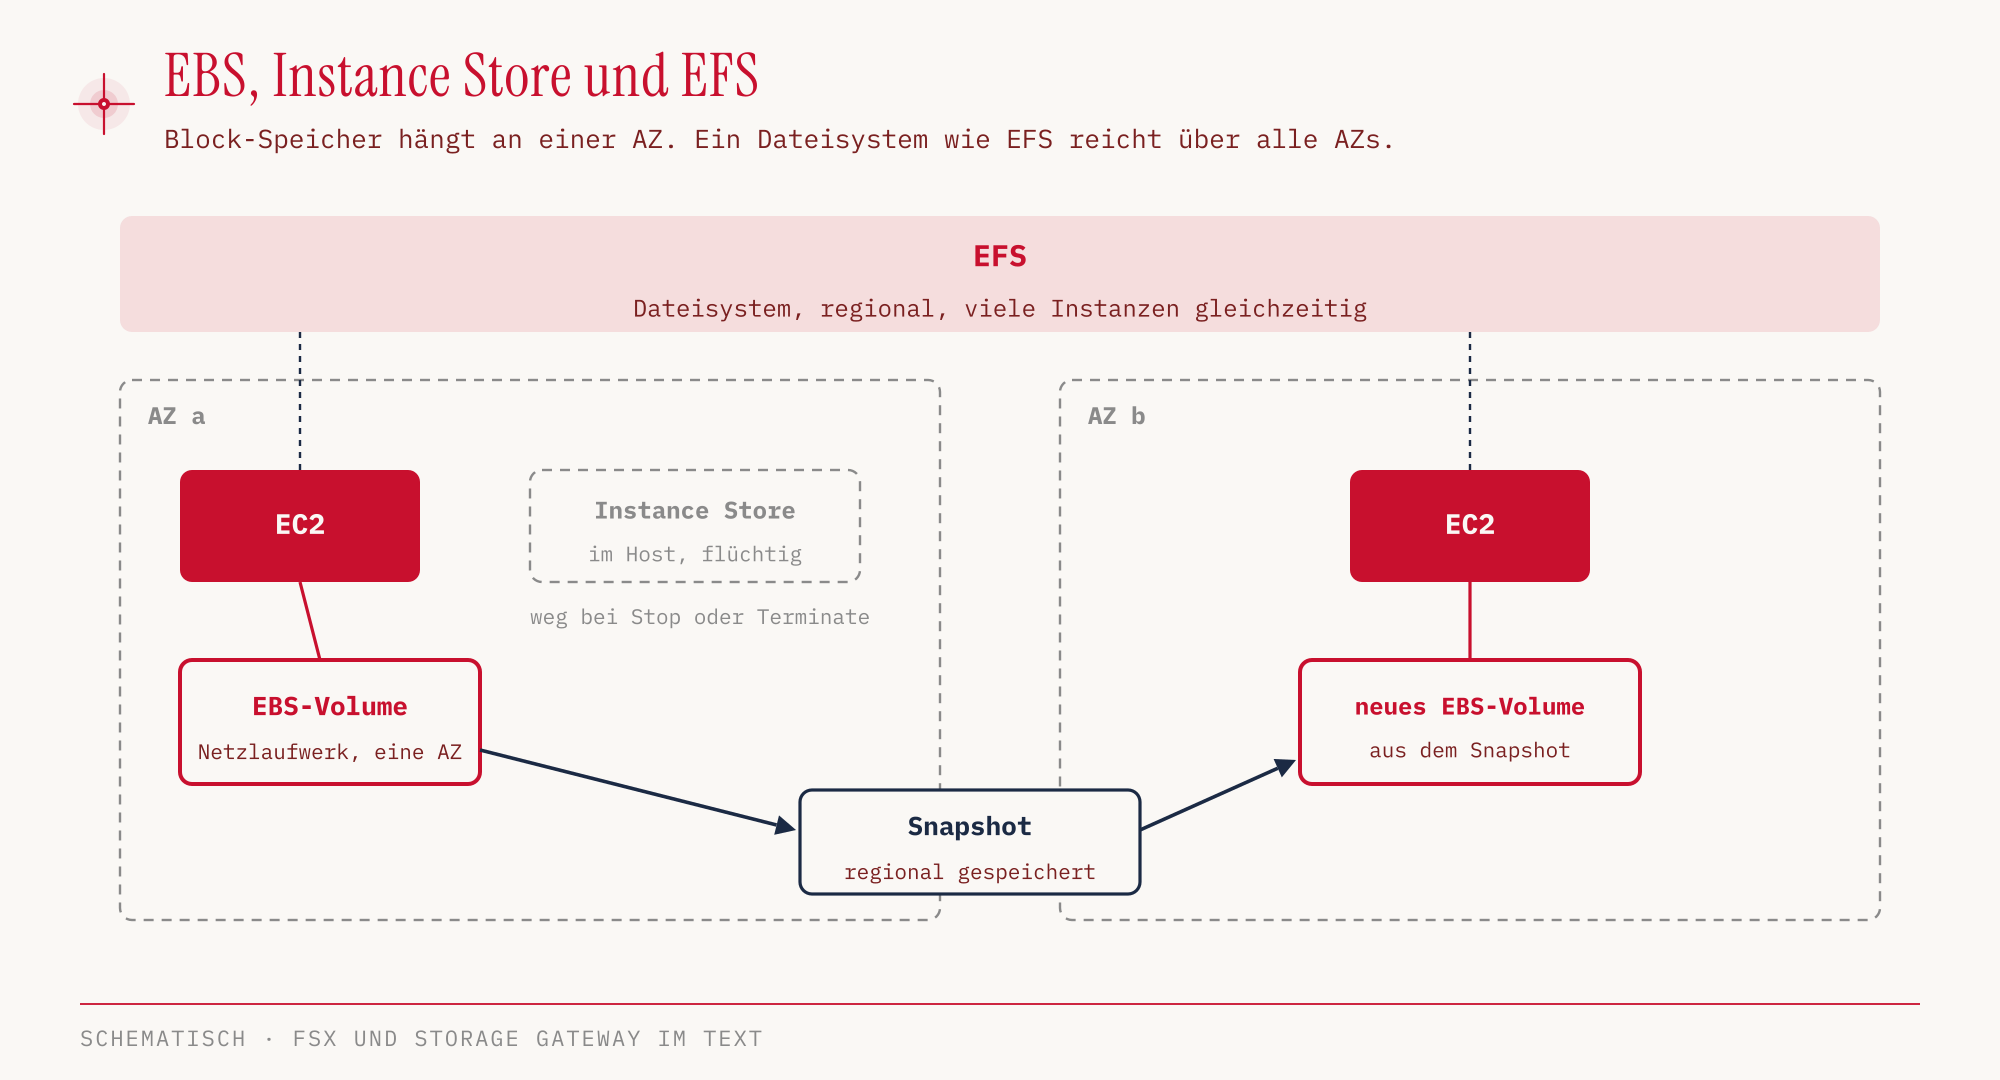
Auch EFS kennt günstigere Klassen für selten genutzte Dateien. EFS Infrequent Access ist laut AWS bis zu 95 Prozent günstiger als EFS Standard, EFS Archive noch einmal bis zu 50 Prozent günstiger als Infrequent Access und damit bis zu 97 Prozent unter Standard (Archive: 0,008 US-Dollar pro GB und Monat in us-east-1, Stand Oktober 2026). Eine Lifecycle Policy verschiebt Dateien automatisch. In der Voreinstellung wandern sie nach 30 Tagen ohne Zugriff in Infrequent Access und nach 90 Tagen in Archive.
Amazon FSx liefert bekannte Dateisysteme anderer Hersteller als verwalteten Dienst. Für die Prüfung zählt vor allem FSx for Windows File Server mit SMB, NTFS und Integration in Active Directory. Wer im Szenario „Windows-Dateifreigabe“ liest, ist hier richtig, nicht bei EFS. FSx for Lustre für Hochleistungsrechnen unter Linux ist laut Exam Guide nicht prüfungsrelevant.
AWS Storage Gateway verbindet das eigene Rechenzentrum mit Speicher in AWS. Die Varianten lassen sich in drei Gruppen fassen: File Gateway (als S3 File Gateway oder FSx File Gateway), Volume Gateway und Tape Gateway. Das Tape Gateway ersetzt Bandbibliotheken. Der Exam Guide nennt in diesem Zusammenhang „cached file systems“. Häufig genutzte Daten liegen lokal im Cache, der Gesamtbestand in AWS.
Zur Storage-Kategorie der In-Scope-Liste gehören außerdem AWS Backup, das Sicherungen verschiedener AWS-Dienste an einer Stelle bündelt, und AWS Elastic Disaster Recovery. Disaster Recovery behandeln wir ausführlich in Teil 11.
Auch beim Speicher gilt das Shared Responsibility Model aus Teil 01. AWS betreibt Hardware und Infrastruktur der Speicherdienste. Snapshots und Backups einzurichten, die Verschlüsselung zu wählen und die eigenen Daten zu schützen, bleibt laut Shared Responsibility Model for Resiliency unsere Aufgabe. Dazu gehört auch, dass Daten im Instance Store verloren gehen können. Bei S3 sind Versioning, Bucket Policies, Replication und die Wahl der Speicherklasse ebenfalls Konfiguration auf Kundenseite.
S3 speichert Objekte, keine Dateien
Amazon S3 (Simple Storage Service) ist der Dienst, der in der Prüfung am häufigsten vorkommt. Daten liegen dort als Objekte in Buckets. Ein Bucket gehört zu einer Region, sein Name muss im klassischen globalen Namensraum aber weltweit eindeutig sein. Seit März 2026 lassen sich Buckets optional auch in einem Account Regional Namespace anlegen, in dem ein Namenssuffix aus Account-ID und Region die Eindeutigkeit sichert. Erlaubt sind 3 bis 63 Zeichen aus Kleinbuchstaben, Ziffern, Punkten und Bindestrichen, Unterstriche nicht, und ein Name darf nicht wie eine IP-Adresse aussehen.
Jedes Objekt hat einen Key, und dieser Key ist der volle Pfad, etwa notizen/lernplan.txt. Echte Ordner gibt es nicht. Die Konsole stellt Präfixe vor dem Schrägstrich nur als Ordner dar. Ein einzelnes Objekt darf bis zu 50 TB groß sein. Ein einzelner Upload per PUT schafft bis zu 5 GB, darüber ist der Multipart Upload Pflicht, empfohlen wird er laut AWS schon ab 100 MB.
S3 ist auf eine Durability von elf Neunen ausgelegt (99,999999999 Prozent), und zwar in allen Speicherklassen. Durability beschreibt, wie unwahrscheinlich ein Datenverlust ist. Die Availability, also wie zuverlässig wir jederzeit an die Daten kommen, unterscheidet sich dagegen je nach Klasse. Diese Unterscheidung ist eine typische Prüfungsfalle.
Bucket-Zugriff, Deny schlägt Allow
S3 prüft jeden Zugriff gegen zwei Arten von Policies. IAM Policies sind user-based, sie hängen an Usern, Gruppen und Rollen (siehe Teil 02). Bucket Policies sind resource-based und hängen am Bucket selbst. Mit ihnen geben wir einen Bucket öffentlich frei, erzwingt Verschlüsselung oder erlaubt einem anderen AWS-Account den Zugriff.
Die Auswertung folgt einer festen Reihenfolge. Ein expliziter Deny in irgendeiner Policy gewinnt immer. Gibt es keinen, genügt innerhalb desselben Accounts ein Allow aus der IAM Policy oder aus der Bucket Policy. Erlaubt keine der beiden die Aktion, gilt sie als implizit abgelehnt. Bei Zugriffen aus einem anderen Account müssen beide Seiten zustimmen, die Bucket Policy des Eigentümers und die IAM Policy im fremden Account. Das haben wir in Teil 02 bei der Policy-Simulation gesehen, als s3:PutObject für einen Read-only-User als implicitDeny zurückkam.
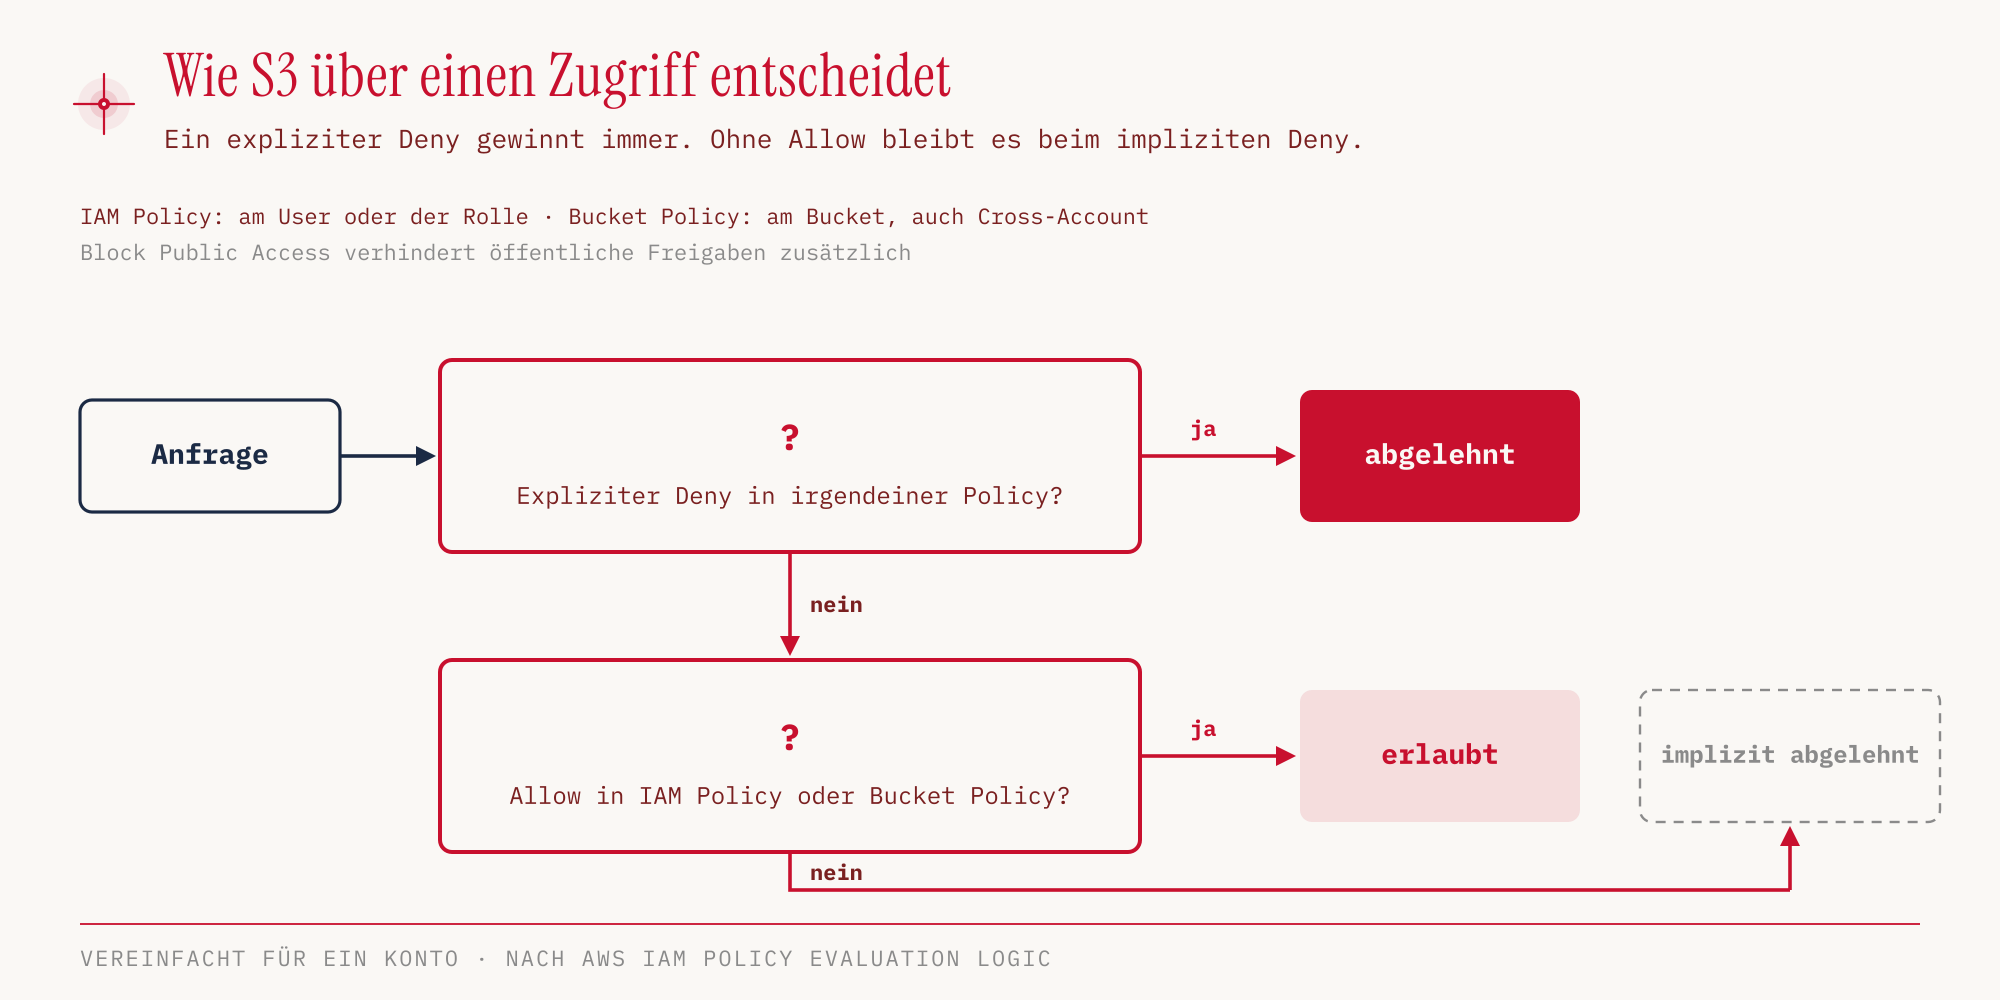
Über allem steht S3 Block Public Access. Die Funktion besteht aus vier Schaltern, die öffentliche Freigaben verhindern, auch wenn eine Policy sie erlauben würde, und lassen sich für einzelne Buckets, für den ganzen Account oder über AWS Organizations für eine ganze Organisation setzen. Bei neuen Buckets sind alle vier eingeschaltet. Im Hands-on unten lehnt S3 deshalb eine öffentliche Bucket Policy schlicht ab.
Speicherklassen, billig ablegen und teuer abrufen
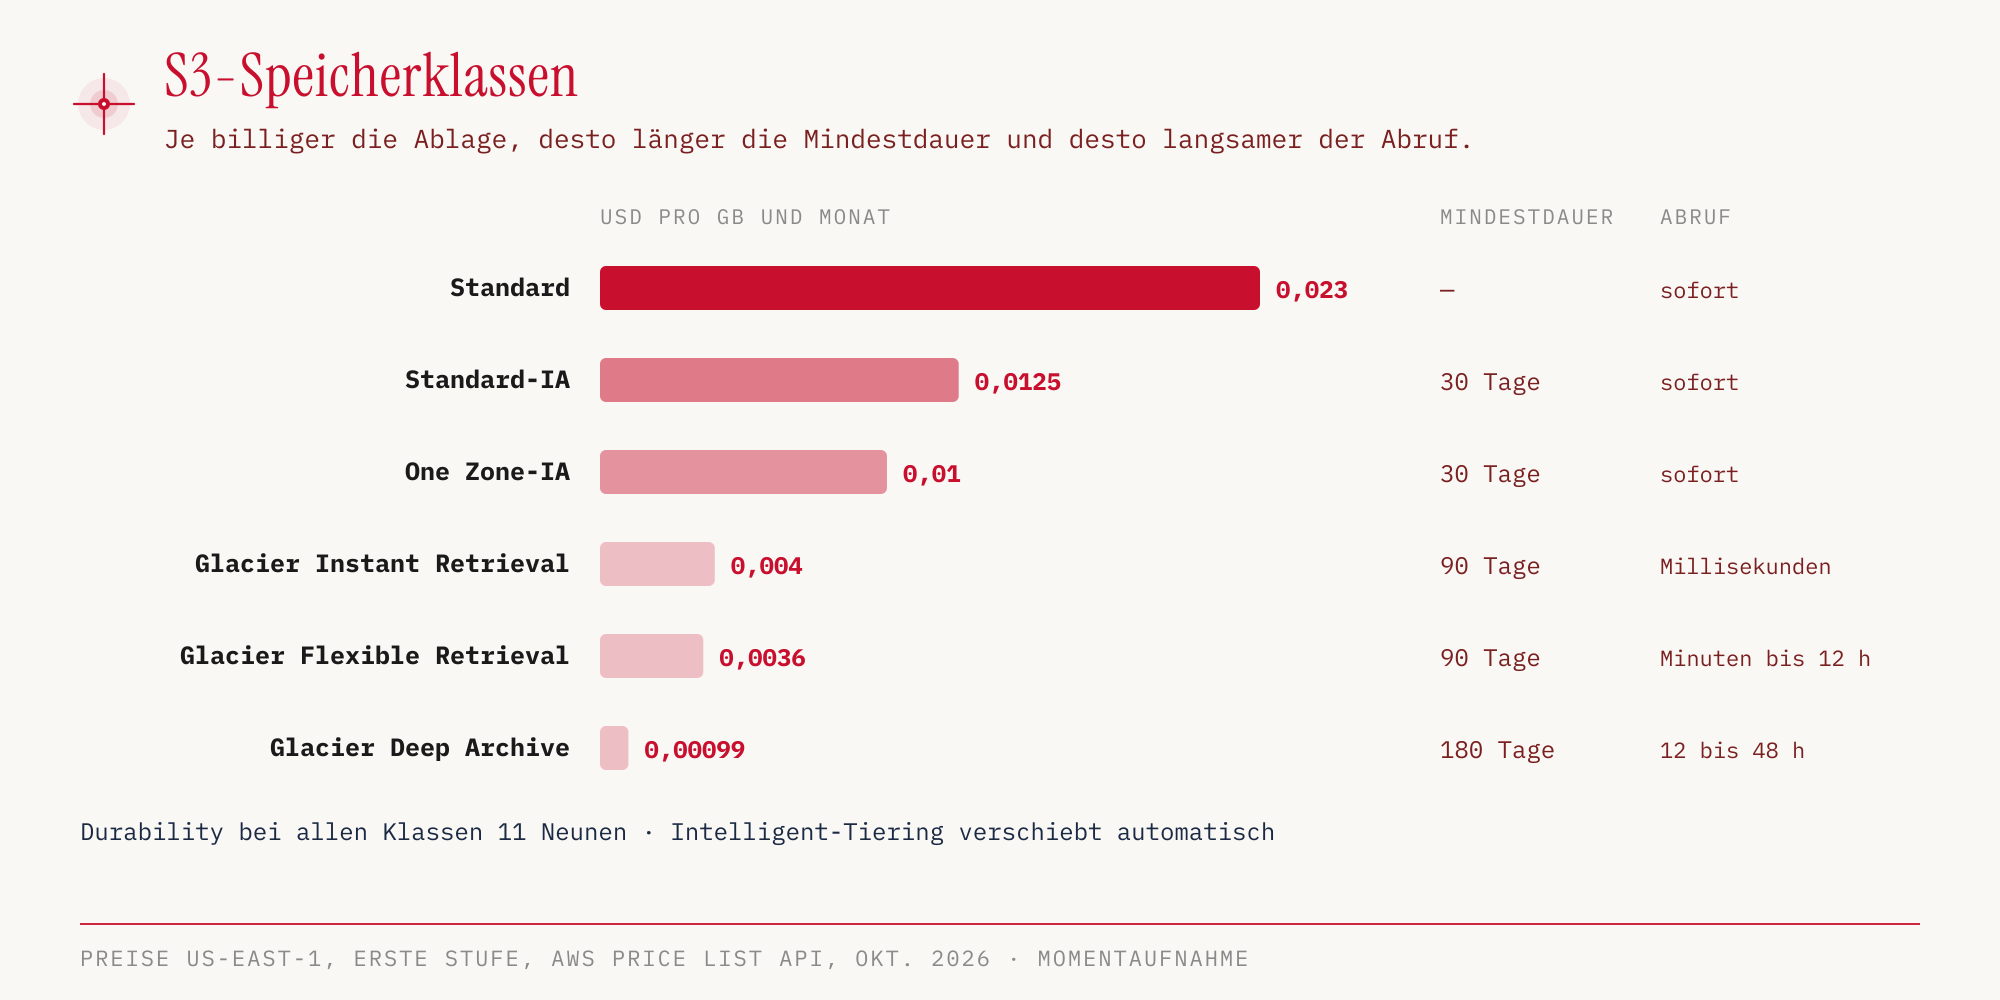
S3 bietet mehrere Speicherklassen, die sich in Preis, Mindestdauer und Abrufzeit unterscheiden. Die Mindestdauer bedeutet, dass ein Objekt mindestens so lange abgerechnet wird, auch wenn wir es früher löschen. Die Preise unten sind Speicherpreise pro GB und Monat in us-east-1, Stand Oktober 2026, und damit eine Momentaufnahme. Abrufgebühren und Anfragekosten kommen hinzu.
| Klasse | Besonderheit |
|---|---|
| S3 Standard | 99,99 % Availability |
| S3 Intelligent-Tiering | Preis, Mindestdauer und Abrufzeit je nach Tier, keine Abrufgebühr, Monitoring-Gebühr pro Objekt |
| S3 Standard-IA | für seltene Zugriffe |
| S3 One Zone-IA | nur eine AZ, 99,5 % Availability |
| S3 Glacier Instant Retrieval | 99,9 % Availability, mindestens 128 KB abgerechnet |
| S3 Glacier Flexible Retrieval | drei Abrufoptionen |
| S3 Glacier Deep Archive | günstigste Klasse |
Je billiger die Ablage, desto länger die Mindestdauer und desto langsamer oder teurer der Abruf. One Zone-IA spart, weil die Daten nur in einer AZ liegen. Fällt diese AZ aus, sind die Daten nicht erreichbar. Intelligent-Tiering ist die Antwort, wenn das Zugriffsmuster unbekannt ist. Die Klasse verschiebt Objekte selbst zwischen ihren Tiers und erhebt keine Abrufgebühr, kostet aber eine Monitoring-Gebühr pro Objekt.
Bei Glacier Flexible Retrieval wählen wir die Abrufgeschwindigkeit selbst. Expedited dauert 1 bis 5 Minuten, Standard 3 bis 5 Stunden, Bulk 5 bis 12 Stunden, und Bulk-Abrufe sind kostenlos. Bei Deep Archive dauert ein Standard-Abruf bis zu 12 Stunden, ein Bulk-Abruf bis zu 48 Stunden.
Der ältere, eigenständige Dienst Amazon Glacier mit seinen Vaults nimmt seit dem 15. Dezember 2025 keine Neukunden mehr an. Die S3-Glacier-Speicherklassen sind davon nicht betroffen.
Für Workloads mit sehr niedriger Latenz gibt es außerdem S3 Express One Zone. Die Daten liegen in einem Directory Bucket in einer einzigen AZ, Zugriffe liegen im einstelligen Millisekundenbereich. Gedacht ist die Klasse für latenzkritische Anwendungen, etwa in Analytics und Machine Learning. In der Scope-Liste steht sie nicht als eigener Dienst, sondern fällt unter S3.
Zwischen den Klassen wechseln wir manuell oder automatisch mit Lifecycle-Regeln. Eine Regel kann Objekte nach einer bestimmten Zahl von Tagen in eine günstigere Klasse verschieben oder löschen.
Versioning, Replication und statische Websites
Mit Versioning behält S3 jede Fassung eines Objekts. Versioning wird pro Bucket eingeschaltet. Ein Löschen ohne Angabe einer Version entfernt dann nichts, S3 setzt lediglich einen Delete Marker als neueste Version. Die alten Fassungen bleiben abrufbar, bis wir sie gezielt löschen. Das schützt vor versehentlichem Löschen und Überschreiben.
Versioning ist zugleich Voraussetzung für Replication. Die Cross-Region Replication (CRR) kopiert Objekte in einen Bucket in einer anderen Region, die Same-Region Replication (SRR) in einen Bucket derselben Region. Beide arbeiten asynchron. Laut AWS dient CRR etwa dazu, Compliance-Vorgaben für Kopien in entfernten Regionen zu erfüllen oder Nutzern in einer anderen Region Daten mit geringerer Latenz zu liefern. SRR nehmen wir, um Logs aus mehreren Buckets in einem Bucket zusammenzuführen, um Produktions- und Testkonto live zu spiegeln oder wenn Daten wegen Datenhoheit in derselben Region bleiben müssen.
S3 kann außerdem eine statische Website ausliefern. Antwortet die Website mit HTTP 403, fehlt meist die Bucket Policy, die öffentliches Lesen erlaubt. Solange Block Public Access aktiv ist, nimmt S3 eine solche Policy gar nicht erst an, wie das Hands-on gleich vorführt.
Hands-on
Legen wir einen Bucket an, schalten Versioning ein, löschen ein Objekt und holen es zurück, hinterlegen eine Lifecycle-Regel und versuchen am Ende, den Bucket öffentlich zu machen. Im globalen Namensraum sind Bucket-Namen weltweit eindeutig, wir verwenden deshalb ein Zufallssuffix. Wer mitmacht, wählt einen eigenen Namen. Die gekürzten Ausgaben stammen aus unserem Demo-Account vom 25. Oktober 2026.
S3 rechnet Speicher und Anfragen ab, außerhalb des Free Tier kann also auch ein kleiner Bucket Kosten erzeugen. Deshalb räumen wir am Ende vollständig auf.
Zuerst der Bucket und seine Voreinstellungen.
aws s3api create-bucket --bucket ccp-demo-edf11cfc \
  --region eu-central-1 \
  --create-bucket-configuration LocationConstraint=eu-central-1

aws s3api get-public-access-block --bucket ccp-demo-edf11cfc --region eu-central-1
{
    "PublicAccessBlockConfiguration": {
        "BlockPublicAcls": true,
        "IgnorePublicAcls": true,
        "BlockPublicPolicy": true,
        "RestrictPublicBuckets": true
    }
}
aws s3api get-bucket-encryption --bucket ccp-demo-edf11cfc --region eu-central-1 \
  --query 'ServerSideEncryptionConfiguration.Rules[0].ApplyServerSideEncryptionByDefault.SSEAlgorithm' \
  --output text
# AES256

aws s3api get-bucket-ownership-controls --bucket ccp-demo-edf11cfc --region eu-central-1 \
  --query 'OwnershipControls.Rules[0].ObjectOwnership' --output text
# BucketOwnerEnforced
Ohne unser Zutun ist der neue Bucket privat, mit SSE-S3 verschlüsselt (AES256), und ACLs sind abgeschaltet (BucketOwnerEnforced). Die vollständige Antwort von get-bucket-encryption enthält außerdem BlockedEncryptionTypes mit SSE-C. Verschlüsselung mit vom Kunden mitgelieferten Schlüsseln ist bei neuen Buckets also standardmäßig gesperrt. SSE-S3 ist serverseitige Verschlüsselung, S3 verschlüsselt die Daten also erst nach dem Empfang. Bei clientseitiger Verschlüsselung verschlüsseln wir die Daten selbst vor dem Upload, etwa mit dem Amazon S3 Encryption Client, und AWS bekommt sie nie im Klartext zu sehen. Verschlüsselung vertiefen wir in Teil 08.
In der Konsole: S3 → General purpose buckets → Create bucket → Bucket type General purpose → Bucket name → Create bucket, die Konsole fragt außerdem nach dem Bucket namespace, wir bleiben beim Global namespace. Im Formular finden wir Object Ownership „ACLs disabled (recommended)“, „Block all public access“ und Default encryption SSE-S3. Versioning schalten wir dort anders als in der CLI gleich beim Anlegen ein (Bucket Versioning „Enable“).
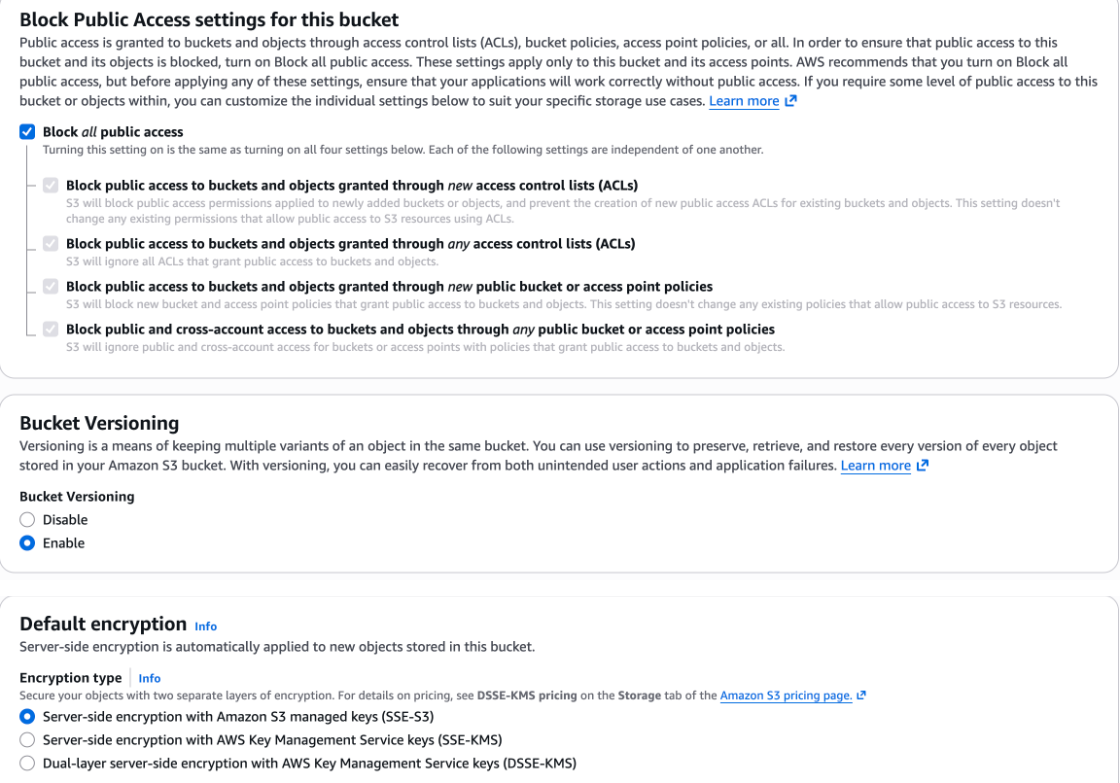
Jetzt schalten wir Versioning ein, schreiben zweimal auf denselben Key und löschen ihn.
aws s3api put-bucket-versioning --bucket ccp-demo-edf11cfc --region eu-central-1 \
  --versioning-configuration Status=Enabled

printf '%s' 'Version 1: IAM wiederholen' > lernplan.txt
aws s3api put-object --bucket ccp-demo-edf11cfc --region eu-central-1 \
  --key notizen/lernplan.txt --body lernplan.txt

printf '%s' 'Version 2: S3 und EBS wiederholen' > lernplan.txt
aws s3api put-object --bucket ccp-demo-edf11cfc --region eu-central-1 \
  --key notizen/lernplan.txt --body lernplan.txt

aws s3api delete-object --bucket ccp-demo-edf11cfc --region eu-central-1 \
  --key notizen/lernplan.txt

aws s3api list-object-versions --bucket ccp-demo-edf11cfc --region eu-central-1 \
  --query 'Versions[].[Size, IsLatest]' --output text
# 33    False
# 26    False

aws s3api list-object-versions --bucket ccp-demo-edf11cfc --region eu-central-1 \
  --query 'DeleteMarkers[].IsLatest' --output text
# True
In der Konsole: Bucket → Tab Objects → notizen/ → Show versions.
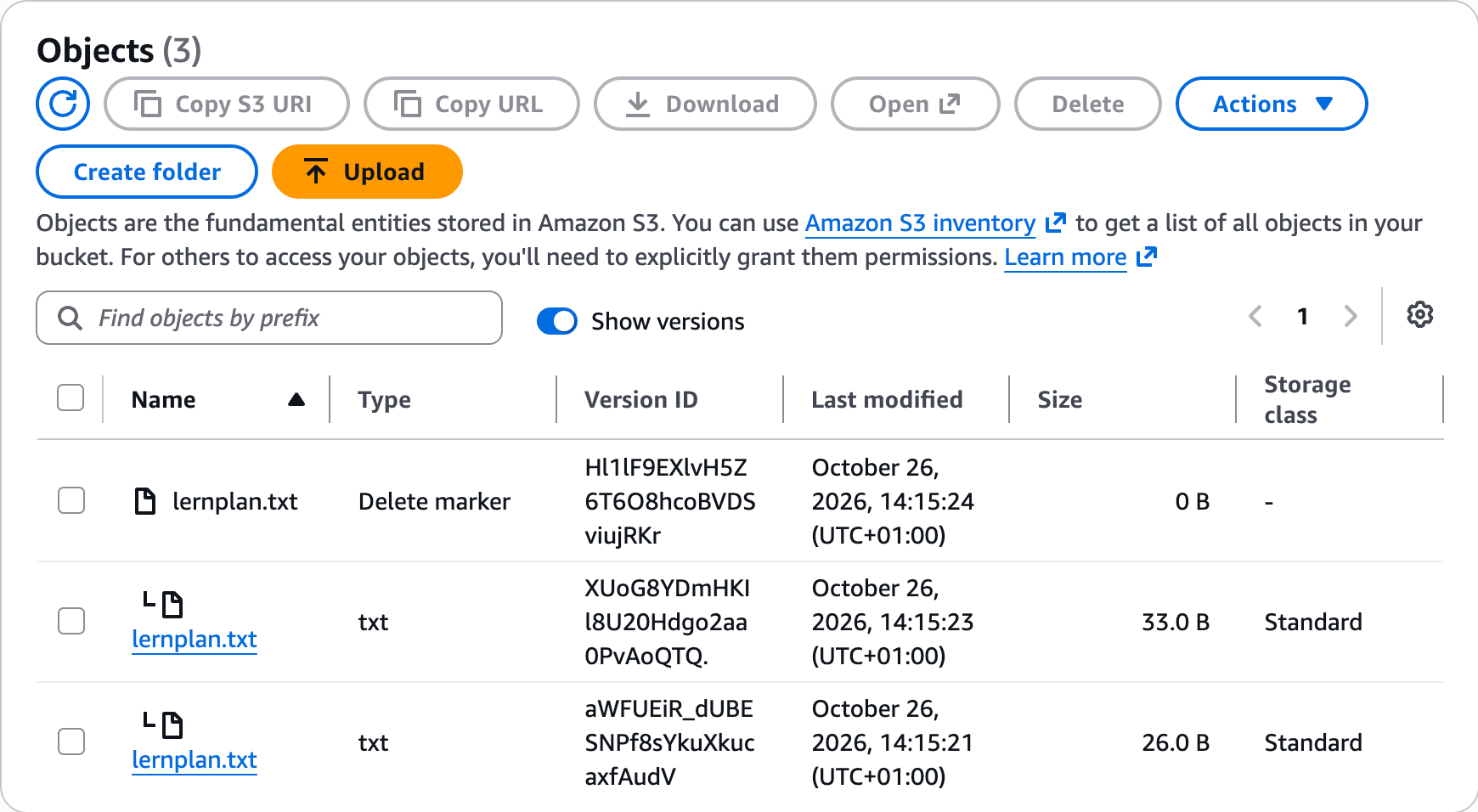
Beide Fassungen sind noch da, die neueste Version ist der Delete Marker. Ein normaler Abruf scheitert deshalb, ein Abruf mit Version-ID liefert die alte Fassung.
aws s3api get-object --bucket ccp-demo-edf11cfc --region eu-central-1 \
  --key notizen/lernplan.txt aktuell.txt
# An error occurred (NoSuchKey) when calling the GetObject operation: ...

V1=$(aws s3api list-object-versions --bucket ccp-demo-edf11cfc --region eu-central-1 \
  --query 'Versions[?Size==`26`].VersionId' --output text)
aws s3api get-object --bucket ccp-demo-edf11cfc --region eu-central-1 \
  --key notizen/lernplan.txt --version-id "$V1" alt.txt
cat alt.txt
# Version 1: IAM wiederholen
In der Konsole: Version anklicken → Download oder Open. Alternativ löschen wir dort den Delete marker.
Die Lifecycle-Regel verschiebt alles unter notizen/ nach 30 Tagen nach Standard-IA, nach 90 Tagen nach Glacier Instant Retrieval und löscht ältere Versionen 30 Tage, nachdem sie abgelöst wurden. Die Datei lifecycle.json:
{
  "Rules": [
    {
      "ID": "lernnotizen",
      "Status": "Enabled",
      "Filter": { "Prefix": "notizen/" },
      "Transitions": [
        { "Days": 30, "StorageClass": "STANDARD_IA" },
        { "Days": 90, "StorageClass": "GLACIER_IR" }
      ],
      "NoncurrentVersionExpiration": { "NoncurrentDays": 30 }
    }
  ]
}
aws s3api put-bucket-lifecycle-configuration --bucket ccp-demo-edf11cfc \
  --region eu-central-1 --lifecycle-configuration file://lifecycle.json
S3 nimmt die Regel ohne Ausgabe an.
In der Konsole: Bucket → Tab Management → Lifecycle rules → Create lifecycle rule. Die Detailansicht der Regel zeigt die Zeitleiste Day 0, Day 30 Standard-IA, Day 90 Glacier Instant Retrieval und für ältere Versionen Day 30 permanently deleted.
Zum Schluss der Versuch, den Bucket mit einer Bucket Policy für alle ("Principal": "*") lesbar zu machen. Die Datei public-read.json:
{
  "Version": "2012-10-17",
  "Statement": [
    {
      "Effect": "Allow",
      "Principal": "*",
      "Action": "s3:GetObject",
      "Resource": "arn:aws:s3:::ccp-demo-edf11cfc/*"
    }
  ]
}
aws s3api put-bucket-policy --bucket ccp-demo-edf11cfc --region eu-central-1 \
  --policy file://public-read.json
# An error occurred (AccessDenied) when calling the PutBucketPolicy operation:
# ... public policies are prevented by the BlockPublicPolicy setting in S3 Block Public Access
In der Konsole: Bucket → Tab Permissions → Bucket policy → Edit. Bei aktivem Block Public Access steht dort der Hinweis „Public access is blocked because Block Public Access settings are turned on for this bucket“.
Block Public Access greift, bevor die Policy überhaupt gespeichert wird. Für eine öffentliche statische Website müssten wir diesen Schutz für den Bucket bewusst lockern.
Zum Aufräumen genügt delete-bucket nicht, solange noch Versionen und Delete Marker im Bucket liegen. Wir sammeln sie ein und löschen sie gemeinsam.
aws s3api list-object-versions --bucket ccp-demo-edf11cfc --region eu-central-1 \
  --query '{Objects: [Versions[].{Key: Key, VersionId: VersionId}, DeleteMarkers[].{Key: Key, VersionId: VersionId}][]}' \
  --output json > delete.json

aws s3api delete-objects --bucket ccp-demo-edf11cfc --region eu-central-1 \
  --delete file://delete.json

aws s3api delete-bucket --bucket ccp-demo-edf11cfc --region eu-central-1

rm lernplan.txt alt.txt lifecycle.json public-read.json delete.json
Für die Prüfung
| Stichwort in der Frage | Antwort |
|---|---|
| Festplatte für eine EC2-Instanz, Daten sollen Stop überleben | EBS |
| höchste Leistung, Daten temporär | Instance Store |
| Volume in eine andere AZ bringen | EBS Snapshot |
| gemeinsames Dateisystem für viele Linux-Instanzen über AZs | EFS |
| Windows-Dateifreigabe, SMB, Active Directory | FSx for Windows File Server |
| eigenes Rechenzentrum an S3 anbinden, Bandbibliothek ersetzen | Storage Gateway (Tape Gateway) |
| Sicherungen mehrerer Dienste zentral steuern | AWS Backup |
| Zugriffsmuster unbekannt | S3 Intelligent-Tiering |
| Archiv, Abruf trotzdem in Millisekunden | S3 Glacier Instant Retrieval |
| Zugriff etwa einmal pro Quartal, dann aber sofort | S3 Glacier Instant Retrieval |
| günstigste Langzeitarchivierung, Abruf bis 48 Stunden genügt | S3 Glacier Deep Archive |
| Schutz vor versehentlichem Löschen in S3 | Versioning |
| Kopie der Objekte in eine andere Region | Cross-Region Replication (Versioning nötig) |
| Logs mehrerer Buckets in einer Region zusammenführen | Same-Region Replication |
| Bucket darf niemals öffentlich werden | S3 Block Public Access |
| anderem AWS-Account Zugriff auf einen Bucket geben | Bucket Policy |
| AWS darf die Daten nie unverschlüsselt sehen | clientseitige Verschlüsselung |
| Wer richtet Snapshots und Backups ein? | der Kunde |
Typische Fallen:
- Durability und Availability verwechseln. Die Durability ist in allen S3-Klassen gleich (elf Neunen), unterschiedlich ist nur die Availability.
- EBS über AZs nutzen wollen. EBS ist an eine AZ gebunden, EFS ist regional. Der Weg in eine andere AZ führt über einen Snapshot.
- Instance Store für dauerhafte Daten wählen. Nach Stop oder Terminate sind die Daten weg.
- Mindestdauer übersehen. Wer Objekte in Glacier Deep Archive nach einem Monat löscht, zahlt trotzdem für 180 Tage.
- Glacier-Dienst und Glacier-Speicherklassen gleichsetzen. Nur der alte Vault-Dienst nimmt keine Neukunden mehr an, die S3-Speicherklassen bleiben.
- S3 schützt die Daten von allein. AWS sorgt für Durability und Infrastruktur, Versioning und Verschlüsselungsoptionen einzurichten ist Sache des Kunden.
- EBS-Kosten nach belegtem Speicher schätzen. EBS kostet die bereitgestellte Größe, EFS nur den belegten Speicher.
Quellen
- AWS Certified Cloud Practitioner (CLF-C02) Exam Guide
- CLF-C02 In-Scope-Services
- CLF-C02 Out-of-Scope-Services
- Amazon EBS Snapshots FAQs
- Amazon EFS Features
- Amazon S3 Pricing
- Amazon S3 User Guide: Glacier-Speicherklassen
- Amazon S3 Glacier Instant Retrieval
- Amazon S3 User Guide: Objekte
- Amazon S3 FAQs
- Amazon Glacier Pricing
- Amazon S3 User Guide: Speicherklassen im Vergleich
- Amazon S3 User Guide: Bucket-Namensregeln
- AWS News Blog: Account Regional Namespaces für S3
- Amazon S3 Block Public Access
- Knowledge Center: Cross-Account-Zugriff auf S3
- EC2 User Guide: Datenhaltung im Instance Store
- EC2 User Guide: Volumes beim Beenden einer Instanz
- Amazon EBS Pricing
- Amazon EFS Pricing
- Shared Responsibility Model
- Reliability Pillar: Shared Responsibility Model for Resiliency
- Amazon S3 User Guide: Replication
- Amazon S3 User Guide: clientseitige Verschlüsselung
In Teil 05 geht es um Datenbanken und Analytics, von RDS und Aurora bis DynamoDB und Redshift.
