AWS Cloud Practitioner 05: Datenbanken und Analytics
AWS bietet für fast jede Form von Daten einen eigenen Dienst an, von der klassischen relationalen Datenbank über den Key-Value-Speicher bis zum Data Warehouse. In der Prüfung CLF-C02 kommt das nicht als Detailwissen vor, sondern als Zuordnungsfrage. Eine Anforderung steht im Text, gesucht ist der passende Dienst. Für jeden Dienst zählt deshalb, wofür er gebaut ist und womit er gern verwechselt wird. Am Ende legen wir eine DynamoDB-Tabelle an und sehen, was ein Lesezugriff kostet.
Relationale Datenbanken als Managed Service
Eine relationale Datenbank auf einer eigenen EC2-Instanz zu betreiben ist möglich. Dann kümmern wir uns aber selbst um Betriebssystem, Patches, Backups und Ausfallsicherheit. Amazon RDS (Relational Database Service) nimmt uns genau diese Arbeit ab. Wir wählen eine Engine, eine Instanzgröße und den Speicher, AWS übernimmt den Betrieb darunter. RDS unterstützt derzeit Db2, MariaDB, Microsoft SQL Server, MySQL, Oracle und PostgreSQL (RDS User Guide, Stand 2026-10-25).
Der Preis für den Komfort ist Kontrolle. Auf den Server unter einer RDS-Datenbank kommen wir nicht per SSH, das Betriebssystem gehört zum Teil, den AWS verantwortet. Das ist die Shared Responsibility in der Praxis. AWS kümmert sich um Hardware, Betriebssystem und Patches der Datenbank-Software, wir bleiben für unsere Daten, die Zugriffsrechte und die Netzwerkfreigaben zuständig. Automatische Backups mit Point-in-Time-Restore gehören zum Lieferumfang.
Daraus ergibt sich die Abwägung, die der Exam Guide in Task 3.4 ausdrücklich nennt, nämlich wann eine Datenbank auf EC2 und wann ein Managed Service passt. Die eigene Datenbank auf EC2 bleibt die Wahl, wenn wir Zugriff aufs Betriebssystem brauchen oder eine Engine betreiben wollen, die RDS nicht anbietet. In allen anderen Fällen spricht für RDS, dass AWS den Betrieb übernimmt.
RDS ist das typische Werkzeug für OLTP (Online Transaction Processing), also viele kleine Lese- und Schreibvorgänge wie Bestellungen, Buchungen oder Benutzerkonten. Für Auswertungen über Millionen von Zeilen ist es nicht gebaut, dafür gibt es Redshift.
Amazon Aurora ist AWS’ eigene relationale Engine, kompatibel zu MySQL und PostgreSQL. Sie läuft unter dem RDS-Dach, hat aber eine eigene Speicherschicht, die automatisch mitwächst. Die Obergrenze liegt je nach Version bei 256 TiB (ab Aurora PostgreSQL 17.5, 16.9 und 15.13 sowie Aurora MySQL 3.10), ältere Versionen enden bei 128 TiB (Aurora Limits, Stand 2026-10-25). Für die Prüfung genügt eine Faustregel. RDS heißt „bekannte Engine, von AWS betrieben“, Aurora heißt „cloud-optimierte Engine von AWS, MySQL- oder PostgreSQL-kompatibel“.
Mit Aurora Serverless passt Aurora die Rechenkapazität automatisch an die Last an, gemessen in Aurora Capacity Units (ACU). Das eignet sich für sporadische oder schwer vorhersehbare Last, bei der wir keine Instanzgröße im Voraus planen wollen (Aurora Serverless).
| Merkmal | RDS | Aurora |
|---|---|---|
| Engines | Db2, MariaDB, SQL Server, MySQL, Oracle, PostgreSQL | MySQL- und PostgreSQL-kompatibel |
| Speicher | fest gewählt, erweiterbar | wächst automatisch, bis 256 TiB (versionsabhängig) |
| Read Replicas | 3 bis 15, je nach Engine | bis zu 15 |
| Zugriff aufs Betriebssystem | nein | nein |
Multi-AZ für Ausfallsicherheit, Read Replicas für Leselast
Multi-AZ und Read Replicas erzeugen beide eine zweite Kopie der Datenbank. In der Prüfung werden sie ständig verwechselt.
Multi-AZ schützt vor Ausfall. RDS hält in einer zweiten Availability Zone eine Standby-Instanz und repliziert jede Schreiboperation synchron dorthin. Fällt die Primärinstanz oder ihre ganze AZ aus, übernimmt der Standby automatisch, die Anwendung verbindet sich weiter mit demselben Endpunkt. Im klassischen Multi-AZ-Setup mit einer Standby-Instanz liest niemand vom Standby. Er wartet nur.
Read Replicas verteilen Leselast. Die Replikation läuft asynchron, eine Replica kann also kurz hinter der Primärinstanz zurückliegen. Dafür darf die Anwendung von ihr lesen und entlastet so die Hauptdatenbank, etwa für Berichte oder stark gelesene Produktkataloge. Replicas sind auch in anderen Regionen möglich. Das verkürzt die Lese-Latenz für Nutzer in der Nähe und hält eine Kopie für den Katastrophenfall bereit.
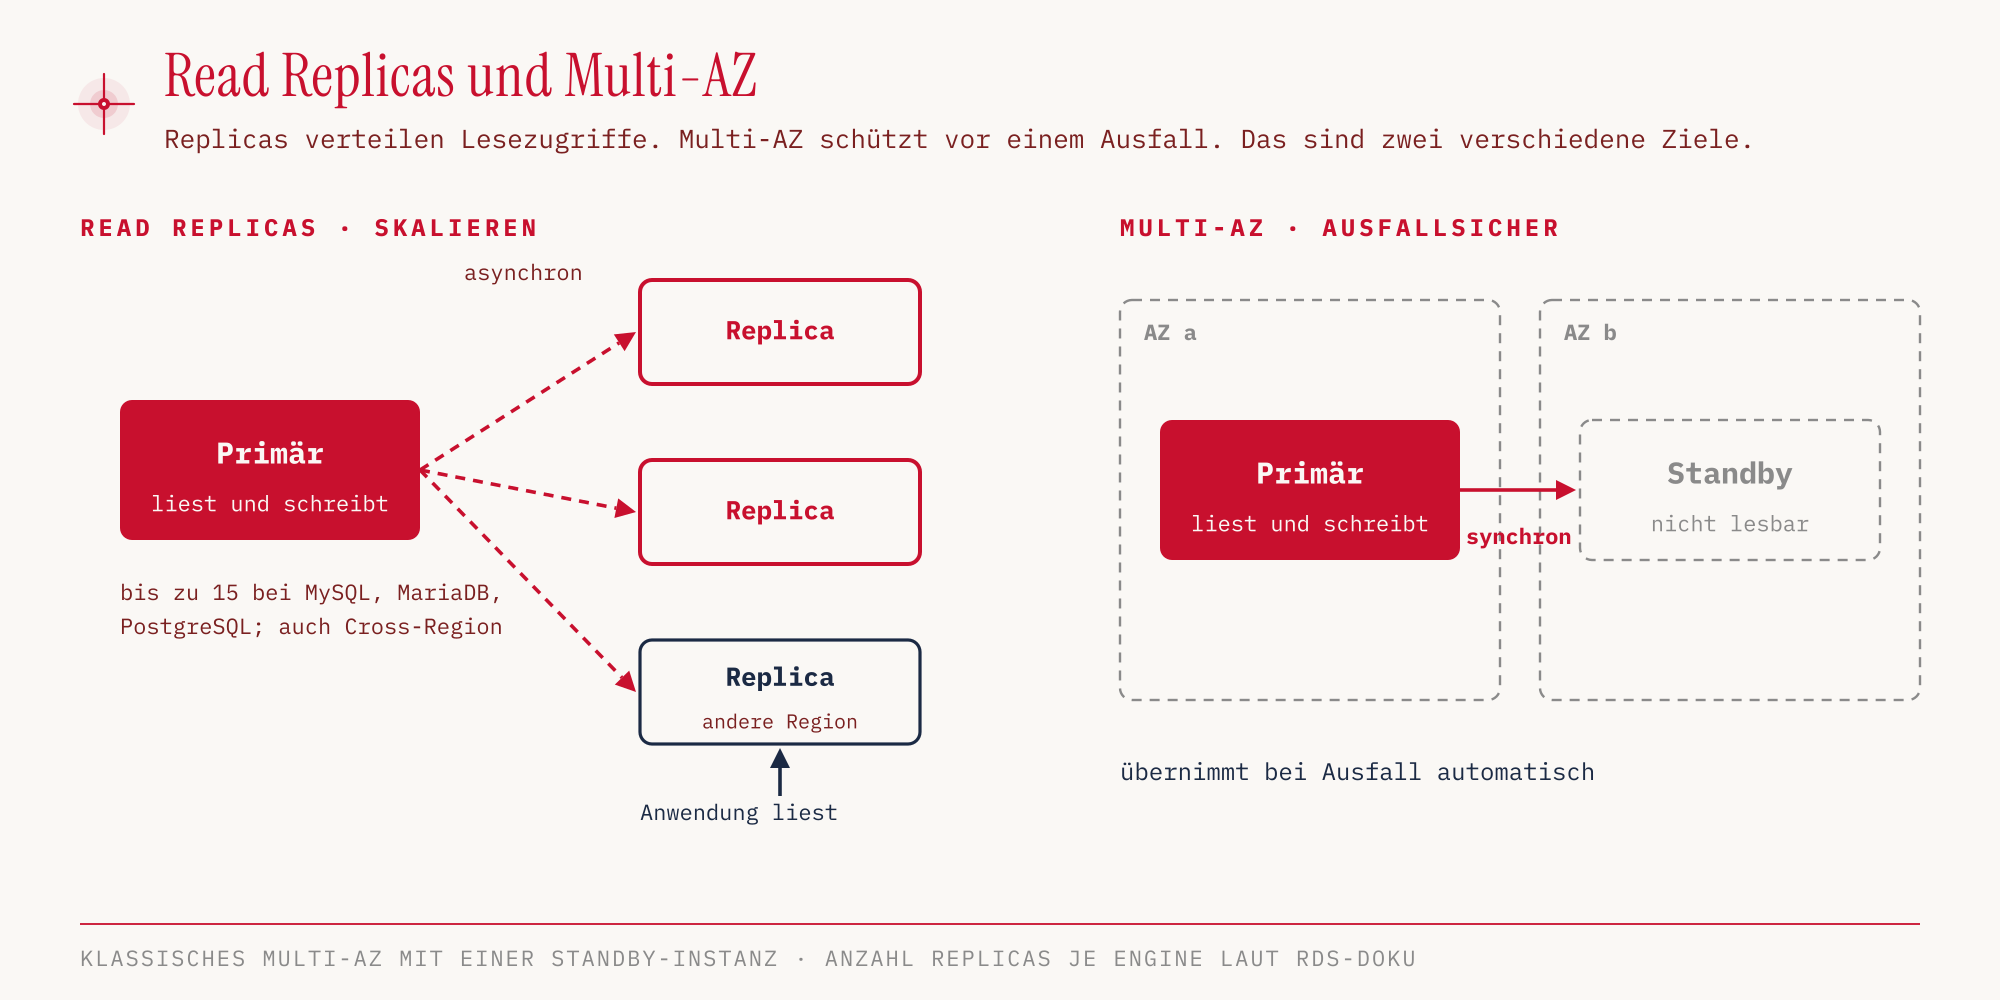
Die oft genannte Zahl „bis zu 15 Read Replicas“ gilt nicht für jede Engine. Laut AWS-CLI-Referenz zu create-db-instance-read-replica und Aurora User Guide (Stand 2026-10-25) sieht es so aus:
| Engine | Read Replicas pro Quelle | Cross-Region |
|---|---|---|
| MySQL, MariaDB, PostgreSQL | bis 15 | ja |
| Aurora | bis 15 | ja |
| Oracle | bis 5 | ja |
| SQL Server | bis 5 | nein |
| Db2 | bis 3 | ja |
Für die Prüfung reicht die Faustregel „bis zu 15“, solange klar ist, dass Oracle, SQL Server und Db2 darunter liegen.
| Multi-AZ | Read Replicas | |
|---|---|---|
| Zweck | Hochverfügbarkeit, automatischer Failover | Leseskalierung, Disaster Recovery über Regionen |
| Replikation | synchron | asynchron |
| Lesbar | nein (klassisches Setup) | ja |
| Ort | andere AZ, gleiche Region | gleiche oder andere Region |
Caches und Key-Value-Speicher
Nicht jede Abfrage muss bis zur Datenbank durchlaufen. Amazon ElastiCache ist ein verwalteter In-Memory-Cache mit den Engines Valkey, Redis OSS oder Memcached (ElastiCache Doku). Er liegt vor einer Datenbank wie RDS und beantwortet wiederholte Leseanfragen aus dem Arbeitsspeicher. Das entlastet die Datenbank und verkürzt die Antwortzeit. Die Anwendung muss den Cache dafür selbst ansprechen.
Amazon DynamoDB folgt einem anderen Modell. Die serverlose NoSQL-Datenbank speichert Key-Value- und Dokumentdaten. Es gibt keine Instanz, die wir auswählen, und keine Tabellenstruktur mit festen Spalten. Jedes Item braucht nur seinen Schlüssel, alle anderen Attribute sind frei. Gelesen wird über den Schlüssel, und das auch bei großen Datenmengen mit einer Latenz im einstelligen Millisekundenbereich. Komplexe Joins über mehrere Tabellen kann DynamoDB nicht, dafür bleibt RDS die Wahl.
In Prüfungsfragen tauchen dazu regelmäßig diese Zusätze auf:
- DAX (DynamoDB Accelerator) ist ein Cache, der ausschließlich für DynamoDB funktioniert und Lesezugriffe im Modus eventually consistent vom Millisekunden- in den Mikrosekundenbereich bringt (DynamoDB Doku). Steht in der Frage „DynamoDB“ und „Cache“, ist DAX gemeint, nicht ElastiCache.
- Global Tables replizieren eine DynamoDB-Tabelle in mehrere Regionen, und in jeder Region darf geschrieben werden (active-active).
Abgerechnet wird je nach Modus unterschiedlich. Im On-Demand-Modus zahlen wir pro Anfrage und müssen keine Kapazität planen. Im Provisioned-Modus reservieren wir Lese- und Schreibkapazität im Voraus. Im Hands-on nutzen wir On-Demand.
Analytics auf großen Datenmengen
Eine Auswertung liest wenige Spalten über sehr viele Zeilen. Dafür gibt es OLAP (Online Analytical Processing) und eigene Dienste.
Amazon Redshift ist das Data Warehouse von AWS. Es speichert Daten spaltenbasiert und verteilt Abfragen auf viele Knoten parallel (Massively Parallel Processing). Abgefragt wird mit SQL. In einer Frage erkennen wir Redshift an Stichworten wie „Data Warehouse“, „OLAP“ oder „Business-Analysen über historische Daten“.
Amazon Athena geht einen anderen Weg. Es gibt keinen Cluster, Athena führt SQL-Abfragen direkt auf Dateien in Amazon S3 aus. Abgerechnet wird nach gescannter Datenmenge, laut AWS Whitepaper 5 USD pro TB, mindestens 10 MB pro Abfrage. DDL-Befehle und fehlgeschlagene Abfragen kosten nichts. Das ist eine Momentaufnahme für us-east-1 zum Stand 2026-10-25, Preise ändern sich. Wer die Daten in Spaltenformaten wie Parquet und komprimiert ablegt, scannt weniger und spart laut derselben Quelle 30 bis 90 Prozent. Ein typischer Anwendungsfall sind Logdateien, die AWS-Dienste ohnehin in S3 ablegen, etwa CloudTrail-Logs, Load-Balancer-Logs oder VPC Flow Logs (Athena Doku).
Die übrigen Analytics-Dienste der Prüfung lassen sich über ihre Aufgabe zuordnen:
| Dienst | Aufgabe |
|---|---|
| Amazon EMR | verwaltete Cluster für Big-Data-Frameworks wie Hadoop und Spark |
| AWS Glue | serverloses ETL (Extract, Transform, Load) und Data Catalog, der Tabellenschemata für Athena und andere Dienste beschreibt |
| Amazon Quick Sight | BI-Dashboards und Visualisierungen |
| Amazon Kinesis | Echtzeit-Datenströme (Thema in Teil 07) |
| Amazon OpenSearch Service | Suche und Log-Analysen |
Beim Namen lohnt ein zweiter Blick. Der Exam Guide schreibt inzwischen „Amazon Quick Sight“ mit Leerzeichen, der Dienst ist Teil der neuen Amazon Quick Suite (AWS Blog). Bis zur Umbenennung hieß er Amazon QuickSight.
Den Unterschied zwischen Redshift und Athena merken wir uns über den Betrieb. Redshift ist ein Warehouse, in das wir Daten laden und das dauerhaft läuft. Athena fragt Daten ab, wo sie schon liegen, und kostet nur, wenn wir abfragen.
Spezialdatenbanken und Migration
Für einige Datenformen gibt es eigene Engines:
- Amazon DocumentDB speichert JSON-Dokumente und ist kompatibel zu MongoDB. Steht „MongoDB“ in der Frage, ist das die Antwort.
- Amazon Neptune ist eine Graphdatenbank für stark vernetzte Daten, etwa soziale Netzwerke, Betrugserkennung oder Knowledge Graphs.
Amazon Timestream for LiveAnalytics nimmt seit dem 20. Juni 2025 keine Neukunden mehr an, als Alternative nennt AWS Timestream for InfluxDB (Timestream Doku). Für Amazon Managed Blockchain hat AWS das Ende angekündigt, ab dem 29. Oktober 2026 gibt es keine Neukunden mehr, abgeschaltet wird am 29. September 2027 (Managed Blockchain Doku). Beide stehen nicht in der In-Scope-Liste des Exam Guide und sind damit kaum prüfungsrelevant. Ausdrücklich out of scope sind außerdem Amazon Keyspaces, Amazon MemoryDB und Amazon MSK.
Wer eine bestehende Datenbank nach AWS bringen will, nimmt den AWS Database Migration Service (DMS). Er migriert sowohl homogen (Oracle zu Oracle) als auch heterogen (Oracle zu PostgreSQL), während die Quelldatenbank weiterläuft. Bei heterogenen Migrationen müssen Schema und Code der Datenbank in die neue Engine übersetzt werden. Das übernimmt das AWS Schema Conversion Tool (SCT), das der Exam Guide in Task 3.4 ausdrücklich nennt.
Hands-on
Legen wir eine DynamoDB-Tabelle für Lernkarten an. Der Partition Key thema gruppiert die Karten, der Sort Key frage_id unterscheidet sie innerhalb eines Themas. Wir nutzen den On-Demand-Modus, damit keine Kapazität vorab reserviert wird. Außerhalb des Free Tier können auch kleine Tabellen Kosten erzeugen, deshalb löschen wir die Tabelle am Ende.
aws dynamodb create-table \
  --table-name ccp-demo-lernkarten \
  --attribute-definitions AttributeName=thema,AttributeType=S AttributeName=frage_id,AttributeType=S \
  --key-schema AttributeName=thema,KeyType=HASH AttributeName=frage_id,KeyType=RANGE \
  --billing-mode PAY_PER_REQUEST \
  --region eu-central-1

aws dynamodb wait table-exists --table-name ccp-demo-lernkarten --region eu-central-1
aws dynamodb describe-table --table-name ccp-demo-lernkarten \
  --query 'Table.TableStatus' --region eu-central-1
"ACTIVE"
In der Konsole: DynamoDB → Tables → Create table → Table name, Partition key, Sort key → Create table; mit „Default settings“ ist On-demand bereits voreingestellt.
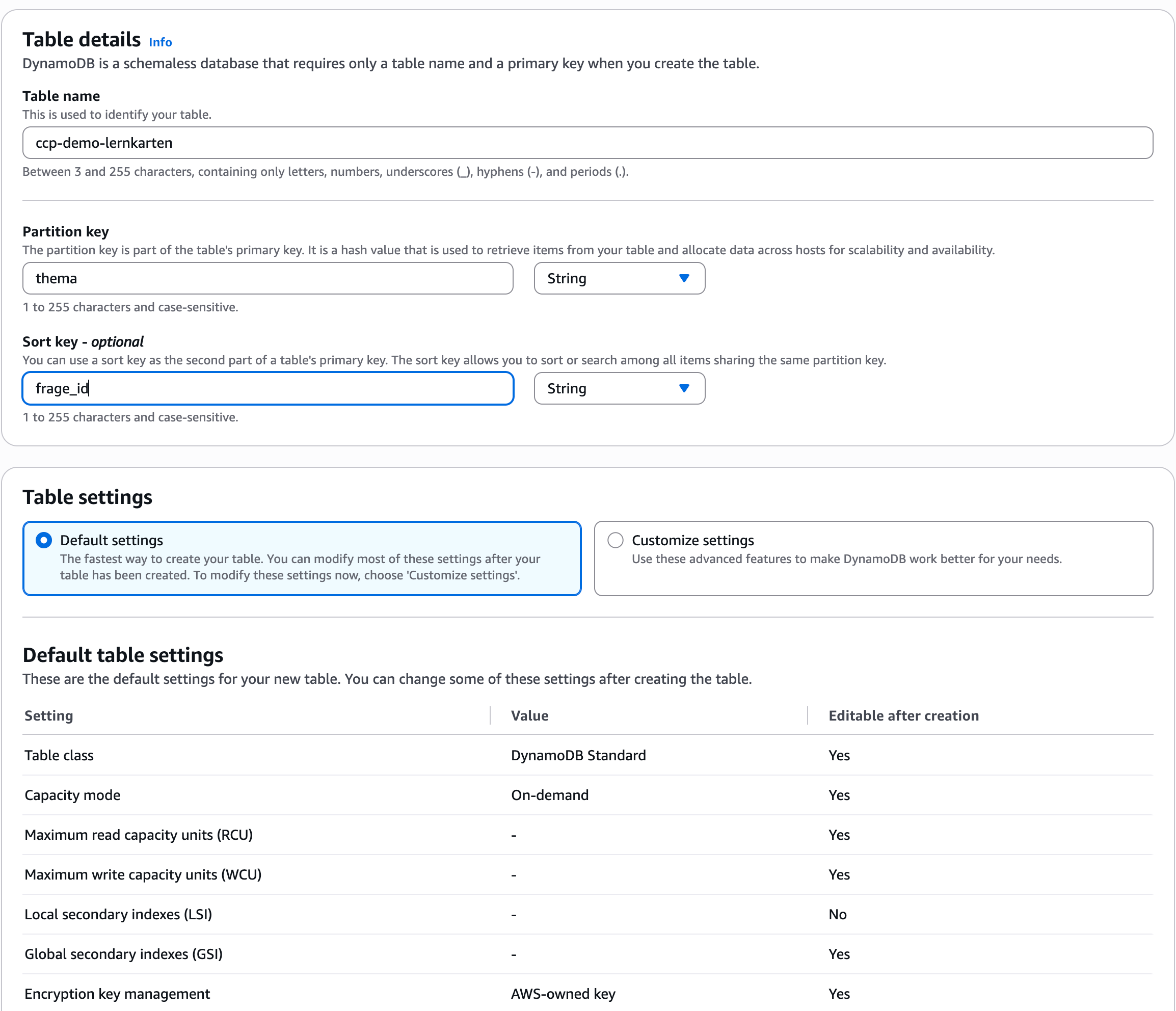
Die Tabelle war nach sechs Sekunden aktiv. Schreiben wir drei Lernkarten hinein, zwei zum Thema Datenbanken und eine zu Security:
aws dynamodb put-item --table-name ccp-demo-lernkarten --region eu-central-1 \
  --item '{"thema":{"S":"Datenbanken"},"frage_id":{"S":"q1"},"antwort":{"S":"Athena"}}'
aws dynamodb put-item --table-name ccp-demo-lernkarten --region eu-central-1 \
  --item '{"thema":{"S":"Datenbanken"},"frage_id":{"S":"q2"},"antwort":{"S":"DAX"}}'
aws dynamodb put-item --table-name ccp-demo-lernkarten --region eu-central-1 \
  --item '{"thema":{"S":"Security"},"frage_id":{"S":"q1"},"antwort":{"S":"CloudTrail"}}'
Jetzt lesen wir eine Karte zweimal, einmal im Standardmodus (eventually consistent) und einmal mit --consistent-read. Mit --return-consumed-capacity meldet DynamoDB, wie viel der Zugriff verbraucht hat:
aws dynamodb get-item --table-name ccp-demo-lernkarten --region eu-central-1 \
  --key '{"thema":{"S":"Datenbanken"},"frage_id":{"S":"q1"}}' \
  --return-consumed-capacity TOTAL --query 'ConsumedCapacity.CapacityUnits'

aws dynamodb get-item --table-name ccp-demo-lernkarten --region eu-central-1 \
  --key '{"thema":{"S":"Datenbanken"},"frage_id":{"S":"q1"}}' \
  --consistent-read \
  --return-consumed-capacity TOTAL --query 'ConsumedCapacity.CapacityUnits'
0.5
1.0
Der konsistente Lesezugriff kostet doppelt so viel. Er garantiert dafür, dass wir den zuletzt geschriebenen Stand sehen. Der Standardmodus kann kurz nach einem Schreibvorgang noch einen älteren Stand liefern. Für die meisten Anwendungen genügt er, und er ist günstiger.
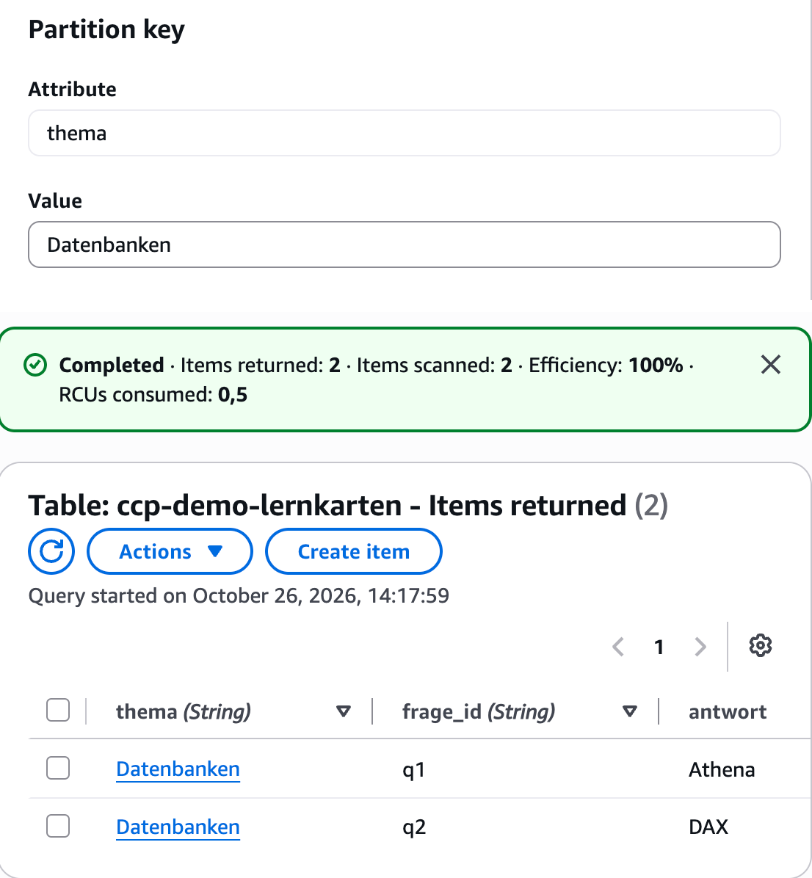
Zum Schluss fragen wir alle Karten eines Themas ab. Eine Query über den Partition Key liefert alle Items mit diesem Schlüssel, sortiert nach dem Sort Key:
aws dynamodb query --table-name ccp-demo-lernkarten --region eu-central-1 \
  --key-condition-expression "thema = :t" \
  --expression-attribute-values '{":t":{"S":"Datenbanken"}}' \
  --return-consumed-capacity TOTAL \
  --query '{Count: Count, CapacityUnits: ConsumedCapacity.CapacityUnits}'
{
    "Count": 2,
    "CapacityUnits": 0.5
}
Zwei Items, eine halbe Capacity Unit. Die Security-Karte bleibt außen vor, weil ihr Partition Key nicht passt.
In der Konsole: DynamoDB → Explore items → Tabelle wählen → Query → Partition key Value → Run.
Aufräumen:
aws dynamodb delete-table --table-name ccp-demo-lernkarten --region eu-central-1
Für die Prüfung
| Stichwort in der Frage | Antwort |
|---|---|
| relationale Datenbank, OLTP, kein Betriebsaufwand | Amazon RDS |
| Zugriff aufs Betriebssystem (SSH) oder Engine, die RDS nicht anbietet | Datenbank auf EC2 |
| MySQL- oder PostgreSQL-kompatibel, cloud-optimiert, Speicher wächst automatisch | Amazon Aurora |
| Aurora bei sporadischer, unvorhersehbarer Last, ohne Kapazitätsplanung | Aurora Serverless |
| Hochverfügbarkeit, automatischer Failover in andere AZ | RDS Multi-AZ |
| Leselast verteilen, Kopie in anderer Region | Read Replicas |
| In-Memory-Cache vor einer Datenbank | Amazon ElastiCache |
| serverlos, NoSQL, Key-Value, Millisekunden | Amazon DynamoDB |
| Cache für DynamoDB, Mikrosekunden | DAX |
| DynamoDB in mehreren Regionen schreibbar | DynamoDB Global Tables |
| Data Warehouse, OLAP, spaltenbasiert | Amazon Redshift |
| Hadoop, Spark | Amazon EMR |
| SQL direkt auf S3, serverlos, Zahlung pro Scan | Amazon Athena |
| ETL, Data Catalog | AWS Glue |
| Dashboards, BI | Amazon Quick Sight |
| MongoDB-kompatibel | Amazon DocumentDB |
| Graph, soziale Netze, Betrugserkennung | Amazon Neptune |
| Datenbank migrieren, Quelle bleibt online | AWS DMS |
| Schema in andere Engine übersetzen | AWS SCT |
Typische Fallen:
- Multi-AZ oder Read Replicas. Multi-AZ ist synchron und dient dem Failover, Read Replicas sind asynchron und dienen dem Lesen.
- ElastiCache statt DAX. Geht es ausdrücklich um einen Cache für DynamoDB, ist DAX die Antwort.
- Redshift statt Athena. Liegen die Daten schon in S3 und soll ohne Infrastruktur abgefragt werden, ist Athena gemeint.
- Logdateien in S3 auswerten. Sollen CloudTrail-, Load-Balancer- oder VPC-Flow-Logs in S3 per SQL ausgewertet werden, ohne Infrastruktur aufzusetzen, ist das ebenfalls Athena.
- SSH auf RDS. Auf das Betriebssystem einer RDS-Instanz kommen wir nicht. Verlangt die Frage SSH oder volle Kontrolle über den Server, läuft die Datenbank auf EC2.
- „Bis zu 15 Read Replicas“ für alle Engines. Oracle und SQL Server erlauben 5, Db2 nur 3.
- Alte Dienstnamen. QuickSight heißt im Exam Guide Quick Sight, Timestream und Managed Blockchain stehen nicht in der In-Scope-Liste.
Quellen
- Exam Guide CLF-C02: https://docs.aws.amazon.com/aws-certification/latest/cloud-practitioner-02/cloud-practitioner-02.html
- Exam Guide, Domain 3 (Task 3.4, 3.7): https://docs.aws.amazon.com/aws-certification/latest/cloud-practitioner-02/cloud-practitioner-02-domain3.html
- In-Scope-Services: https://docs.aws.amazon.com/aws-certification/latest/cloud-practitioner-02/clf-02-in-scope-services.html
- Out-of-Scope-Services: https://docs.aws.amazon.com/aws-certification/latest/cloud-practitioner-02/clf-02-out-of-scope-services.html
- Amazon RDS User Guide: https://docs.aws.amazon.com/AmazonRDS/latest/UserGuide/Welcome.html
- Amazon RDS FAQ: https://aws.amazon.com/rds/faqs/
- AWS CLI,
create-db-instance-read-replica: https://docs.aws.amazon.com/cli/latest/reference/rds/create-db-instance-read-replica.html - Aurora Limits: https://docs.aws.amazon.com/AmazonRDS/latest/AuroraUserGuide/CHAP_Limits.html
- Aurora Replicas: https://docs.aws.amazon.com/AmazonRDS/latest/AuroraUserGuide/aurora-replicas-adding.html
- Aurora Serverless: https://docs.aws.amazon.com/AmazonRDS/latest/AuroraUserGuide/aurora-serverless-v2.html
- ElastiCache, Engine-Auswahl: https://docs.aws.amazon.com/AmazonElastiCache/latest/dg/SelectEngine.html
- DynamoDB Accelerator (DAX): https://docs.aws.amazon.com/amazondynamodb/latest/developerguide/DAX.html
- Amazon Athena im Whitepaper „Big Data Analytics Options“: https://docs.aws.amazon.com/whitepapers/latest/big-data-analytics-options/amazon-athena.html
- Athena, Logs von AWS-Diensten abfragen: https://docs.aws.amazon.com/athena/latest/ug/querying-aws-service-logs.html
- Amazon Quick Suite: https://aws.amazon.com/blogs/business-intelligence/reimagine-business-intelligence-amazon-quicksight-evolves-to-amazon-quick-suite/
- Timestream for LiveAnalytics, Verfügbarkeit: https://docs.aws.amazon.com/timestream/latest/developerguide/AmazonTimestreamForLiveAnalytics-availability-change.html
- Managed Blockchain, Dokumenthistorie: https://docs.aws.amazon.com/managed-blockchain/latest/ethereum-dev/ethereum-developer-guide-doc-history.html
Im nächsten Teil geht es ins Netzwerk, mit VPC, Subnets, Security Groups und den Diensten, die Inhalte weltweit ausliefern.
