AWS Cloud Practitioner 09: Machine Learning und generative KI
Wer bei AWS Machine Learning nutzen will, muss in den meisten Fällen kein Modell trainieren. Die KI-Dienste, die in der Prüfung CLF-C02 vorkommen, sind überwiegend fertig trainierte Modelle hinter einer API, die Text, Bild oder Audio entgegennimmt und ein Ergebnis zurückgibt. Für die Prüfung zählt deshalb nicht, wie die Modelle funktionieren, sondern welcher Dienst zu welcher Aufgabe passt. Generative KI gehört im aktuellen Exam Guide ebenfalls dazu, allerdings mit Amazon Q und nicht mit Amazon Bedrock.
Fertige Modelle statt eigener Data Science
AWS bietet Machine Learning auf zwei Ebenen an. Die obere Ebene sind die vortrainierten AI-Services wie Rekognition, Transcribe oder Comprehend. Wir schicken Daten per API-Aufruf hin und bekommen ein Ergebnis zurück. Server, Trainingsdaten oder Modellwahl sind nicht unser Thema, AWS betreibt das Modell. Das Prinzip kennen wir aus Teil 03 bei Lambda. Wir nutzen eine Fähigkeit und kümmern uns nicht um die Infrastruktur darunter.
Die untere Ebene ist Amazon SageMaker AI. Hier bauen, trainieren und betreiben wir eigene Modelle mit eigenen Daten. Das lohnt sich, wenn kein fertiger Dienst die Aufgabe abdeckt, etwa bei einer Prognose auf Basis firmeneigener Messwerte.
Daneben steht als eigene Gruppe die generative KI. Gemeint sind große Sprachmodelle, die Text erzeugen statt ihn nur zu klassifizieren. Wie ein solches Modell grundsätzlich arbeitet, steht im Artikel Was ist ein Sprachmodell. Für die Prüfung reicht es, Amazon Q als den Assistenten zu kennen, den AWS auf dieser Technik anbietet.
Die Faustregel für Prüfungsfragen lautet deshalb nicht „Welches Modell?“, sondern „Welche Eingabe?“. Sobald klar ist, ob ein Bild, eine Tonaufnahme, ein Text oder ein gescanntes Formular hereinkommt, bleibt meist nur ein Dienst übrig.
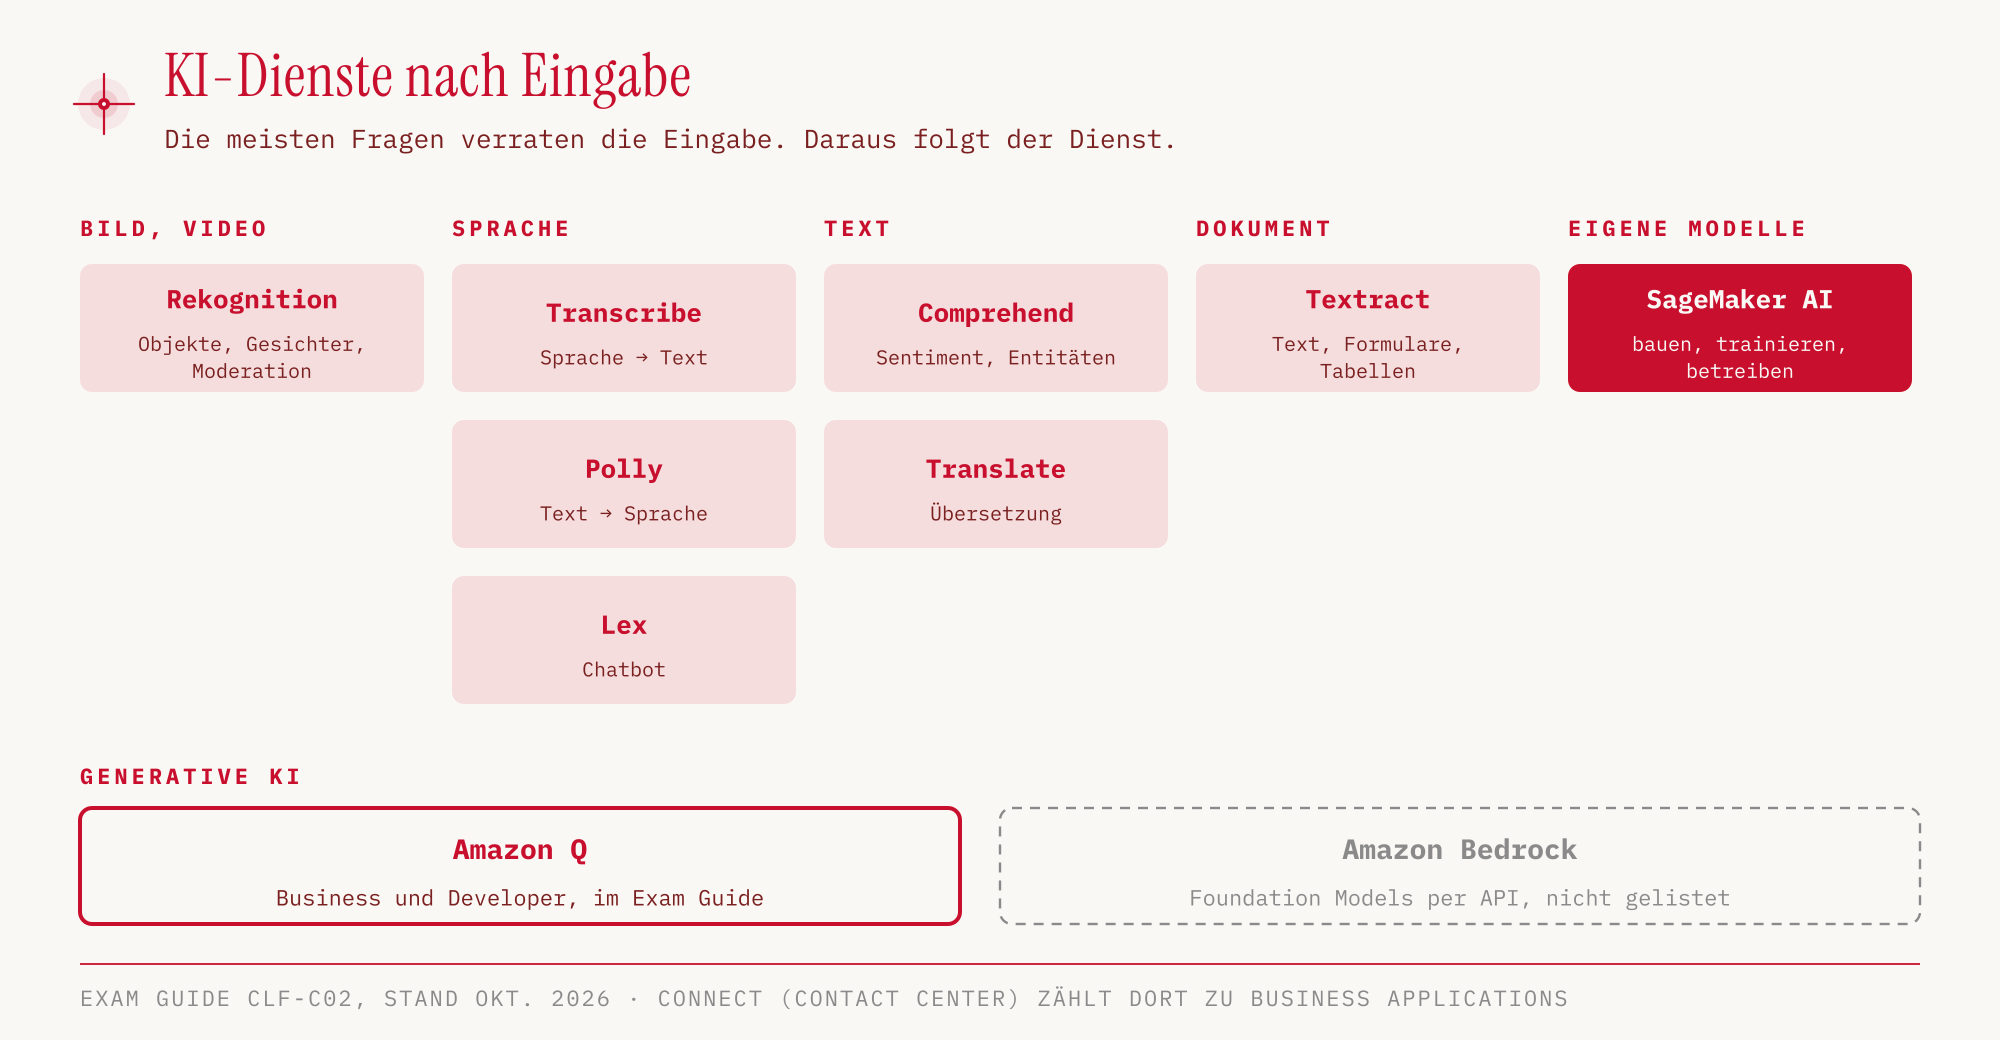
Bild, Sprache, Text und Dokument als Eingabe
Die vortrainierten Dienste lassen sich fast vollständig über ihre Eingabe sortieren. Alle Dienste in der Tabelle stehen in der In-Scope-Liste des Exam Guide, Connect allerdings unter Business Applications statt unter Machine Learning.
| Dienst | Eingabe | Ergebnis | typischer Einsatz |
|---|---|---|---|
| Rekognition | Bild, Video | erkannte Objekte, Gesichter, Moderationshinweise | Fotos verschlagworten, unerwünschte Inhalte erkennen |
| Transcribe | Audio | Text | Untertitel, Gesprächsprotokolle, Schwärzen personenbezogener Daten (PII-Redaction) |
| Polly | Text | gesprochene Sprache | Vorlesefunktion, Sprachansagen |
| Translate | Text | Text in anderer Sprache | Inhalte mehrsprachig ausliefern |
| Comprehend | Text | Stimmung, Entitäten, Themen, Sprache | Kundenfeedback auswerten (NLP) |
| Lex | Text oder Sprache im Dialog | Chatbot-Antworten | Chatbots und Sprachassistenten, gleiche Technik wie Alexa |
| Connect | Telefonanrufe | Cloud-Contact-Center | Callcenter ohne eigene Telefonanlage |
| Textract | Scan, PDF, Foto eines Dokuments | Text, Formularfelder, Tabellen | Rechnungen und Formulare digitalisieren |
Comprehend steht für Natural Language Processing (NLP), also das maschinelle Verstehen von Text. Der Dienst erkennt, ob ein Text positiv, negativ, neutral oder gemischt klingt (Sentiment), welche Personen, Organisationen oder Daten darin vorkommen (Entitäten) und in welcher Sprache er geschrieben ist. Im Hands-on unten probieren wir genau das aus.
Lex und Connect tauchen in Prüfungsfragen gern zusammen auf. Connect ist das Contact Center in der Cloud, Lex liefert den Chatbot, der Anrufer oder Chat-Nutzer im Dialog führt.
Ähnliche Namen, verschiedene Aufgaben
Die meisten Fehler in diesem Prüfungsteil entstehen durch Verwechslungen. Die Namen helfen nur bedingt, deshalb lohnt es sich, die Paare einmal nebeneinander zu legen.
| Verwechslung | Unterschied |
|---|---|
| Transcribe gegen Polly | Transcribe macht aus Sprache Text, Polly macht aus Text Sprache. |
| Transcribe gegen Translate | Transcribe wechselt das Medium (Audio zu Text), Translate wechselt die Sprache (Text zu Text). |
| Textract gegen Comprehend | Textract holt den Text aus einem Dokument heraus, Comprehend analysiert, was im Text steht. |
| Textract gegen Rekognition | Textract liest Dokumente mit Formularen und Tabellen, Rekognition analysiert Bilder und Videos. |
| Lex gegen Connect | Lex ist der Chatbot, Connect ist das komplette Contact Center. |
| AI-Services gegen SageMaker AI | Fertiges Modell per API gegen eigenes Modell mit eigenen Daten. |
In einer typischen Pipeline arbeiten mehrere Dienste hintereinander. Eine eingescannte Kundenbeschwerde liest Textract aus, Translate überträgt sie ins Deutsche, Comprehend bewertet die Stimmung. Jeder Dienst erledigt einen Schritt. Keiner ersetzt den anderen.
Eigene Modelle mit SageMaker AI
Amazon SageMaker AI ist die Plattform für alle, die eigene Machine-Learning-Modelle entwickeln. Der Dienst deckt den Weg vom Aufbereiten der Daten über das Training bis zum Betrieb des fertigen Modells ab. Der Exam Guide verwendet ausdrücklich den Namen „Amazon SageMaker AI“.
Der Unterschied zu den AI-Services ist eine Frage der Verantwortung. Bei Rekognition hat AWS das Modell trainiert, und wir bekommen das, was es kann. Bei SageMaker AI liefern wir Daten und Modellwahl selbst und bekommen dafür ein Modell, das genau unsere Aufgabe löst. In Prüfungsfragen ist das Signal meist eine Formulierung wie „eigene Daten“, „eigenes Modell trainieren“ oder „Data Scientists“. Taucht dagegen eine Standardaufgabe auf, also Gesichter erkennen oder Text übersetzen, ist SageMaker AI fast immer die falsche Antwort.
Generative KI mit Amazon Q, Bedrock nur als Kontext
Die In-Scope-Liste des Exam Guide führt unter Machine Learning Amazon Q, aber nicht Amazon Bedrock (Stand 2026-10-25). Für die Prüfung heißt das, Amazon Q mit seinen Varianten zu kennen.
| Variante | Zweck |
|---|---|
| Amazon Q Business | beantwortet Fragen über Unternehmensdaten |
| Amazon Q Developer | unterstützt beim Programmieren, bei der Fehlersuche und bei der Optimierung von AWS-Ressourcen; hat die Funktionen von Amazon CodeWhisperer übernommen |
Q ist damit ein fertiges Produkt mit Oberfläche und Integration, vergleichbar mit den AI-Services im Abschnitt oben. Wer eine Frage nach einem KI-Assistenten für Entwickler oder für die Suche im eigenen Firmenwissen liest, landet bei Q.
Amazon Bedrock steht eine Ebene tiefer. Der Dienst stellt Foundation Models, also große vortrainierte Sprach- und Bildmodelle verschiedener Anbieter, über eine API bereit, damit wir eigene generative Anwendungen bauen können. Bedrock ist in der Praxis der Baukasten für eigene KI-Anwendungen, steht aber laut Exam Guide nicht in der In-Scope-Liste. Den Namen sollten wir kennen und von Amazon Q unterscheiden können, Detailfragen dazu sind in CLF-C02 nicht zu erwarten.
Dienste außerhalb des Prüfungsstoffs
Einige ML-Dienste sind für CLF-C02 nicht relevant. Amazon Personalize (Empfehlungen in Echtzeit) steht explizit auf der Out-of-Scope-Liste, ebenso Fraud Detector, Lookout for Metrics und Panorama. Amazon Kendra (ML-gestützte Dokumentensuche) fehlt in der In-Scope-Liste. Diese Liste ist laut Exam Guide nicht abschließend. Ausgeschlossen ist Kendra also nicht, in Fragen taucht es aber eher als Ablenker auf.
Umgekehrt fasst Task 3.7 des Exam Guide AI/ML und Analytics zu einer Aufgabe zusammen. Als Analytics-Beispiele nennt er Athena, Kinesis, Glue und Quick Sight. Athena, Glue und Quick Sight haben wir in Teil 05 besprochen, Kinesis in Teil 07. Eine Frage aus diesem Block kann also genauso gut auf einen Analytics-Dienst zielen.
Hands-on
Für Comprehend und Translate brauchen wir nichts anzulegen. Beide Dienste beantworten einzelne API-Aufrufe direkt, es entstehen keine Ressourcen, die wir später löschen müssten. Abgerechnet wird nach Nutzung, außerhalb der kostenlosen Kontingente können also auch diese wenigen Anfragen Kosten erzeugen.
Zuerst die Stimmung eines Satzes, der Lob und Kritik mischt:
aws comprehend detect-sentiment \
  --language-code de \
  --text "Die Prüfung war fair, aber die Fragen zu den Support-Plänen waren verwirrend." \
  --region eu-central-1
{
  "Sentiment": "MIXED",
  "SentimentScore": {
    "Negative": 0.004,
    "Mixed": 0.996,
    ...
  }
}
Comprehend stuft den Satz als gemischt ein, mit einem Score von 0,996. Lob und Kritik heben sich nicht zu „neutral“ auf, sondern ergeben die eigene Kategorie MIXED.
In der Konsole: Amazon Comprehend → Launch Amazon Comprehend → Real-time analysis, Analysis type „Built-in“, Text eingeben, Analyze. Die Konsole zeigt Tabs für Entities, Key phrases, Language, PII, Sentiment, Targeted sentiment und Syntax. Unter „Application integration“ stehen der API-Aufruf (DetectSentiment) und die Antwort.
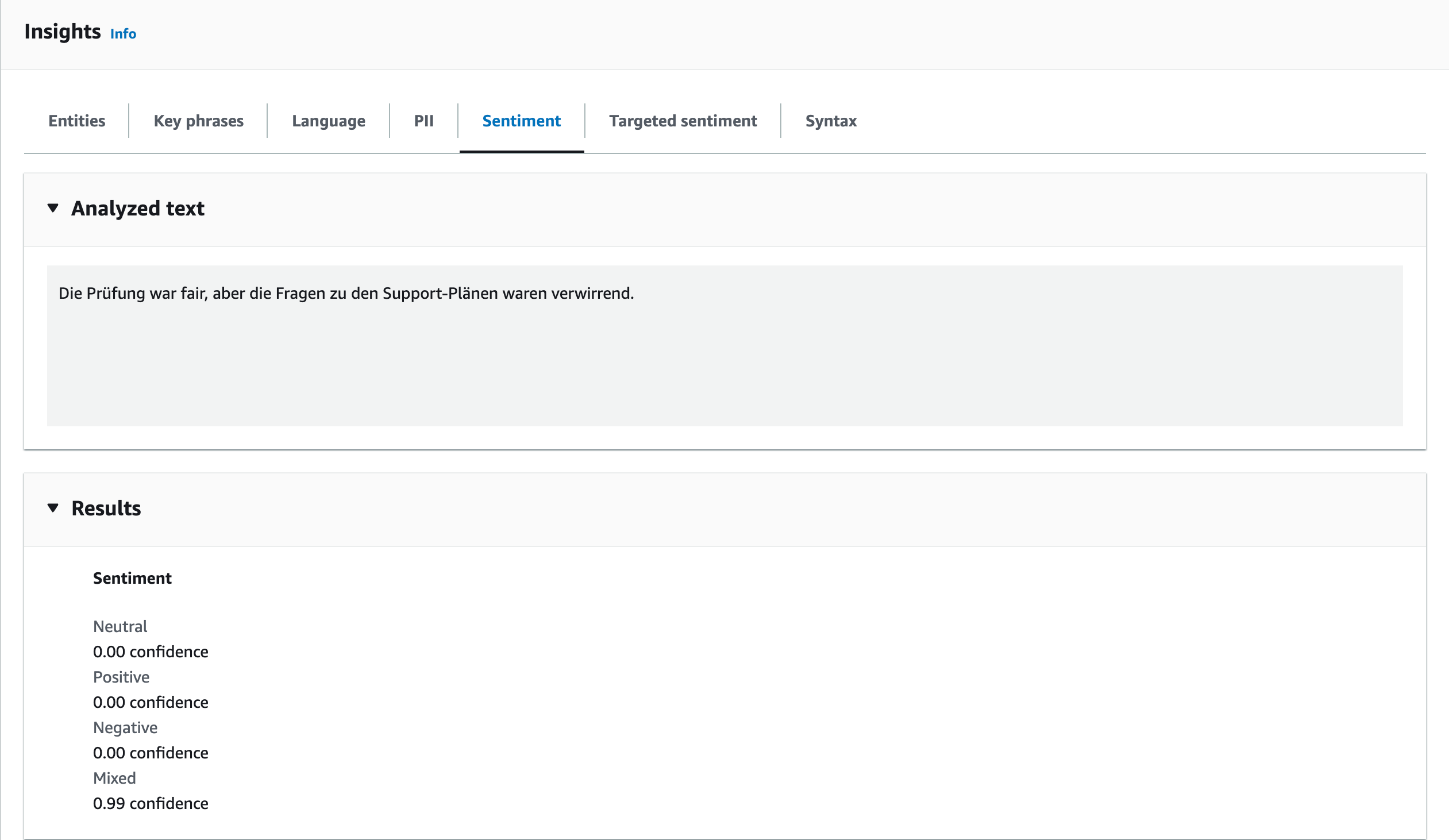
Die Konsole schneidet nach zwei Stellen ab, deshalb steht dort 0.99 statt 0,996.
Als Nächstes die Entitäten:
aws comprehend detect-entities \
  --language-code de \
  --text "AWS bietet die Prüfung CLF-C02 nur noch bis zum 31. Dezember 2026 auf Deutsch an." \
  --region eu-central-1
{
  "Entities": [
    { "Text": "AWS",               "Type": "ORGANIZATION", "Score": 0.79 },
    { "Text": "CLF-C02",           "Type": "OTHER",        "Score": 0.74 },
    { "Text": "31. Dezember 2026", "Type": "DATE",         "Score": 0.99 },
    { "Text": "Deutsch",           "Type": "OTHER",        "Score": 0.97 }
  ]
}
Das Datum erkennt Comprehend mit 0,99, AWS als Organisation mit 0,79. Die Prüfungsbezeichnung und die Sprache landen in der Sammelkategorie OTHER.
Die Spracherkennung braucht keinen Sprachcode, sie soll ihn ja ermitteln:
aws comprehend detect-dominant-language \
  --text "Elasticity heißt, automatisch nach der Last zu skalieren." \
  --region eu-central-1
{
  "Languages": [
    { "LanguageCode": "de", "Score": 0.997 }
  ]
}
Trotz des englischen Fachbegriffs am Satzanfang erkennt Comprehend Deutsch mit 0,997.
Zum Schluss eine Übersetzung mit Translate:
aws translate translate-text \
  --source-language-code de \
  --target-language-code en \
  --text "Ein Subnet ist öffentlich, wenn seine Route Table zum Internet Gateway zeigt." \
  --region eu-central-1
{
  "TranslatedText": "A subnet is public when its route table points to the Internet gateway.",
  ...
}
Die Fachbegriffe übernimmt Translate korrekt, nur die Großschreibung („route table“) folgt dem englischen Satzbau statt dem AWS-Produktnamen.
In der Konsole: Amazon Translate → Real-time translation → Tab Text, Source language „Auto (auto)“, Target language „English (en)“. Die Konsole erkennt die Quellsprache selbst („Detected language: German (de)“). Für Dateien gibt es den Tab Document.
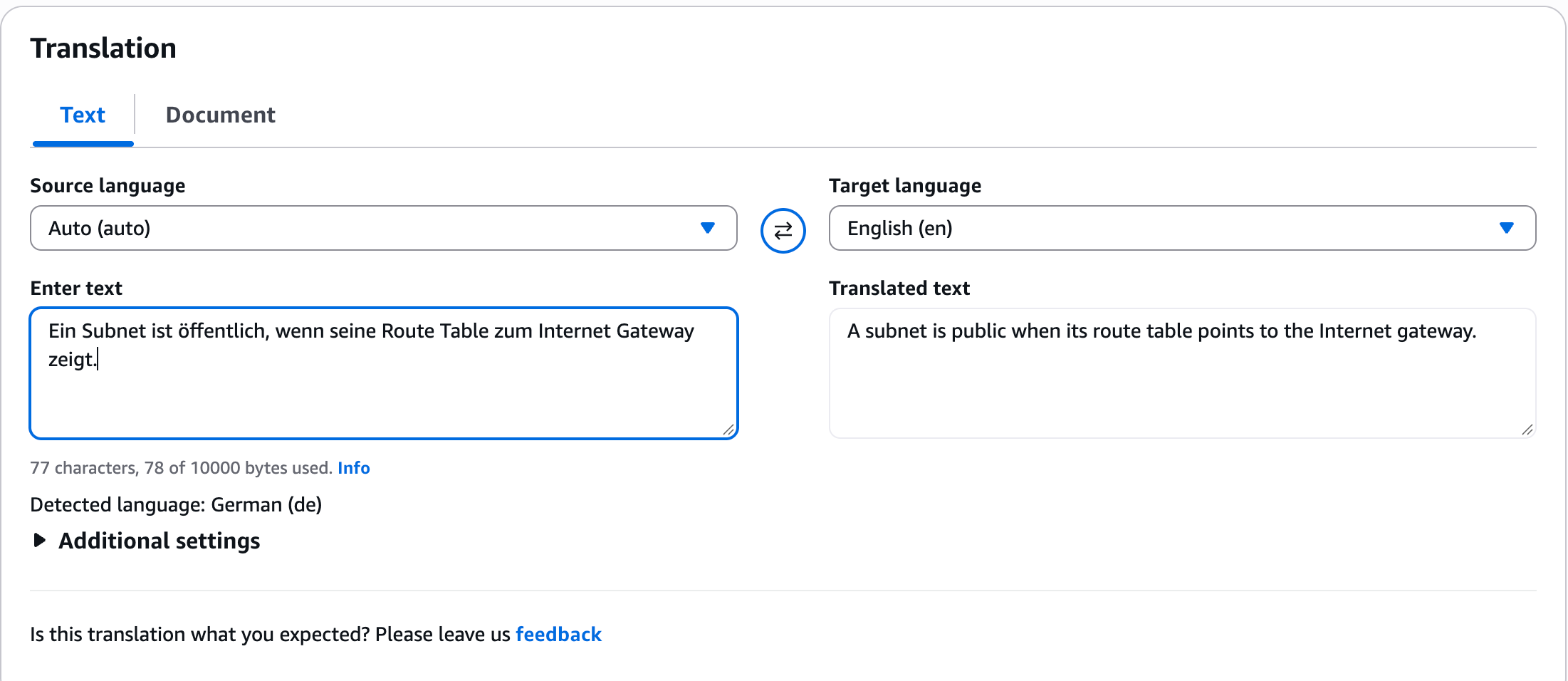
Das Ergebnis ist identisch mit der CLI-Ausgabe.
Die Ausgaben sind gekürzt, die Scores auf zwei bis drei Nachkommastellen gerundet. Aufräumen entfällt, weil keiner der Aufrufe eine Ressource angelegt hat.
Für die Prüfung
| Stichwort in der Frage | Antwort |
|---|---|
| Objekte oder Gesichter in Bildern und Videos, Inhaltsmoderation | Rekognition |
| Sprache in Text umwandeln, Untertitel, Anrufe protokollieren | Transcribe |
| Text vorlesen lassen, Sprachausgabe | Polly |
| Text in eine andere Sprache übersetzen | Translate |
| Stimmung von Kundenbewertungen, Entitäten, NLP | Comprehend |
| Chatbot, Sprachassistent, Alexa-Technik | Lex |
| Contact Center in der Cloud | Connect |
| Text, Formulare und Tabellen aus gescannten Dokumenten | Textract |
| eigenes ML-Modell bauen und trainieren | SageMaker AI |
| generativer KI-Assistent für Entwickler oder Unternehmensdaten | Amazon Q (Developer bzw. Business) |
Typische Fallen:
- Transcribe und Translate verwechseln. Transcribe wandelt Audio in Text, Translate übersetzt Text in eine andere Sprache.
- Textract statt Comprehend wählen. Textract liest Dokumente aus, die Bedeutung des Textes analysiert Comprehend.
- SageMaker AI für Standardaufgaben. Wenn ein fertiger Dienst die Aufgabe abdeckt, ist er die Antwort, nicht ein selbst trainiertes Modell.
- Bedrock als Antwort auf eine Q-Frage. Im Prüfungsstoff steht Amazon Q, Bedrock ist laut In-Scope-Liste nicht gelistet.
- Kendra oder Personalize auswählen. Personalize ist laut Exam Guide out of scope, Kendra steht nicht in der In-Scope-Liste. Beide tauchen allenfalls als Ablenker auf.
Quellen
- AWS Certified Cloud Practitioner (CLF-C02) Exam Guide: https://docs.aws.amazon.com/aws-certification/latest/cloud-practitioner-02/cloud-practitioner-02.html
- Exam Guide, Domain 3 (Task 3.7, AI/ML und Analytics): https://docs.aws.amazon.com/aws-certification/latest/cloud-practitioner-02/cloud-practitioner-02-domain3.html
- In-Scope-Services: https://docs.aws.amazon.com/aws-certification/latest/cloud-practitioner-02/clf-02-in-scope-services.html
- Out-of-Scope-Services: https://docs.aws.amazon.com/aws-certification/latest/cloud-practitioner-02/clf-02-out-of-scope-services.html
- Overview of Amazon Web Services, Machine Learning: https://docs.aws.amazon.com/whitepapers/latest/aws-overview/machine-learning.html
- CodeWhisperer und Amazon Q Developer: https://docs.aws.amazon.com/codewhisperer/latest/userguide/whisper-legacy.html
In Teil 10 geht es ums Geld, um Organizations, Free Plan und Netzkosten, die Kosten-Tools und die neuen Support-Pläne.
