Claude Opus 5.5 im Testlabor: halb so teuer, weil es kürzer denkt
Am 22. September 2026 hat Anthropic Claude Opus 5.5 veröffentlicht. Das Versprechen lautet, Opus 5.5 arbeite auf dem Niveau von Fable 5.1 und koste bei typischen Workloads rund 40 Prozent weniger als Opus 5. Nur die Hälfte davon steckt im Preisschild. Der Rest soll daher kommen, dass das Modell für dieselbe Arbeit weniger Token braucht. Das lässt sich nachmessen, und zwar am selben Tag.
Der Preis sinkt um ein Fünftel
Die Listenpreise sind die einfache Hälfte der Rechnung. Die Tabelle zeigt die Listenpreise von Anthropic in Euro pro Million Token. Anthropic gibt die Preise in US-Dollar an und rechnet auch in Dollar ab. Alle Euro-Beträge in diesem Artikel sind zum EZB-Referenzkurs vom 22. September 2026 umgerechnet (1 € = 1,1463 $, dpa-AFX).
| Opus 5.5 | Opus 5 | Differenz | |
|---|---|---|---|
| Input | 3,49 | 4,36 | −20 % |
| Output | 17,45 | 21,81 | −20 % |
| Cache-Read | 0,17 | 0,44 | −60 % |
| Cache-Write (5 min) | 4,36 | 5,45 | −20 % |
| Batch (Input/Output) | 1,74 / 8,72 | 2,18 / 10,90 | −20 % |
| Fast Mode (Input/Output) | 6,98 / 34,89 | 8,72 / 43,62 | −20 % |
Auffällig ist der Cache-Read. Er fällt um 60 Prozent und kostet nur noch ein Zwanzigstel des normalen Input-Preises. Für lange agentische Sessions, in denen derselbe Kontext bei jedem Schritt wieder gelesen wird, dürfte das mehr ausmachen als der Rest des Preisnachlasses. Das Kontextfenster bleibt laut Anthropic bei einer Million Token, der maximale Output bei 128.000 Token, und der Tokenizer ist derselbe wie bei Opus 5. Token-Zahlen beider Modelle lassen sich also direkt vergleichen.
Den Rest der versprochenen Ersparnis muss das Modell selbst liefern. Um von 80 auf 60 Prozent der bisherigen Kosten zu kommen, braucht es rechnerisch rund ein Viertel weniger Token pro Aufgabe.
Anthropics Benchmarks, gemessen auf höchster Stufe
Die Zahlen unten sind Herstellerangaben, gemessen meist bei Effort max oder xhigh, also bei maximaler Denktiefe.
| Benchmark | Opus 5.5 | Fable 5.1 | Opus 5 |
|---|---|---|---|
| Terminal-Bench 4.0 | 66,4 % | 55,8 % | 52,3 % |
| FrontierCode v1.1 | 54,4 % | 50,3 % | 48,0 % |
| CursorBench 4.0 | 57,8 % | 51,8 % | 46,6 % |
| GDPval-AA v2.1 (Elo) | 1846 | 1735 | 1708 |
| Humanity’s Last Exam (mit Tools) | 67,7 % | 65,6 % | 63,6 % |
| OSWorld 2.0 | 81,8 % | 80,7 % | 74,0 % |
Opus 5.5 liegt damit überall vor Fable 5.1, das mit 8,72 und 43,62 Euro pro Million Input- und Output-Token (Anthropic-Preisliste) zweieinhalbmal so viel kostet. Bei Terminal-Bench 4.0 hat Anthropic laut Fußnote mit aktiven Sicherheitsklassifikatoren gemessen. Wo diese eingriffen, übernahmen Opus 4.8 oder Opus 5 die Aufgabe. Ein Teil der Punkte stammt also nicht von Opus 5.5.
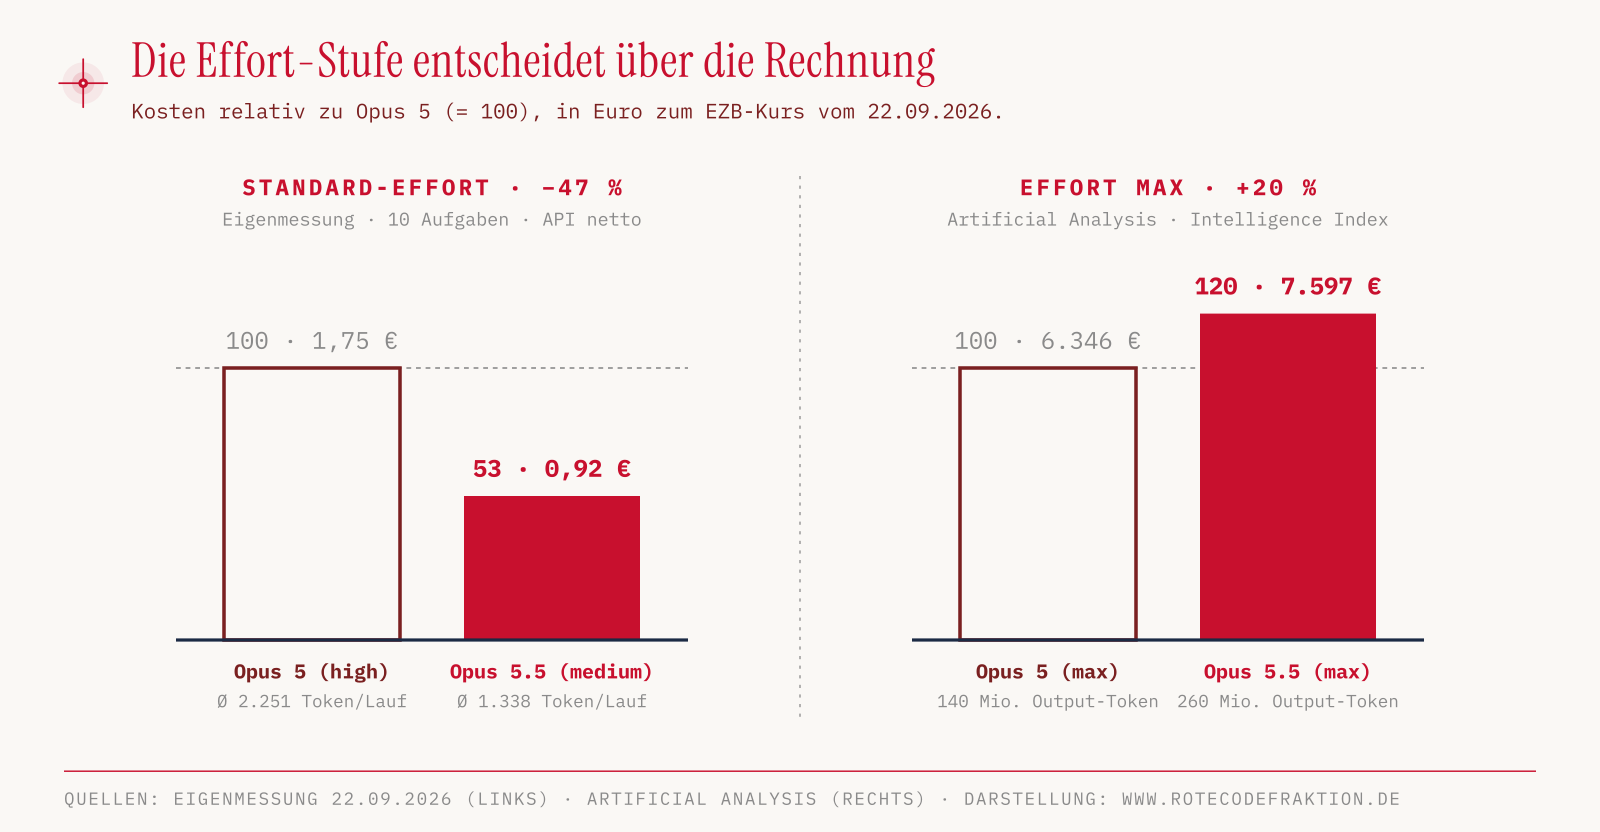
Die erste unabhängige Messung kommt von Artificial Analysis. Dort führt Opus 5.5 auf Effort max den Intelligence Index mit 58 Punkten an, Opus 5 kommt auf derselben Stufe auf 51. Für den Index hat Opus 5.5 dabei 260 Millionen Output-Token erzeugt, Opus 5 nur 140 Millionen. Der Durchlauf kostete umgerechnet 7.597 Euro gegenüber 6.346 Euro bei Opus 5. Auf höchster Stufe ist das neue Modell damit trotz niedrigerer Preise rund 20 Prozent teurer als der Vorgänger.
Die Frage für den Alltag ist deshalb, was in der Standardeinstellung passiert.
Die Standardeinstellung hat sich verschoben
Bei Opus 5.5 lässt sich Thinking nicht mehr abschalten. Die einzige Stellschraube ist die Effort-Stufe (low, medium, high, xhigh, max), die festlegt, wie viel das Modell vor der Antwort nachdenkt. Die Standardstufe ist zudem gesunken. Opus 5 läuft ohne Angabe auf high, Opus 5.5 auf medium.
Anthropic begründet das in der Migrationsdokumentation damit, dass Opus 5.5 auf medium in Coding- und Knowledge-Work-Evaluationen besser abschneide als Opus 5 auf high. Gleichzeitig denke Opus 5.5 auf derselben Stufe länger als Opus 5, vor allem auf xhigh und max. Gleiche Stufennamen würden demnach nicht gleiche Kosten bedeuten.
Wer ein Modell ohne Effort-Angabe aufruft, bekommt dessen Standard. Deshalb lasse ich Opus 5.5 auf medium gegen Opus 5 auf high antreten. Damit sich trennen lässt, was vom Modell kommt und was von der Stufe, läuft Opus 5.5 zusätzlich auf high.
Der Testaufbau
Ich wollte keinen synthetischen Benchmark nachbauen, sondern Aufgaben, wie sie im Arbeitsalltag vorkommen, mit einem Ergebnis, das eine Maschine eindeutig als richtig oder falsch bewerten kann. Es sind zehn Aufgaben geworden, fünf zum Programmieren (C), vier zum Rechnen mit Daten (R) und eine zum Ablesen eines Diagramms (V).
| Aufgabe | Inhalt | Prüfung |
|---|---|---|
| C1 | ISO-8601-Dauern parsen, inklusive 17 ungültiger Eingaben | Asserts |
| C2 | uneingeschränkte Damerau-Levenshtein-Distanz | 307 Fälle gegen Referenz |
| C3 | NRW-Feiertage mit selbst berechnetem Ostersonntag | 13 Jahre gegen Referenz |
| C4 | Arithmetik-Parser ohne eval, mit Pythons Vorrangregeln | 23 Ausdrücke |
| C5 | fehlerhaften LRU-Cache reparieren | Verhaltenstests |
| R1 | Umsatzwachstum pro Region aus 72 CSV-Zeilen | exakter Wert |
| R2 | Jour fixe am letzten Donnerstag 2027, Feiertage verschieben | zwölf Daten |
| R3 | Fehlerquote und Latenzen aus einem Access-Log | exakte Werte |
| R4 | Sessions aus einem Event-Log nach 30-Minuten-Regel | exakte Werte |
| V1 | Balkendiagramm ohne Zahlen ablesen (PNG) | exakte Werte |
Die C-Aufgaben erzeugen Code, der in einem eigenen Prozess gegen Tests läuft. Die R-Aufgaben liefern eine JSON-Antwort, deren Sollwert das Skript aus denselben Daten selbst berechnet.
C2 verlangt ausdrücklich die uneingeschränkte Variante der Damerau-Levenshtein-Distanz, die sich von der verbreiteten „Optimal String Alignment“-Variante unterscheidet ("CA" zu "ABC" ergibt 2 statt 3). R2 enthält genau einen Termin, der auf Fronleichnam fällt. V1 prüft die Angabe von Anthropic, Opus 5.5 lese Diagramme deutlich genauer als Opus 5. Das Diagramm ist ein PNG ohne Beschriftung, das der Testlauf in Python erzeugt.
Jede Aufgabe läuft dreimal pro Konfiguration, insgesamt 90 Aufrufe. Gemessen wird über Claude Code im Headless-Modus:
claude -p "<Aufgabe>" \
  --model claude-opus-5-5 --effort medium \
  --output-format json \
  --safe-mode --strict-mcp-config --tools "" \
  --no-session-persistence \
  --system-prompt "Du löst die gestellte Aufgabe selbstständig und vollständig."
Der Weg über claude -p hat einen praktischen Grund. Er läuft über ein Claude-Abo statt über API-Guthaben, der ganze Test hat mich also nichts extra gekostet. Die JSON-Ausgabe enthält trotzdem alle Token-Zahlen, die Zeit bis zum ersten Token und den Betrag, den derselbe Aufruf zu API-Listenpreisen gekostet hätte.
--safe-mode schaltet eigene Konfiguration, Hooks und Plugins ab, --tools "" alle Werkzeuge. Nur V1 bekommt das Lese-Werkzeug für die Bilddatei. Übrig bleibt ein Aufschlag von rund 700 Token, den Claude Code selbst mitschickt. Der ist für alle Konfigurationen gleich und drückt die prozentualen Unterschiede eher leicht nach unten.
Der komplette Code samt Rohdaten liegt im Repo claude-modellvergleich auf Codeberg. Wer ein Pro- oder Max-Abo hat, kann die Messung ohne API-Key wiederholen. Für künftige Modelle erzeugt der Test auf Wunsch frische Aufgabendaten aus einem neuen Seed, damit kein Modell die Lösungen aus seinen Trainingsdaten kennt.
Für die Kosten weise ich zwei Werte aus. „Claude Code“ ist der Betrag aus der CLI, inklusive der Cache-Writes, die Claude Code bei jedem Aufruf anlegt. „API netto“ rechnet alle Token so ab, als ginge dieselbe Anfrage ohne Caching direkt an die API. Der zweite Wert ist näher an dem, was eine eigene Anwendung zahlen würde.
Gleiche Trefferquote, halbe Rechnung
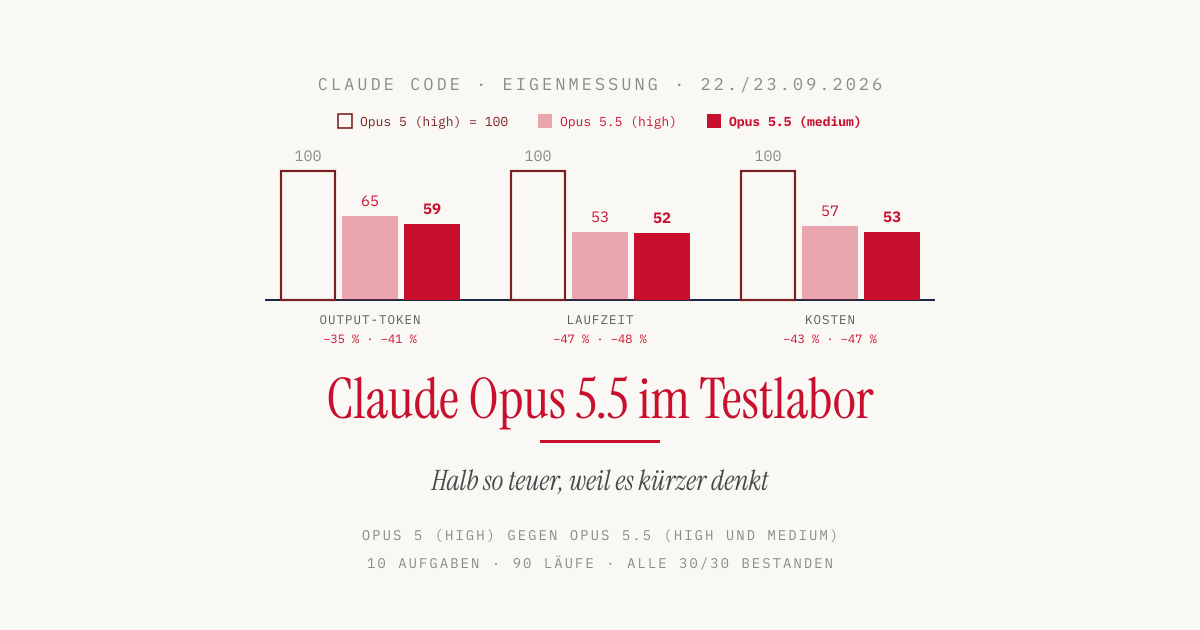
Alle drei Konfigurationen haben alle 30 Läufe bestanden. Die Unterschiede liegen vollständig bei Token, Zeit und Kosten (Eigenmessung, 22. September 2026, Opus 5.5 auf high am Morgen danach). Die Prozentwerte beziehen sich auf Opus 5.
Opus 5 (high) | Opus 5.5 (high) | Opus 5.5 (medium) | |
|---|---|---|---|
| Bestanden | 30 / 30 | 30 / 30 | 30 / 30 |
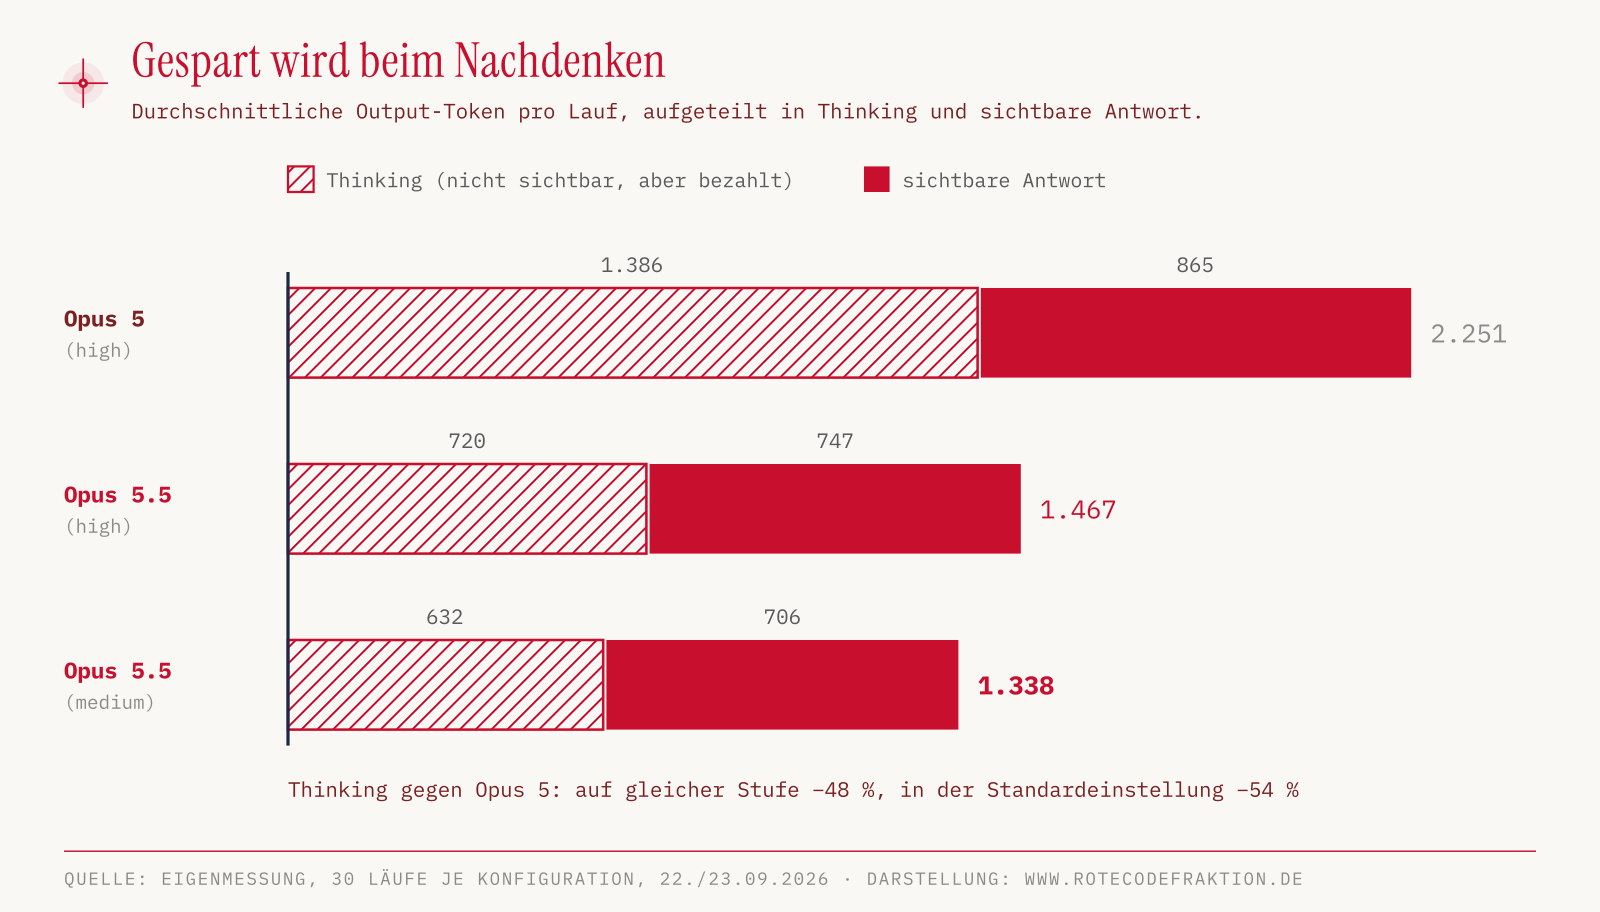
| Output-Token pro Lauf (Ø) | 2.251 | 1.467 (−35 %) | 1.338 (−41 %) |
| davon Thinking (Ø) | 1.386 | 720 (−48 %) | 632 (−54 %) |
| Dauer (Median) | 21,4 s | 11,4 s (−47 %) | 11,1 s (−48 %) |
| Zeit bis zum ersten Token (Median) | 14,2 s | 5,9 s (−58 %) | 5,5 s (−61 %) |
| Kosten Claude Code (30 Läufe) | 1,96 € | 1,16 € (−41 %) | 1,09 € (−44 %) |
| Kosten API netto (30 Läufe) | 1,75 € | 0,99 € (−43 %) | 0,92 € (−47 %) |
| API netto pro gelöster Aufgabe | 5,8 ct | 3,3 ct | 3,1 ct |
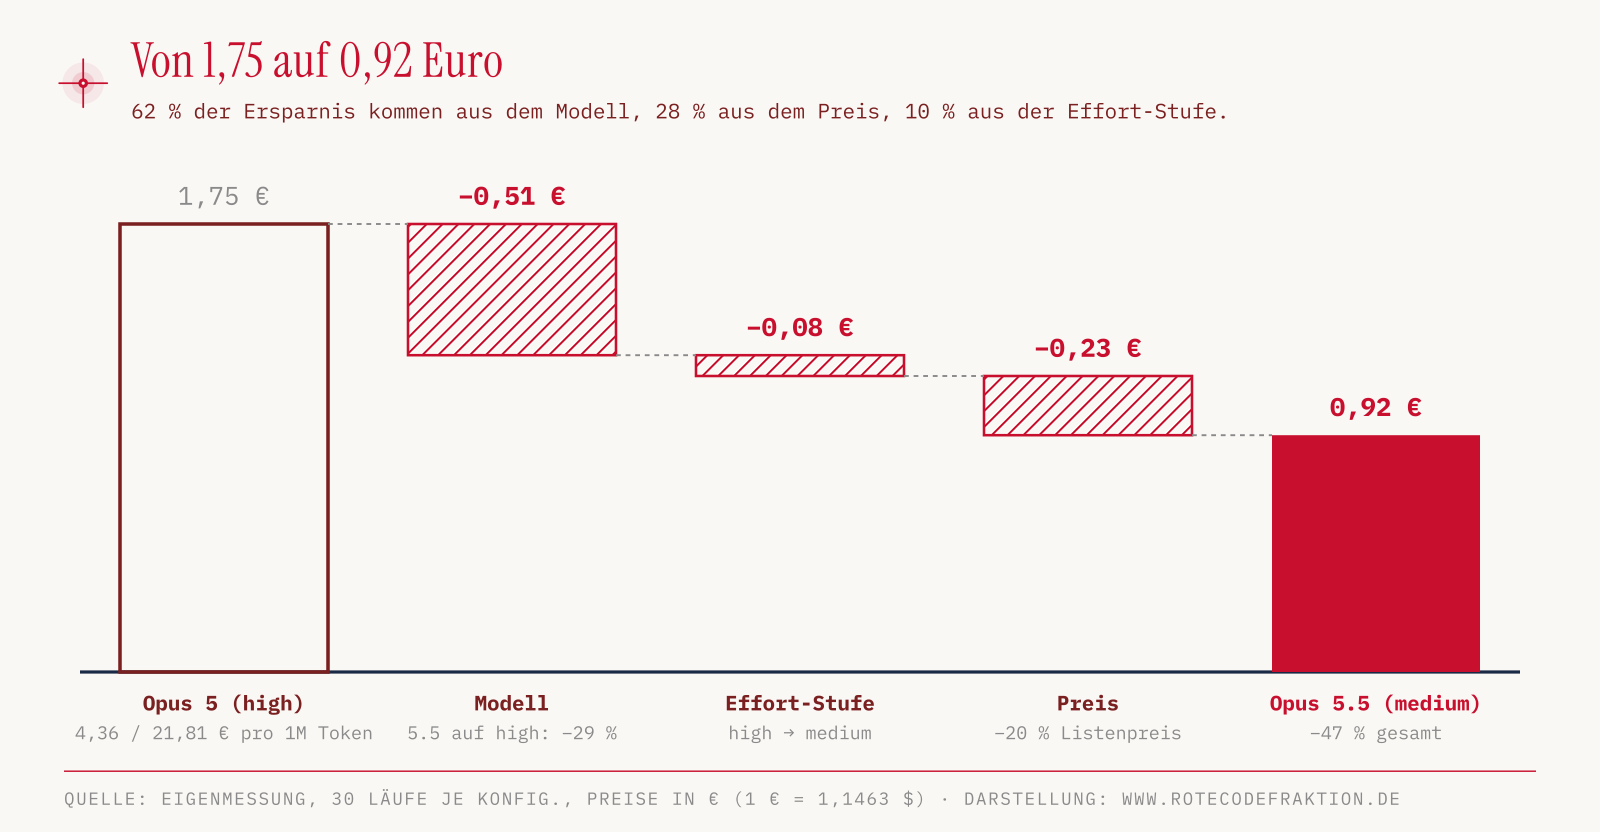
Der Vergleich der Standardeinstellungen ergibt 47 Prozent weniger Kosten. Die zusätzliche Konfiguration zeigt, woher sie kommen. Zu den Preisen von Opus 5 hätte Opus 5.5 auf high 1,24 Euro gekostet, 29 Prozent weniger als Opus 5 auf derselben Stufe. Das ist der Anteil des Modells. Der Schritt auf medium spart weitere 0,08 Euro, der 20 Prozent niedrigere Listenpreis 0,23 Euro. Von den 0,83 Euro Ersparnis kommen damit 62 Prozent aus dem Modell, 28 Prozent aus dem Preis und 10 Prozent aus der niedrigeren Standardstufe. Anthropics „40 Prozent weniger“ ist auf diesen Aufgaben eher zurückhaltend formuliert.
Gut vier Fünftel der eingesparten Token entfallen auf das Thinking. Opus 5 verbringt 62 Prozent seiner Output-Token mit Nachdenken, Opus 5.5 auf medium nur 47 Prozent. Auch auf gleicher Stufe denkt Opus 5.5 mit 720 Token fast nur halb so lang wie Opus 5 mit 1.386. Anthropics Aussage, Opus 5.5 denke auf derselben Stufe länger, trifft auf diese Aufgaben also nicht zu. Für xhigh und max, auf die Anthropic sich vor allem bezieht, passt sie zu den Zahlen von Artificial Analysis. Die sichtbare Antwort ist bei Opus 5.5 knapp ein Fünftel kürzer. Das erklärt auch die Wartezeit. Bis das erste Token der Antwort kommt, vergehen bei Opus 5 im Median 14,2 Sekunden, bei Opus 5.5 5,5 Sekunden. In der Praxis fällt genau das zuerst auf.
Eine Angabe von Anthropic konnte ich nicht bestätigen. Laut Release-Post erzeugt Opus 5.5 seinen Output mehr als 30 Prozent schneller als Opus 5. In meinen Läufen lag der Durchsatz bei allen drei Konfigurationen zwischen 250 und 280 Token pro Sekunde (Output-Token geteilt durch die Zeit nach dem ersten Token, Median der Einzelläufe, 278 für Opus 5, 247 und 266 für Opus 5.5 auf high und medium). Die halbierte Laufzeit kommt nicht von schnellerer Generierung, sondern von weniger Token. Die Messung ist dafür allerdings grob, weil sie das verborgene Thinking mitzählt und am Launch-Tag und am Morgen danach entstand, als die Server vermutlich stark ausgelastet waren.
Die Ersparnis schwankt je nach Aufgabe
Pro Aufgabe (Durchschnitt aus drei Läufen, Output-Token und Dauer; die letzte Spalte vergleicht die beiden Standardeinstellungen):
| Aufgabe | Opus 5 (high) | Opus 5.5 (high) | Opus 5.5 (medium) | weniger Output |
|---|---|---|---|---|
| C1 ISO-Dauer | 1.259 Tok, 14 s | 916 Tok, 8 s | 676 Tok, 6 s | −46 % |
| C2 Damerau-Levenshtein | 2.130 Tok, 20 s | 1.037 Tok, 8 s | 965 Tok, 8 s | −55 % |
| C3 Feiertage | 2.996 Tok, 31 s | 2.136 Tok, 18 s | 1.789 Tok, 14 s | −40 % |
| C4 Parser | 1.928 Tok, 20 s | 1.655 Tok, 13 s | 1.524 Tok, 12 s | −21 % |
| C5 LRU-Fix | 1.010 Tok, 11 s | 729 Tok, 7 s | 617 Tok, 6 s | −39 % |
| R1 Umsatz | 3.369 Tok, 29 s | 2.332 Tok, 18 s | 2.177 Tok, 16 s | −35 % |
| R2 Kalender | 3.181 Tok, 32 s | 1.400 Tok, 11 s | 1.299 Tok, 10 s | −59 % |
| R3 Log | 2.184 Tok, 20 s | 1.501 Tok, 11 s | 1.299 Tok, 11 s | −41 % |
| R4 Sessions | 2.820 Tok, 25 s | 1.788 Tok, 13 s | 1.845 Tok, 13 s | −35 % |
| V1 Diagramm | 1.630 Tok, 19 s | 1.174 Tok, 11 s | 1.192 Tok, 11 s | −27 % |
Die Spanne reicht von 21 Prozent beim Parser bis 59 Prozent beim Kalender. Bei der Kalenderaufgabe ist der Abstand am größten, Opus 5.5 kommt mit 59 Prozent weniger Output zum selben Ergebnis. Beim Parser ist der Code selbst der größte Teil der Antwort, dort bleibt weniger zu sparen. Kein einziger der 30 Läufe von Opus 5.5 auf medium war teurer als der günstigste Lauf von Opus 5 auf derselben Aufgabe.
Das Diagramm aus V1 haben beide Modelle in allen Läufen richtig gelesen. Einen Unterschied in der Lesegenauigkeit zeigt das einfache Balkendiagramm damit nicht. Opus 5.5 brauchte gut ein Viertel weniger Token, das liegt aber unter seiner durchschnittlichen Ersparnis.
Beim Auswerten fiel zunächst ein Fehlschlag von Opus 5 auf. Der Parser-Code bestand alle Tests, wurde aber als unzulässig verworfen. Die Ursache lag in meinem Prüfer. Die Sperrliste gegen compile( hatte auch ein harmloses re.compile( erwischt. Nach der Korrektur haben alle Konfigurationen 30 von 30 Läufen bestanden. Das Auswertungsskript bewertet deshalb alle gespeicherten Antworten bei jedem Lauf neu, damit solche Korrekturen ohne neue Modellaufrufe greifen.
medium reicht für Routinearbeit
Der Schritt von high auf medium spart bei Opus 5.5 wenig, kostet aber auch keine Qualität. Beide Stufen haben alle 30 Läufe bestanden. medium braucht 9 Prozent weniger Output-Token, 12 Prozent weniger Thinking und ist 7 Prozent billiger, die Laufzeit unterscheidet sich um drei Zehntelsekunden. Bei R4 und V1 lag medium sogar knapp über high, der Abstand zwischen den Stufen liegt dort im Rauschen.
Die Effort-Stufe legt fest, wie lange das Modell vor der Antwort überlegt. Bei Aufgaben mit klarem Lösungsweg, etwa einen Parser zu schreiben, Daten zu aggregieren oder einen bekannten Algorithmus umzusetzen, findet längeres Überlegen offenbar nichts, was die kürzere Variante übersieht. Das ist meine Folgerung aus den Zahlen, gemessen ist nur, dass high hier keinen Vorteil bringt. Anthropic empfiehlt in der Migrationsdokumentation dasselbe Vorgehen: mit medium beginnen und xhigh oder max nur dort einsetzen, wo ein Qualitätsgewinn gemessen ist.
Wo höhere Stufen sich lohnen, zeigt dieser Test nicht. Laut Anthropic sind das lange agentische Coding-Aufgaben über große Codebasen und schwere Probleme, an denen auch die Standardstufe scheitert. Für die tägliche Arbeit, die aus vielen solchen kleinen Aufgaben besteht, ist medium nach diesen Zahlen die richtige Voreinstellung. Wer bei einzelnen Aufgaben mehr braucht, stellt die Stufe gezielt für diese hoch.
Zu leichte Aufgaben, keine Agenten-Läufe
Die Aufgaben waren für beide Modelle zu leicht, um Qualitätsunterschiede zu messen. Bei 100 Prozent auf beiden Seiten gibt es keinen Abstand. Der Test beantwortet deshalb nur die Frage, was dieselbe richtige Antwort kostet, nicht, welches Modell bei schweren Aufgaben weiter kommt. Dafür bräuchte es Aufgaben, an denen Opus 5 scheitert.
Außerdem sind es Einzelaufrufe, keine agentischen Läufe über viele Schritte, in denen laut Anthropic die größten Gewinne liegen und in denen der billigere Cache-Read erst richtig wirkt. Drei Wiederholungen pro Aufgabe sind wenig, auch wenn die Streuung klein war. Zudem stammt die Messung vom Launch-Tag und vom Morgen danach.
Vier Änderungen an der API
Wer Opus 5.5 über die API anspricht, findet die Änderungen in Anthropics Migrationsdokumentation.
- Thinking bleibt an.
thinking: {type: "disabled"}liefert einen 400-Fehler, auf jeder Effort-Stufe. Wer bei Opus 5 Thinking für schnelle Antworten abgeschaltet hat, stellt aufeffort: "low"um. - Der Standard ist
medium. Code, der keine Effort-Stufe setzt, läuft bei Opus 5.5 eine Stufe tiefer als bei Opus 5. Nach meinen Zahlen ist das kein Nachteil, aber die Stufe gehört explizit in den Request. - Erzwungene Tool-Aufrufe fallen weg.
tool_choicemitanyoder einem festen Tool liefert einen 400-Fehler. Ersatz istautomit einer klaren Anweisung im Prompt undstrict: trueam Tool. - Thinking-Blöcke sind an Modell und Verlauf gebunden. Für Konten, die ab dem 31. August 2026 angelegt wurden, prüft die API, ob der bisherige Gesprächsverlauf unverändert ist. Wer den Verlauf nachträglich editiert, etwa beim Zusammenfassen alter Nachrichten, bekommt einen Fehler.
Für Abonnenten von Pro, Max und Team hat Anthropic laut Release-Post die Nutzungslimits angehoben. In Claude Code wechselt /model auf das neue Modell.
Fazit
Die Rechnung von Anthropic geht in meinem Test auf, sogar etwas besser als versprochen. Opus 5.5 löst in seiner Standardeinstellung dieselben Aufgaben wie Opus 5 in dessen Standardeinstellung, mit 41 Prozent weniger Output, in der halben Zeit und für 47 Prozent weniger Geld. Knapp zwei Drittel der Ersparnis kommen aus dem Modell selbst, das schon auf gleicher Stufe etwa halb so lange nachdenkt, ohne dabei danebenzuliegen. Der Preisnachlass bringt gut ein Viertel, die niedrigere Standardstufe den Rest.
Die Einschränkung steht bei Artificial Analysis. Auf max erzeugt Opus 5.5 fast doppelt so viele Token wie Opus 5 und kostet am Ende mehr als der Vorgänger. Auf medium und high denkt das Modell sparsamer als sein Vorgänger, auf der höchsten Stufe verschwenderischer. Wer Opus 5.5 aus Gewohnheit auf max stellt, zahlt mehr als vorher.
Am billigsten ist das Token, das gar nicht erst gedacht wird.
Quellen
- Anthropic, Release-Post „Introducing Claude Opus 5.5“ (Preise, Benchmarks, Herstellerangaben): anthropic.com/claude-opus-5-5
- Anthropic, Migrationsdokumentation (Effort-Standard, Änderungen an der API): platform.claude.com/docs/en/about-claude/models/migration-guide
- EZB-Referenzkurs vom 22.09.2026 (1 € = 1,1463 $), dpa-AFX via finanzen.at: finanzen.at
- Anthropic, Preisliste (Fable 5.1): platform.claude.com/docs/en/about-claude/pricing
- Artificial Analysis, Opus 5.5 auf
max(Intelligence Index, Token, Kosten): artificialanalysis.ai/models/claude-opus-5-5 - Artificial Analysis, Opus 5 auf
maxzum Vergleich: artificialanalysis.ai/models/claude-opus-5 - Eigenmessung: 90 Läufe über Claude Code 2.1.280, 22. und 23. September 2026, Code und Rohdaten: codeberg.org/rotecodefraktion/claude-modellvergleich