colibri im Test: Ein 744B-Modell auf einem Mac mit 64 GB
GLM-5.2 hat 744 Milliarden Parameter. Selbst in int4 wären das rund 370 GB, der Download im colibri-Format umfasst 429 GB. Mein MacBook Pro hat 64 GB RAM. colibri, eine Inference-Engine in reinem C von Vincenzo Fornaro, lässt so ein Modell trotzdem laufen, laut README sogar auf einem Laptop mit 25 GB RAM. Der Trick ist simpel. Bei einem Mixture-of-Experts-Modell rechnet pro Token nur ein kleiner Teil der Gewichte mit, und colibri lädt genau diesen Teil von der Platte, wenn er gebraucht wird.
Ich wollte wissen, wie sich das auf einem MacBook Pro mit M3 Max und 64 GB anfühlt. Die interne SSD war zu voll, also lagen alle Modelle auf einer externen USB-SSD. Getestet habe ich drei Modelle in drei Größen und einen Vergleich mit MLX. Für die beiden kleineren Modelle habe ich später Platz geschaffen und von der internen SSD gegengemessen.
Experten auf der Platte, der Rest im RAM
Ein Mixture-of-Experts-Modell (MoE) teilt seine Feed-Forward-Schichten in viele kleine Teilnetze, die Experten. Ein Router wählt pro Token und Schicht wenige davon aus. GLM-5.2 hat laut README 744 Milliarden Parameter, nutzt pro Token etwa 40 Milliarden, und nur rund 11 GB davon wechseln von Token zu Token. Das sind die gerouteten Experten.
colibri behält den dichten Teil im RAM, also Attention, Embeddings und die geteilten Experten. Die gerouteten Experten bleiben auf der Platte und werden gelesen, sobald der Router sie anfordert. Ein LRU-Cache hält die zuletzt benutzten Experten pro Schicht im Speicher und verdrängt zuerst die, die am längsten unbenutzt sind, und eine Nutzungsstatistik (.coli_usage) pinnt die häufigsten dauerhaft. Pro Modellfamilie gibt es eine eigene C-Datei. Die Engine selbst braucht außer OpenMP nichts, Launcher und API-Server laufen in Python.
Das Modell muss also nicht in den schnellen Speicher passen. Es muss nur gut verteilt sein. Daraus folgt auch der Engpass. Jeder Experte, der nicht im Cache liegt, kommt von der Platte.
Das Setup auf dem Mac
Das Projekt steht unter Apache 2.0, getestet habe ich Version 2.0.0 (Commit bf244291). Für macOS nennt das README fünf Befehle:
xcode-select --install
brew install libomp git python
git clone https://github.com/JustVugg/colibri
cd colibri
./start-here.sh
Das Setup-Skript prüft RAM, freien Plattenplatz und GPU, schlägt ein passendes Modell vor, baut die Engine und lädt das Modell mit Fortschrittsanzeige und Wiederaufnahme. Ich habe es direkt aufgerufen, um Modell und Zielverzeichnis vorzugeben:
c/coli setup --yes --model qwen36-35b \
  --dir "/Volumes/Extreme SSD/models/colibri" --no-start --no-browser
Mit dem Python von python.org scheiterte der Download an CERTIFICATE_VERIFY_FAILED, weil dieser Installer seine Zertifikate nicht automatisch einrichtet. SSL_CERT_FILE=/etc/ssl/cert.pem vor dem Aufruf löst das. Das libomp aus der Befehlsliste sollte man nicht weglassen, ohne baut die Engine nur single-threaded.
Das Setup meldet „GPU none found" und baut alle Engines für die CPU. Ein Metal-Backend für die GPU des Mac gibt es trotzdem. Laut Makefile lassen sich unter anderem die Engines für GLM-5.2 und Qwen3.6 damit bauen, die für Qwen3.8 nicht. Bei einem Build aus den Quellen muss man selbst mit METAL=1 bauen und zur Laufzeit COLI_METAL=1 setzen. Das fertige macOS-Archiv der Releases enthält die GLM-Engine bereits mit Metal. Metal habe ich nur bei GLM-5.2 getestet, alle Qwen-Messungen liefen auf der CPU.
Achtmal langsamer lesen
Bevor es an die Modelle ging, habe ich mit dem mitgelieferten iobench gemessen, wie schnell beide Platten zufällige Blöcke in Expertengröße lesen:
| Platte | Blockgröße | Lesetempo |
|---|---|---|
| Interne SSD (M3 Max) | 0,75 MB | 6,25 GB/s |
| Interne SSD (M3 Max) | 19 MB | 6,66 GB/s |
| SanDisk Extreme SSD (USB) | 2,64 MB | 0,84 GB/s |
| SanDisk Extreme SSD (USB) | 4,69 MB | 0,86 GB/s |
Die interne SSD liegt bei kleinen wie großen Blöcken über 6 GB/s und ist damit sieben- bis achtmal schneller. Laut colibri-Doku können solche Messungen unter macOS vom Dateicache geschönt sein, der Abstand ist aber in jedem Fall groß. Für eine Engine, die bei jedem Cache-Fehlschlag auf die Platte wartet, sah das nach dem wichtigsten Wert im ganzen Test aus. Wie wenig davon beim Tempo ankommt, zeigt der Gegentest weiter unten. Bis dahin gelten alle Zahlen für die USB-SSD.
Qwen3.6-35B-A3B: der kleine Einstieg
Für meinen Mac empfahl das Setup Qwen3.6-35B-A3B mit 35 Milliarden Parametern, von denen pro Token rund 3 Milliarden aktiv sind. Der Download umfasst 23 GB, das Modell liegt bereits in einem int4-Format für colibri vor. Das Setup plante mit 85 Experten pro Schicht im Cache und einer Trefferquote von 33 Prozent. Gemessen habe ich mit einem kleinen Skript gegen die OpenAI-kompatible API, Prompt „Erkläre in fünf Sätzen, was ein Mixture-of-Experts-Modell ist.", jeweils rund 165 Tokens Antwort.
Decode meint in den Tabellen das Tempo nach dem ersten Token. Die Zeit bis zum ersten Token enthält den Prefill, also das Einlesen des Prompts.
| Konfiguration | Decode | Erstes Token |
|---|---|---|
coli serve ohne --cap, 8 Experten pro Schicht | 2,1 bis 2,4 tok/s | 15 bis 20 s |
--cap 256, alle Experten im RAM | 4,6 tok/s (1. Lauf) bis 7,3 tok/s (ab 3. Lauf) | etwa 4 s (warm) |
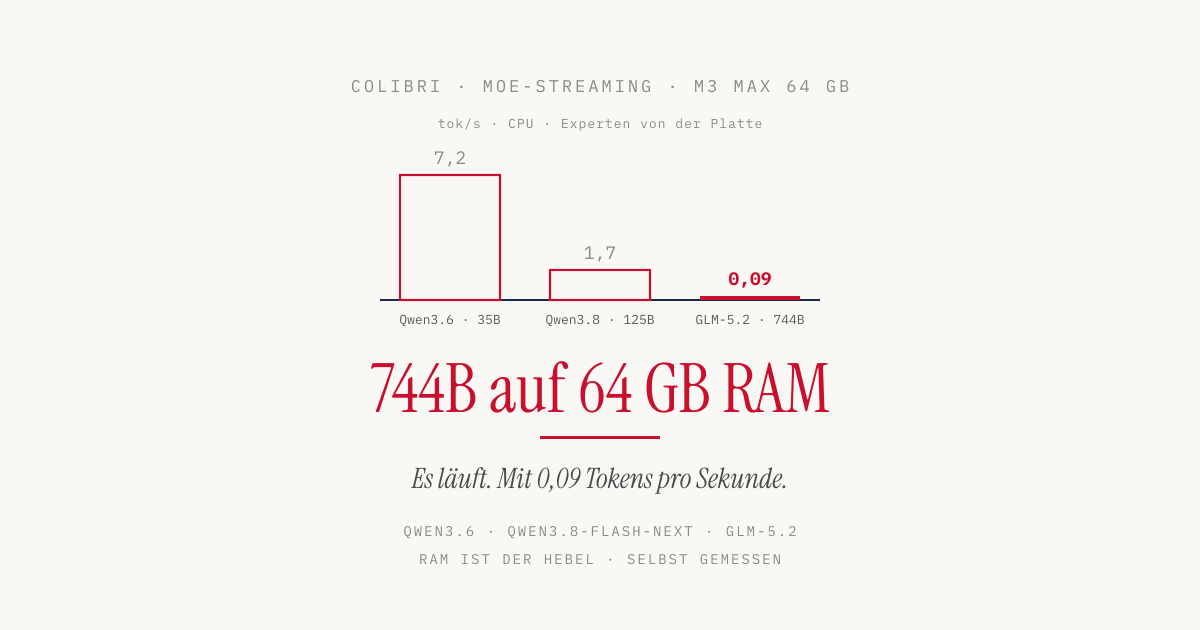
Den Plan des Setups übernimmt coli serve nicht. Ohne --cap startet der Server mit 8 von 256 Experten pro Schicht, colibri muss also ständig nachladen. Mit --cap 256 passen alle 256 Experten pro Schicht in den Cache, und nach dem dritten Durchlauf liegt das Tempo stabil bei etwa 7,2 Tokens pro Sekunde. Das passt zu den 6,0 tok/s, die das README für einen Ryzen-Desktop auf der CPU angibt. Ein Code-Prompt (Primzahlfunktion in Python, 317 Tokens) kam auf 5,4 tok/s. Die Antworten waren in beiden Fällen korrekt.
Den Parameter --ram reicht der Launcher an die Qwen-Engine nicht weiter, in meinen Läufen blieb der Cache damit bei 8. Erst --cap hat ihn vergrößert.
Der Vergleich mit MLX
Qwen3.6-35B-A3B passt in 4 Bit komplett in den Speicher eines 64-GB-Macs. Damit lässt sich direkt gegen MLX mit dem Modell mlx-community/Qwen3.6-35B-A3B-4bit messen, gestartet über mlx_lm.server (mlx-lm 0.32.2).
| Engine | Decode | Erstes Token (warm) | Code-Prompt |
|---|---|---|---|
| colibri, CPU, alle Experten im RAM | 7,2 tok/s | etwa 4 s | 5,4 tok/s |
| MLX 4-Bit, GPU | 73,5 bis 75,7 tok/s | 0,04 bis 0,10 s | 71,8 tok/s |
MLX ist zehnmal schneller. Den größten Teil davon dürfte die GPU ausmachen, die colibri in diesem Test nicht genutzt hat, weil das Setup nur für die CPU baut. Mit Metal habe ich die Qwen-Engine nicht gemessen. Dazu kommen andere Kernel und ein anderes Quantisierungsformat. Für ein Modell, das in den RAM passt, spricht auf dem Mac damit wenig für colibri. Wer MLX noch schneller haben will, findet im Artikel zu MTPLX die passenden Messungen.
colibri ist für den anderen Fall gebaut, für Modelle, die nicht in den RAM passen.
Qwen3.8-Flash-Next: 186 GB von der USB-Disk
Qwen3.8-Flash-Next hat 125 Milliarden Parameter, 48 Schichten mit je 512 Experten und aktiviert pro Token zehn davon. Der Download im FP8-Format ist 186 GB groß und passt nicht mehr in 64 GB RAM. Das Modell denkt standardmäßig nach, bevor es antwortet, und es nutzt Multi-Token Prediction, eine eingebaute Form von Speculative Decoding. Im Log kamen pro Durchlauf durch das Modell im Schnitt 2,1 bis 2,4 Tokens heraus.
Gemessen habe ich wieder mit dem Skript, diesmal mit mehreren kurzen Erklär-Prompts (Mixture-of-Experts, SSD gegen Festplatte, Hash-Table, Compiler) und jeweils 200 Tokens inklusive Denkphase. Die Prompts unterschieden sich zwischen den Konfigurationen, die Zahlen sind deshalb nur grob vergleichbar.
| Konfiguration | Decode | Erstes Token |
|---|---|---|
FP8, coli serve ohne --cap (1 Experte pro Schicht), 2 Läufe | 1,1 bis 1,2 tok/s | 48 s (1. Lauf) |
FP8, --cap 96 | 0,8 bis 1,1 tok/s | 42 bis 50 s |
int4-Experten, --cap 170 | 1,6 bis 1,8 tok/s | 29 bis 40 s |
Mit --cap 96 war FP8 nicht schneller. Woran das liegt, kann ich nicht sagen, die beiden Läufe ohne --cap hatten zudem einen anderen Prompt. 48 Schichten mal 10 Experten mal 4,7 MB ergibt rund 2,3 GB pro Durchlauf durch das Modell, bei 0,85 GB/s also knapp drei Sekunden Lesezeit, wenn kein Experte im Cache liegt. Mit 2,1 bis 2,4 Tokens pro Durchlauf wären das 0,8 bis 0,9 tok/s. Gemessen habe ich etwas mehr, vermutlich kam ein Teil der Experten aus dem Dateicache von macOS.
Der größte Hebel war ein Konverter, den colibri mitliefert. convert_qwen38_experts_int4.py schreibt alle Experten zusätzlich im int4-Format mit Gruppengröße 64 neben das Modell. Das dauerte auf dem M3 Max 5,5 Minuten und belegt 63 GiB zusätzlich.
Ein Experte schrumpft von 4,69 auf 2,64 MiB, colibri muss pro Token also 44 Prozent weniger von der Platte lesen. Das Tempo stieg um etwa die Hälfte, was zu den Angaben im README passt (1,91 bis 2,56 tok/s in FP8, 3,99 mit int4 auf einem Ryzen mit NVMe).
Der Konverter meldet einen relativen Fehler pro Schicht von typischerweise 0,11. Die Antworten blieben korrekt und auf Deutsch.
1,7 Tokens pro Sekunde sind langsam. Für eine Antwort mit Denkphase und 500 Tokens wartet man fünf Minuten.
GLM-5.2: 744 Milliarden Parameter
GLM-5.2 von Z.ai ist das Referenzmodell von colibri. Der Download umfasst 429 GB, bei knapp 40 MB/s waren das gut drei Stunden. Auf der Platte belegt das Modell 400 GiB, davon bleiben 11,9 GB dichte Gewichte im RAM. coli plan sagte eine Trefferquote im Cache von 2 Prozent voraus und nannte Fehlzugriffe auf die Platte als begrenzenden Faktor.
Für Metal habe ich die Engine mit make colibri METAL=1 neu gebaut und die Einstellungen aus der Apple-Silicon-Beispielkonfiguration der Doku übernommen:
COLI_METAL=1 DIRECT=1 COLI_NO_OMP_TUNE=1 PIPE=1 PIPE_WORKERS=6 MTP=0 \
  c/coli serve --model "/Volumes/Extreme SSD/models/colibri/glm-5.2" \
  --port 8001 --ram 30 --no-think --ctx 4096
Anders als die Qwen-Engine beachtet die GLM-Engine --ram. Laut Log senkt sie den Cache wegen der Grenze von 30 GB auf 6 bis 7 Experten pro Schicht.
Der Prompt war „Erkläre in drei Sätzen, was ein Compiler macht.", die Antwort auf 40 Tokens begrenzt. Ab dem zweiten Lauf lud colibri den gespeicherten KV-Cache des Prompts von der Platte. Die 14 bis 15 Sekunden bis zum ersten Token enthalten dort also keinen Prefill.
| Konfiguration | Erstes Token | Decode | 40 Tokens gesamt |
|---|---|---|---|
| CPU, erster Start | 143 s | 0,09 tok/s | 592 s |
| CPU, zweiter Lauf | 14 s | 0,07 tok/s | 550 s |
| Metal, zwei Läufe | 15 s | 0,09 tok/s | 453 und 455 s |
Die Antwort war in allen vier Läufen identisch und richtig: „Ein Compiler ist ein Übersetzungsprogramm, das den Quellcode einer Programmiersprache in eine maschinenlesbare Form umwandelt." Für diesen Satz und den Anfang des nächsten braucht der Mac siebeneinhalb bis zehn Minuten.
Die Metal-Läufe sparen etwa ein Fünftel der Gesamtzeit, das Decode-Tempo steigt gegenüber dem zweiten CPU-Lauf von 0,07 auf 0,09 tok/s. Das ist nicht Metal allein, denn mit der Apple-Konfiguration habe ich auch direktes Lesen, Pipelining und das Abschalten von MTP übernommen. Der erste CPU-Lauf lag zudem ebenfalls bei 0,09, die Streuung zwischen den Läufen ist also so groß wie der Effekt. Mehr ist ohnehin nicht drin. Pro Token wechseln rund 11 GB Experten, bei einer Trefferquote nahe null kommen die fast vollständig von der USB-Disk. Bei 0,85 GB/s sind das etwa 13 Sekunden pro Token, also 0,08 tok/s. Genau dort liegen die Messwerte. Schnellere Rechenwerke helfen wenig, wenn sie auf die Platte warten.
Die Zahl passt zum README, das für einen Laptop mit 25 GB RAM 0,05 bis 0,1 tok/s im kalten Zustand angibt. Die Benchmark-Tabelle zeigt, was mit mehr RAM und schnellerer Platte geht: 1,83 bis 2,06 tok/s auf einem M5 Max mit 128 GB, interner SSD und Metal, 1,06 bis 1,17 tok/s auf einem M4 Max mit 128 GB und einer Gen5-SSD über Thunderbolt 5. In beiden Fällen lag die Trefferquote über 60 Prozent, weil die Maschinen 40 bis 90 GB Experten dauerhaft im RAM halten.
Die interne SSD bringt weniger als gedacht
Nach den ersten Messungen habe ich auf der internen SSD Platz geschaffen und zwei Modelle dorthin kopiert. Qwen3.6 passte komplett. Von Qwen3.8 habe ich die int4-Experten und alle Dateien mit dichten Gewichten kopiert, zusammen 164 GB. Die Dateien, die nur FP8-Experten enthalten, blieben als Symlink auf der USB-Disk. Die Hauptexperten liest colibri laut Log aus dem int4-Ordner, und laut Index des Modells liegen alle MTP-Gewichte in kopierten Dateien. Die Zugriffe auf die USB-Disk konnte ich nicht mitschreiben, ganz ausschließen lassen sie sich also nicht. Alle Einstellungen und Prompts waren dieselben wie vorher.
| Messung | USB-SSD | Interne SSD |
|---|---|---|
| Qwen3.6, 8 Experten pro Schicht | 2,1 bis 2,4 tok/s | 2,8 bis 2,9 tok/s |
| Qwen3.6, alle Experten im RAM (ab 3. Lauf) | 7,1 bis 7,3 tok/s | 7,0 bis 7,1 tok/s |
Qwen3.8 int4, --cap 170 | 1,6 bis 1,8 tok/s (Ø 1,7) | 1,5 bis 2,3 tok/s (Ø 2,0) |
| Qwen3.8 int4, erstes Token | 29 bis 40 s | 19 bis 25 s |
Die interne SSD liest sieben- bis achtmal schneller, die Modelle werden aber nur 18 bis 25 Prozent schneller. Spürbar ist der Unterschied vor allem bis zum ersten Token. Mit allen Experten im RAM verschwindet er nach dem Aufwärmen ganz. Bei Qwen3.8 hatte die Nutzungsstatistik vor den lokalen Läufen zudem mehr Einträge gesammelt, was das Pinning leicht begünstigt haben kann.
Das Lesetempo der Platte ist damit nicht der einzige Engpass. Vermutlich trifft ein großer Teil der Zugriffe schon den Cache, und der Rest der Zeit geht in Rechnen und Verwalten auf der CPU. Bei Qwen3.6 kommt eine Unschärfe dazu: Das Modell passt mit 22 GB in den Dateicache von macOS, ein Teil der Zugriffe kam nach dem Kopieren also wohl aus dem RAM. Bei Qwen3.8 mit 164 GB fällt dieser Effekt weg. GLM-5.2 passte mit 400 GiB nicht auf die interne SSD. Weil dort pro Token deutlich mehr Experten wechseln, dürfte die Platte mehr ausmachen, gemessen habe ich das nicht.
API und Claude Code
colibri bietet neben der OpenAI-kompatiblen API auch eine Anthropic-kompatible unter /v1/messages. Mit Qwen3.6 habe ich einen Tool-Call getestet, eine Funktion get_weather mit Parameter city. Die Antwort enthielt einen korrekten tool_use-Block mit Hamburg als Stadt. Bei 277 Eingabetokens dauerte das kalt 66 Sekunden.
Naheliegend ist dann der Versuch, Claude Code über ANTHROPIC_BASE_URL=http://127.0.0.1:8001 gegen colibri laufen zu lassen. Mit Qwen3.6, allen Experten im RAM und 64k Kontext habe ich den Versuch nach 20 Minuten abgebrochen, ohne dass eine Zeile Ausgabe kam. Wie groß der Prompt von Claude Code war, zeigt das Log nicht. Der Tool-Call-Test brauchte für 277 Eingabetokens 66 Sekunden, kalt und mit Antwort. In 20 Minuten schafft die Engine bei diesem Tempo nur 5.000 bis 10.000 Tokens Prefill. Als Backend für einen Coding-Agenten ist colibri auf dem Mac damit nicht brauchbar, dafür bleibt MLX die bessere Wahl.
Fazit
Ein Modell mit 744 Milliarden Parametern antwortet auf einem Laptop mit 64 GB RAM von einer USB-SSD, korrekt und auf Deutsch. Das Versprechen von colibri ist damit eingelöst. Die Engine war nach einer kleinen Korrektur eingerichtet, die Doku ist ausführlich, und meine Messungen passen zu den Angaben im README.
Nutzbar ist das auf meiner Hardware allerdings nicht. Bei 0,09 Tokens pro Sekunde wartet man auf einen Absatz eine Viertelstunde. Auch Qwen3.8-Flash-Next mit 1,7 tok/s ist zu langsam für eine Unterhaltung, und Qwen3.6 lief mit MLX zehnmal schneller als mit colibri auf der CPU.
Eine schnellere Platte hilft weniger als gedacht, bei meinen Gegentests waren es 18 bis 25 Prozent. Der größere Hebel ist der RAM, weil jeder Experte im Cache gar nicht erst gelesen werden muss. Selbst mit interner SSD, Metal und 128 GB RAM kommt GLM-5.2 laut Benchmark-Tabelle auf 1,8 bis 2,1 tok/s. Das ist rund zwanzigmal schneller als bei mir und trotzdem kein Tempo für eine Unterhaltung. colibri zeigt damit vor allem eines: Ein Riesenmodell auf dem eigenen Rechner scheitert nicht am Platz, sondern an der Geduld.
Quellen
- colibri auf GitHub (JustVugg/colibri), README, Version 2.0.0
- colibri: Benchmarks
- colibri: Umgebungsvariablen und Apple-Silicon-Konfiguration
- colibri: Metal-Backend
- Qwen3.6-35B-A3B im colibri-Format (Hugging Face)
- Qwen3.8-Flash-Next-FP8 (Hugging Face)
- GLM-5.2 im colibri-Format (Hugging Face)
- Qwen3.6-35B-A3B 4-Bit für MLX (Hugging Face)