Laya im Test: die offene Jev-Alternative auf dem eigenen Mac
Seit dem 19. September bietet TypeSafe AI mit Jev ein Modell an, das keinen Text schreibt, sondern zwischen festgelegten Antwortoptionen entscheidet und Wahrscheinlichkeiten dazu liefert. Jev läuft nur als Dienst über die API. Einen Tag früher ist auf PyPI ein Projekt erschienen, das dieselbe Idee offen umsetzt. Laya von Convai Innovations steht unter Apache 2.0, läuft lokal und spricht nach eigener Angabe dasselbe Protokoll wie Jev.
Ich habe Laya auf einem MacBook Pro mit M3 Max an denselben 200 Bankanfragen gemessen, mit denen ich vor einer Woche Jev getestet habe. Dazu kamen 100 deutsche Übersetzungen und ein Lauf mit vertauschter Reihenfolge der Antwortoptionen.
Ein Encoder statt eines Sprachmodells
Laya ist kein Sprachmodell im üblichen Sinn. Es generiert nichts Wort für Wort, sondern liest Eingabe und Antwortoptionen in einem einzigen Durchlauf und bewertet jede Option. Unter der Haube steckt ein Encoder, also ein Modell, das Text in eine Bedeutungsdarstellung übersetzt, statt neuen Text zu erzeugen. Darauf sitzt ein kleiner Entscheidungskopf, der die Optionen bewertet.
| Checkpoint | Basis | Parameter | Kontext |
|---|---|---|---|
english | ModernBERT-large | 421 Mio. | 512 Token |
multilingual | mmBERT-base | 322 Mio. | 1.024 Token, bis 8.192 |
typed-decisions | ModernBERT-large, nachtrainiert | 421 Mio. | 1.024 Token |
Ein Router wählt den Checkpoint anhand von Schrift und Sprache der Eingabe. Englischer Text geht an english, alles andere an multilingual. Der dritte Checkpoint ist auf vier synthetische Arbeitsabläufe nachtrainiert und wird nur auf ausdrücklichen Wunsch genutzt (Angaben aus README und Modellkarte).
Die Entwicklung läuft in hohem Tempo. Zwischen der ersten Version am 18. September und Version 0.3.24 vom 2. Oktober liegen 32 Releases auf PyPI.
Die Versprechen des Herstellers
Laya vergleicht sich in der eigenen Dokumentation offen mit Jev. Die folgenden Zahlen sind Angaben von Convai Innovations, gemessen auf einer Tesla-T4-GPU, und keine unabhängigen Messungen.
| Angabe (Hersteller) | Laya | Jev |
|---|---|---|
| Latenz pro Frage | 32,8 ms | 236 bis 276 ms |
| Kalibrierungsfehler (ECE) | 0,081 | 0,246 |
Genauigkeit typed-decisions | 0,766 | 0,727 |
Der Kalibrierungsfehler ECE misst, wie weit die ausgegebenen Wahrscheinlichkeiten von der tatsächlichen Trefferquote abweichen. Je kleiner, desto eher stimmt eine Angabe wie „90 Prozent sicher“.
Schon die eigene Dokumentation ist nicht ganz einheitlich. Das README nennt 48 von 51 gemessenen Sprachen, die Modellkarte 45 von 51. Die Modellkarte räumt außerdem ein, dass die Basis-Checkpoints ohne Nachtraining schwach sind und auf der eigenen Entscheidungsaufgabe nur 0,362 erreichen. Ihre Wahrscheinlichkeiten seien zu selbstsicher, und die Reihenfolge der Optionen beeinflusse die Antwort.
Der Testaufbau
Die Aufgabe ist dieselbe wie im Jev-Test. Aus dem öffentlichen Banking77-Datensatz von PolyAI stammen 200 echte Kundenanfragen, je 20 aus zehn Kategorien, gezogen mit festem Zufallsstartwert. Kategorien und Beschreibungen liest das Messskript direkt aus dem Jev-Skript, damit beide Modelle exakt dieselbe Frage bekommen.
Laya lief lokal in Version 0.3.24 mit PyTorch 2.14.1 auf macOS 27.2. Ich habe jede Anfrage dreimal gestellt, mit den Optionen in Originalreihenfolge, umgekehrt und um fünf Positionen verschoben. Alle 600 Anfragen landeten auf dem englischen Checkpoint, keine wurde gekürzt. Die Ladezeit des Modells ist in den Latenzwerten nicht enthalten.
Zehn Prozentpunkte hinter Jev
| Modell | Treffer (Originalreihenfolge) | Median-Latenz |
|---|---|---|
| Jev 1.13 (API, 25.09.) | 187 von 200 (93,5 %) | 380 ms inklusive Netz |
Laya english, M3-Max-GPU | 167 von 200 (83,5 %) | 35 ms |
Laya english, M3-Max-CPU | 167 von 200 (83,5 %) | 180 ms |
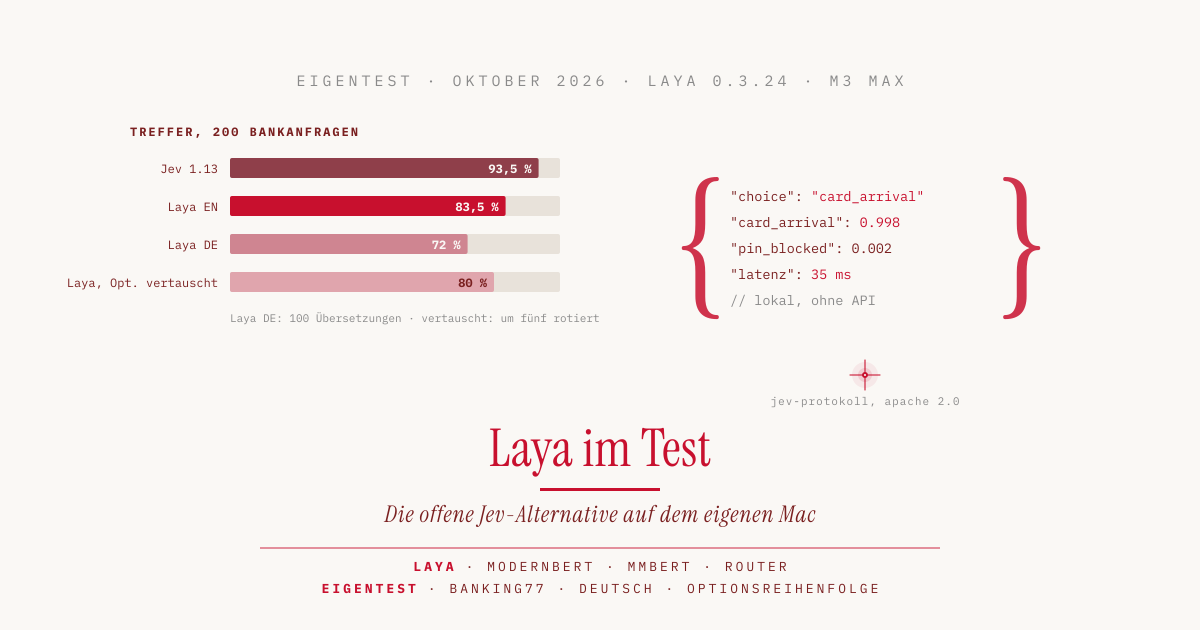
Laya bleibt zehn Prozentpunkte hinter Jev. Die Latenzen sind nicht direkt vergleichbar, weil Jevs Wert die Strecke über OpenRouter enthält und Layas Wert reine Rechenzeit auf dem eigenen Rechner ist. Für den Betrieb ist genau das der Unterschied. Laya antwortet auf der GPU des Mac in rund 35 Millisekunden, ohne dass eine Anfrage das Gerät verlässt, und kostet nichts pro Aufruf. Jev kostete im Test 0,02 Euro pro 1.000 Anfragen.
Der häufigste Fehler ist bei beiden Modellen derselbe. Elfmal ordnet Laya eine Anfrage, bei der das eigene Guthaben nach einer Überweisung nicht gestiegen ist, als „Überweisung beim Empfänger nicht angekommen“ ein. Jev verwechselt dieselben beiden Kategorien siebenmal. Die Beschreibungen liegen inhaltlich nah beieinander, hier stößt die Aufgabe selbst an Grenzen.
Die Reihenfolge der Optionen ändert das Ergebnis
Mit umgekehrter Reihenfolge trifft Laya 161 von 200, mit verschobener 160. Bei 37 der 200 Anfragen wechselt die Antwort allein deshalb, weil die Optionen anders sortiert sind. Nur 151 Anfragen beantwortet Laya in allen drei Reihenfolgen richtig.
Das deckt sich mit dem, was Laya selbst dokumentiert, und mit einem kleinen Vergleichstest von Runtime Weekly, in dem Laya bei fünf von 30 Supportfällen je nach Reihenfolge anders entschied. Wer Laya einsetzt, sollte die Optionsreihenfolge mittesten. Laya bietet dafür einen Parameter option_order, mit dem sich mehrere Reihenfolgen durchspielen lassen.
Brauchbare Wahrscheinlichkeiten trotz Warnhinweis
Die ausgegebenen Wahrscheinlichkeiten sind brauchbarer, als die Warnungen der Dokumentation vermuten lassen. 139 Antworten hatten eine Wahrscheinlichkeit von mindestens 0,9, davon waren 133 richtig. Bei richtigen Antworten lag die Wahrscheinlichkeit der gewählten Option im Mittel bei 0,93, bei falschen bei 0,61.
Daraus ergibt sich ein praktischer Weg. Antworten unterhalb einer Schwelle gehen an einen Menschen, der Rest wird automatisch verarbeitet. Auf meinen 200 Anfragen hätte eine Schwelle von 0,9 etwa 70 Prozent automatisch erledigt, bei einer Trefferquote von 96 Prozent. Für einen Produktivbetrieb müsste diese Schwelle auf den eigenen Daten bestimmt werden.
Eine Einschränkung meldet Laya selbst beim Laden des englischen Checkpoints. Für Fragen mit elf oder mehr Optionen enthalte er ungültige Temperaturwerte, die Konfidenz dieser Einträge sei als unkalibriert zu behandeln. Meine Aufgabe hatte zehn Optionen und sollte nach meiner Lesart der Meldung nicht betroffen sein.
Auf Deutsch deutlich schwächer
Für die deutschen Anfragen habe ich die 100 Übersetzungen aus dem Jev-Test verwendet, mit englischen Kategorien wie dort.
| Modell | Deutsche Anfragen | Dieselben 100 auf Englisch |
|---|---|---|
| Jev 1.13 | 95 von 100 | 95 von 100 |
| Laya, automatisches Routing | 72 von 100 | 86 von 100 |
Laya, fest auf english | 39 von 100 | 86 von 100 |
Jev verliert durch die Übersetzung nichts. Laya fällt von 86 auf 72 Treffer. Der Router schickte 94 der 100 deutschen Anfragen an den mehrsprachigen Checkpoint, sechs blieben beim englischen. Ohne Router fällt der englische Checkpoint auf 39 Treffer. Die Zahlen bestätigen, was die Dokumentation über den englischen Checkpoint sagt, und zeigen zugleich, dass auch der mehrsprachige auf Deutsch spürbar hinter dem englischen Ergebnis bleibt. Mit 23 Millisekunden ist er immerhin der schnellste der beiden.
Jev-Code funktioniert ohne Änderung
Laya bringt einen HTTP-Server mit, der den Jev-Endpunkt /v1/systemone nachbildet. Ich habe den unveränderten Request aus meinem Jev-Testskript an den lokalen Server geschickt, inklusive Modellname typesafe/jev-1.13. Die Antwort kam mit denselben Feldern zurück (choice, probabilities, confidence) und mit der richtigen Kategorie.
pip install "laya[serve]"
LAYA_PORT=8765 LAYA_MODELS=english,multilingual laya-serve
Wer heute Jev nutzt, kann für einen Test also nur die Basis-URL umstellen. Beim ersten Start lädt der Server standardmäßig alle drei Checkpoints herunter. Mit LAYA_MODELS lässt sich das auf die benötigten beschränken.
Wo Laya die bessere Wahl ist
Laya ist kein Ersatz für Jev, wenn es auf die letzten Prozentpunkte ankommt oder die Eingaben deutsch sind. Es ist eine ernsthafte Option, wenn Daten das Haus nicht verlassen dürfen, wenn Kosten pro Anfrage zählen oder wenn Entscheidungen in wenigen Millisekunden fallen müssen. Für die Vorsortierung englischer Anfragen mit einer Schwelle für die unsicheren Fälle reicht die Qualität. Pflicht bleibt, die Optionsreihenfolge mitzutesten und die Schwelle auf eigenen Daten festzulegen.
Das Projekt ist zwei Wochen alt und bewegt sich schnell. Die Zahlen hier gelten für Version 0.3.24 und können in einem Monat anders aussehen.
Quellen
- Laya, Quellcode und README: github.com/NandhaKishorM/laya
- Laya, Modellkarte: huggingface.co/convaiinnovations/laya
- Laya auf PyPI: pypi.org/project/laya
- PolyAI, Banking77-Datensatz: github.com/PolyAI-LDN/task-specific-datasets
- Runtime Weekly, Kev und Laya im Vergleich: github.com/Runtime-weekly/runtime-tutorials
- Jev im Test (Vergleichswerte vom 25.09.2026): rotecodefraktion.de
- Eigene Messung: Laya 0.3.24, Checkpoint-Revision
55cf4c4, PyTorch 2.14.1, MacBook Pro M3 Max, macOS 27.2, 3. Oktober 2026