KI-Videos lokal erzeugen: Wan 2.2 auf dem Mac
KI-Videos entstehen bisher fast immer in der Cloud. Sora, Veo und Runway nehmen den Prompt entgegen, rechnen auf ihren Servern und liefern den Clip zurück, gegen Abo und mit allem, was man dort hochlädt. Offene Videomodelle ändern das. Bei Wan 2.2 von Alibaba sind die Gewichte frei verfügbar, und auf einem Mac mit genug Speicher läuft das Modell vollständig lokal.
In diesem Artikel richten wir das gemeinsam ein. Wir laden das Modell, wandeln es für Apples Framework MLX um und erzeugen damit ein Video, das komplett auf dem eigenen Rechner entsteht. Danach bringen wir lesbaren Text ins Bild, und dabei zeigt sich, wo lokale Videogenerierung heute an ihre Grenze stößt. Alle Zeiten haben wir auf einem MacBook Pro mit M3 Max und 64 GB gemessen.
Diesen Clip erzeugen wir als Erstes, aus einem einzigen Satz als Prompt:
Ein Mac mit 64 GB und Wan 2.2
Als Modell nehmen wir Wan 2.2, eine Familie offener Videomodelle von Alibaba, und davon die kleinste Variante, Wan2.2-TI2V-5B mit fünf Milliarden Parametern. TI2V steht für Text+Image-to-Video. Das Modell erzeugt ein Video aus einem Text oder animiert ein Startbild, das wir ihm mitgeben. Es liefert 720p mit 24 Bildern pro Sekunde, die native Auflösung ist 1280×704 (Modellkarte).
Auf dem Mac rechnen wir mit MLX, Apples Framework für maschinelles Lernen auf Apple Silicon. Wie MLX bei Sprachmodellen abschneidet, haben wir in Gemma 4 gegen Qwen Coder gemessen. Für Wan gibt es mit mlx-video eine fertige Portierung, die Wan 2.1, Wan 2.2 und LTX-2 unterstützt.
| Was | Unser Testrechner |
|---|---|
| Rechner | MacBook Pro, M3 Max, 40 GPU-Kerne, 64 GB |
| System | macOS 27.2 |
| Software | Python 3.12, MLX 0.32.3, mlx-video 0.0.1 |
| Download | 34,2 GB Original-Gewichte |
| Umgewandelt für MLX | 23 GB |
| Speicherbedarf beim Rechnen | 56,4 GB in der Spitze |
Der Speicher ist die eigentliche Hürde. Ein Mac mit 64 GB reicht, einer mit 32 GB nicht. Für kleinere Maschinen bietet mlx-video eine 4- oder 8-Bit-Quantisierung an, die den Speicherbedarf des Transformers deutlich senkt. Auf der Platte brauchen wir knapp 60 GB für Download und umgewandeltes Modell. Wer intern wenig Platz hat, legt beides auf eine externe SSD.
Setup in drei Schritten
Zuerst legen wir ein Arbeitsverzeichnis mit einer eigenen Python-Umgebung an und installieren mlx-video direkt aus dem Repo. PyTorch brauchen wir nur, weil das Umwandlungsskript die Original-Gewichte im PyTorch-Format liest.
mkdir -p ~/lokales-video && cd ~/lokales-video
uv venv --python 3.12
uv pip install "mlx-video @ git+https://github.com/Blaizzy/mlx-video.git" torch
Dann laden wir das Modell von Hugging Face. Bei 34 GB dauert das je nach Leitung eine Weile.
uvx --from huggingface_hub hf download Wan-AI/Wan2.2-TI2V-5B \
    --local-dir ~/models/Wan2.2-TI2V-5B
Zum Schluss wandeln wir die Gewichte ins MLX-Format um:
.venv/bin/python -m mlx_video.models.wan_2.convert \
    --checkpoint-dir ~/models/Wan2.2-TI2V-5B \
    --output-dir ~/models/Wan2.2-TI2V-5B-MLX
Der Modulpfad lautet mlx_video.models.wan_2, die README des Projekts nennt an einigen Stellen noch veraltete Namen. Scheitert die Umwandlung an einem Metal-Timeout, stellen wir MLX vorher mit mx.set_default_device(mx.cpu) auf die CPU. Die Umwandlung ändert nur Datentypen und braucht keine GPU.
Der erste Clip: 18 Minuten für 1,7 Sekunden
Jetzt erzeugen wir das Video. Dafür genügt ein Befehl:
.venv/bin/python -m mlx_video.models.wan_2.generate \
    --model-dir ~/models/Wan2.2-TI2V-5B-MLX \
    --prompt "A fluffy orange tabby cat sits in front of a computer in a dark room, typing rapidly on a mechanical keyboard with its paws. Green code scrolls on the monitor and reflects on the cat's face. Cinematic lighting, shallow depth of field, hacker atmosphere." \
    --width 1280 --height 704 --num-frames 41 --steps 40 --seed 42 \
    --output-path katze.mp4
41 Frames ergeben bei 24 fps 1,7 Sekunden. Der Seed ist der Startwert des Zufallsgenerators. Mit gleichem Seed und gleichem Prompt entsteht dasselbe Video, wer die Befehle genau so übernimmt, sollte also den Clip vom Anfang bekommen. Unser M3 Max hat dafür knapp 18 Minuten gerechnet.
| Phase | Zeit (gemessen, M3 Max) |
|---|---|
| Textencoder laden, Prompt kodieren | 22,5 s |
| Transformer laden | 10,3 s |
| Diffusion, 40 Schritte | 15:06 min |
| VAE-Dekodierung zu fertigen Bildern | 2:01 min |
| Gesamt | 17:43 min |
Die meiste Zeit steckt in der Diffusion. Dabei rechnet der Transformer das Video in 40 Schritten aus reinem Rauschen heraus, jeder Schritt dauert hier 22,6 Sekunden. Längere Clips kosten überproportional mehr. Mit 121 Frames für 5 Sekunden dauert ein Schritt rund fünfmal so lange, weil die Attention jedes Bildstück mit jedem anderen in Beziehung setzt und damit quadratisch mit der Länge wächst. Ein 5-Sekunden-Clip braucht auf dem M3 Max deshalb gut eineinhalb Stunden.
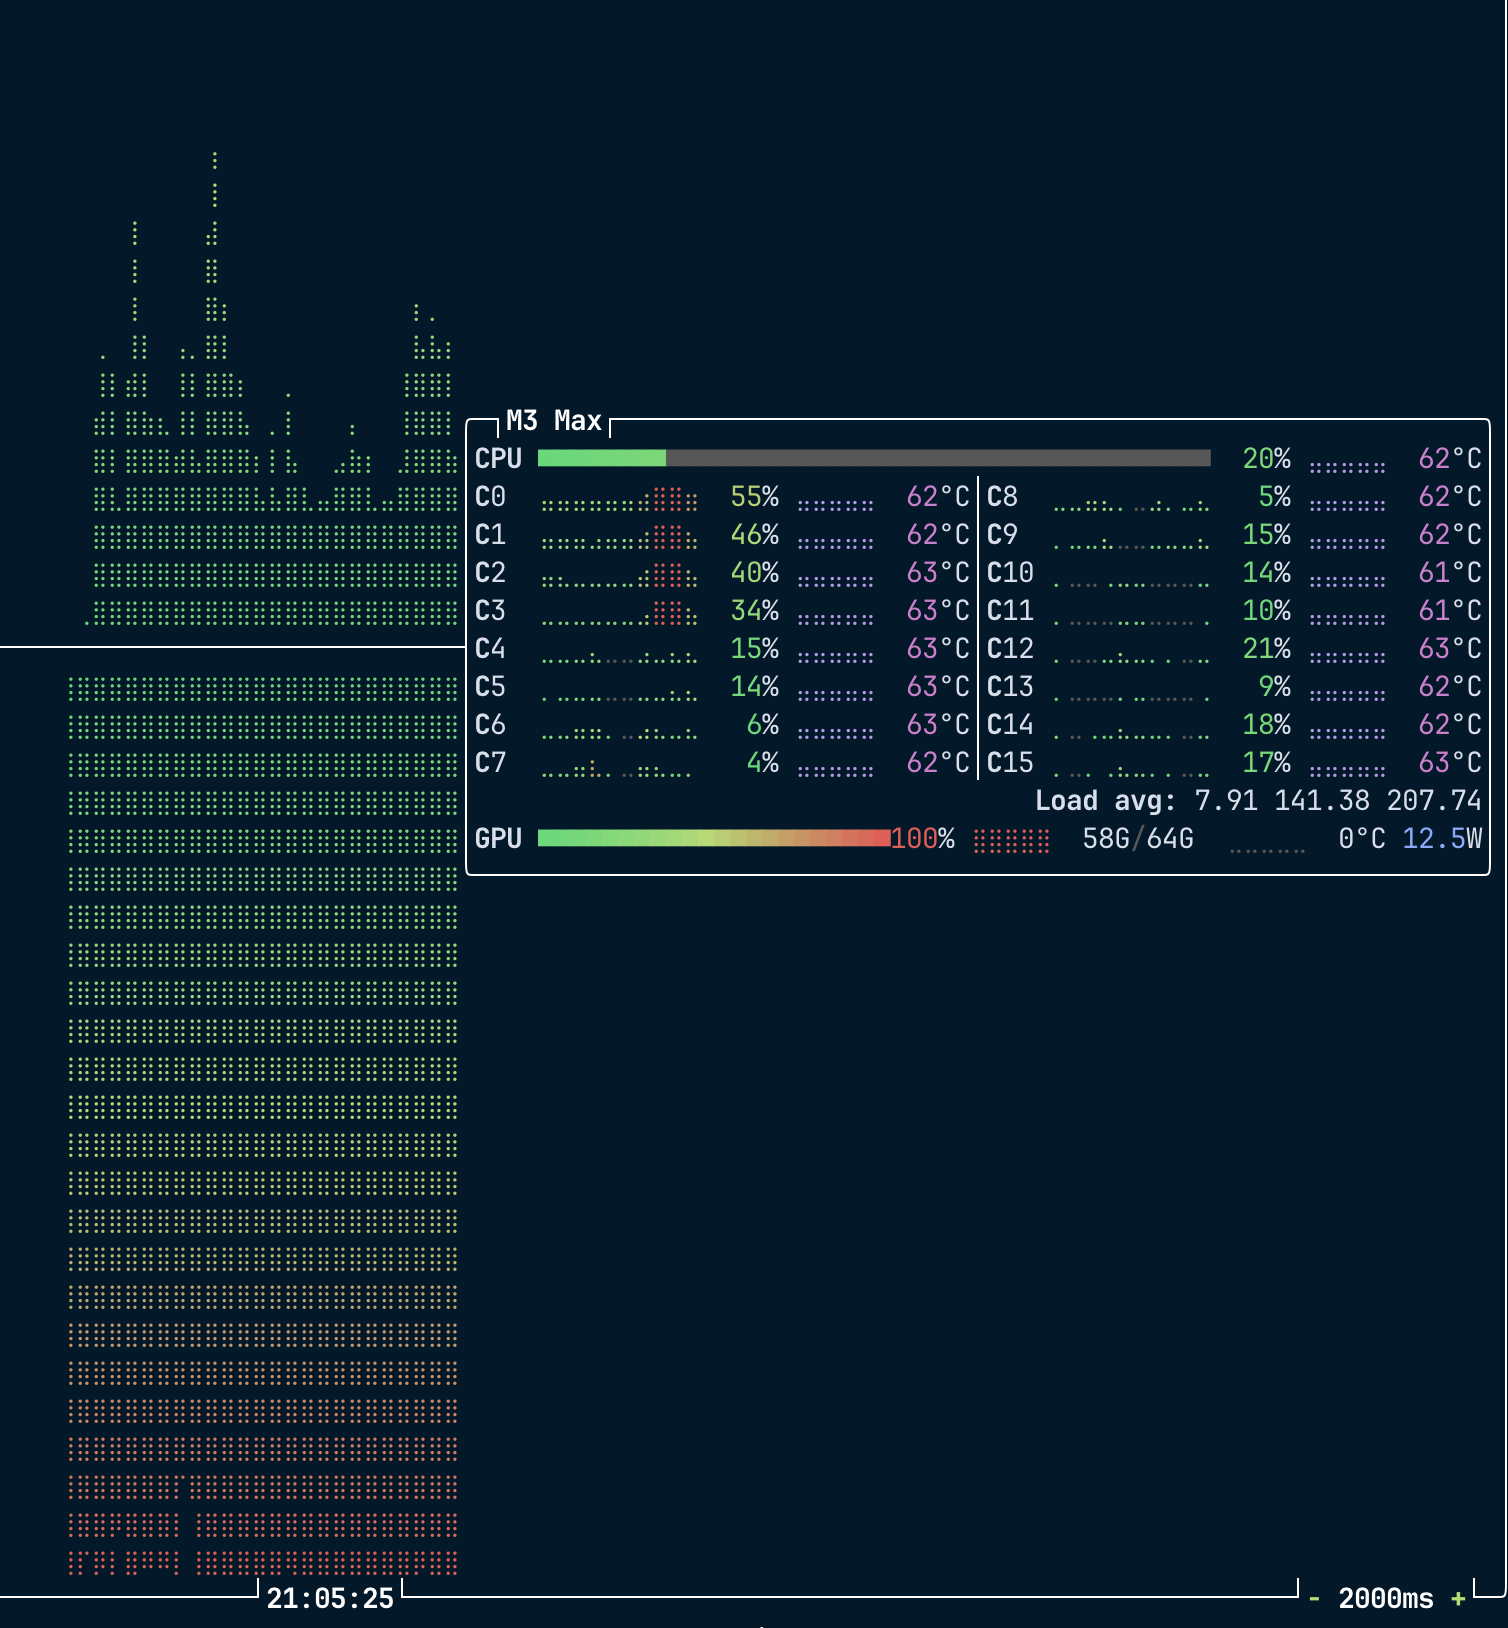
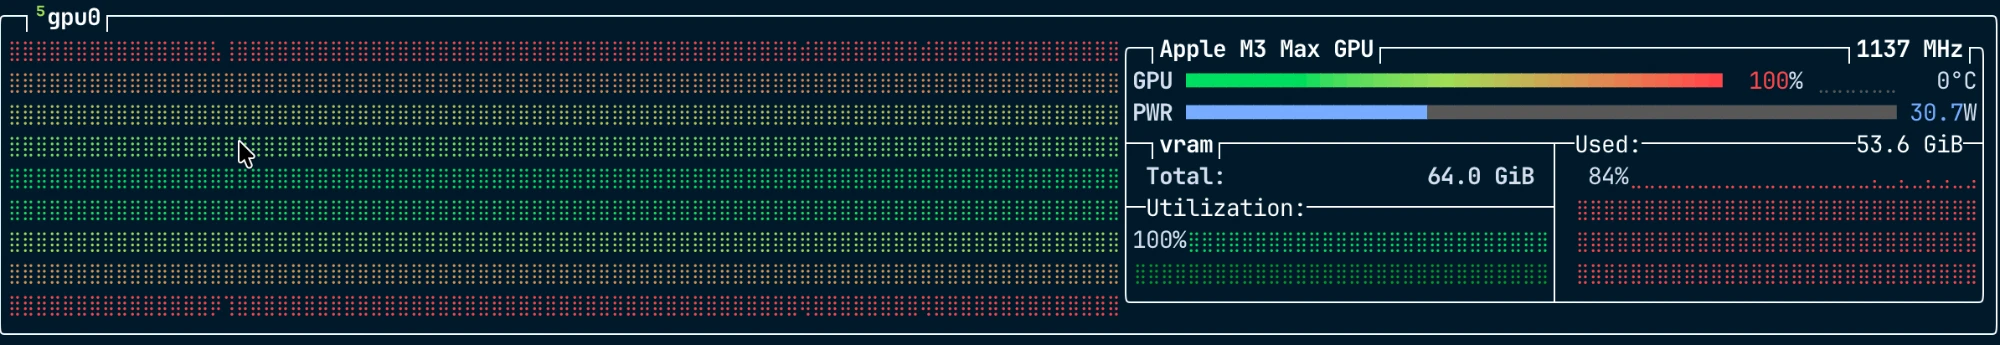
Solange die Diffusion läuft, ist der Mac voll ausgelastet. Die GPU steht durchgehend bei 100 Prozent, der Speicher bei 58 von 64 GB. Die CPU hat dagegen wenig zu tun, sie liegt bei rund 20 Prozent.
Bevor wir einen so langen Lauf starten, lohnt sich ein Einzelbild mit --num-frames 1. Das dauert rund zwei Minuten und zeigt, wie Wan den Prompt umsetzt.
PyTorch auf dem Mac: zu wenig Speicher
Der zweite verbreitete Weg ist PyTorch mit der Bibliothek diffusers, die eine fertige WanPipeline mitbringt. Auf dem Mac nutzt PyTorch dafür MPS, sein Metal-Backend. Wir haben denselben Clip zum Vergleich damit gerechnet.
Das diffusers-Skript: katze_diffusers.py
import sys
import time

import torch
from diffusers import AutoencoderKLWan, WanPipeline
from diffusers.utils import export_to_video

MODEL = "Wan-AI/Wan2.2-TI2V-5B-Diffusers"
PROMPT = (
    "A fluffy orange tabby cat sits in front of a computer in a dark room, "
    "typing rapidly on a mechanical keyboard with its paws. Green code scrolls "
    "on the monitor and reflects on the cat's face. Cinematic lighting, "
    "shallow depth of field, hacker atmosphere."
)

device = "cuda" if torch.cuda.is_available() else "mps" if torch.backends.mps.is_available() else "cpu"
num_frames = int(sys.argv[1]) if len(sys.argv) > 1 else 41
steps = int(sys.argv[2]) if len(sys.argv) > 2 else 40

t0 = time.time()
vae = AutoencoderKLWan.from_pretrained(MODEL, subfolder="vae", dtype=torch.float32)
pipe = WanPipeline.from_pretrained(MODEL, vae=vae, dtype=torch.bfloat16).to(device)
pipe.vae.enable_tiling()
t1 = time.time()

video = pipe(
    prompt=PROMPT,
    width=1280,
    height=704,
    num_frames=num_frames,
    num_inference_steps=steps,
    guidance_scale=5.0,
    generator=torch.Generator("cpu").manual_seed(42),
).frames[0]
t2 = time.time()

out = f"katze-diffusers-{device}-{num_frames}f.mp4"
export_to_video(video, out, fps=24)
print(f"Gerät {device}, Laden {t1 - t0:.0f} s, Erzeugen {t2 - t1:.0f} s -> {out}")
| MLX | PyTorch/MPS | |
|---|---|---|
| Sekunden pro Schritt | 22,6 | 28,6 |
| Diffusion, 40 Schritte | 15:06 min | 19:04 min |
| Spitzenspeicher | 56,4 GB | 75 GB, mit Tiling 95 GB |
| Video fertig | ja | nein |
PyTorch rechnet die Diffusion etwas langsamer durch und scheitert dann am Speicher. Beim Dekodieren der Bilder stieg der Bedarf auf 75 GB, macOS beendete den Prozess. Mit enable_tiling(), das die Bilder in Kacheln dekodiert, wurde es nicht besser. mlx-video kachelt die Dekodierung von sich aus und bleibt unter 64 GB. Auf dem Mac bleiben wir deshalb bei MLX. Wer unter Linux mit einer Nvidia-Karte mitmacht, nimmt das diffusers-Skript, dort wählt es automatisch cuda.
Lesbarer Text braucht ein Startbild
Bewegung, Licht und Stimmung setzt Wan aus einem Satz um. Lesbaren Text nicht. Auf dem Monitor in unserem ersten Clip steht Pseudoschrift, und sie scrollt nicht.
Das wollen wir besser machen. Auf den Monitor soll echter Code, unten eine rote Statusleiste mit „rotecodefraktion“. Der naheliegende Versuch ist, beides wörtlich in den Prompt zu schreiben. Wir haben das mit einem 5-Sekunden-Clip ausprobiert.
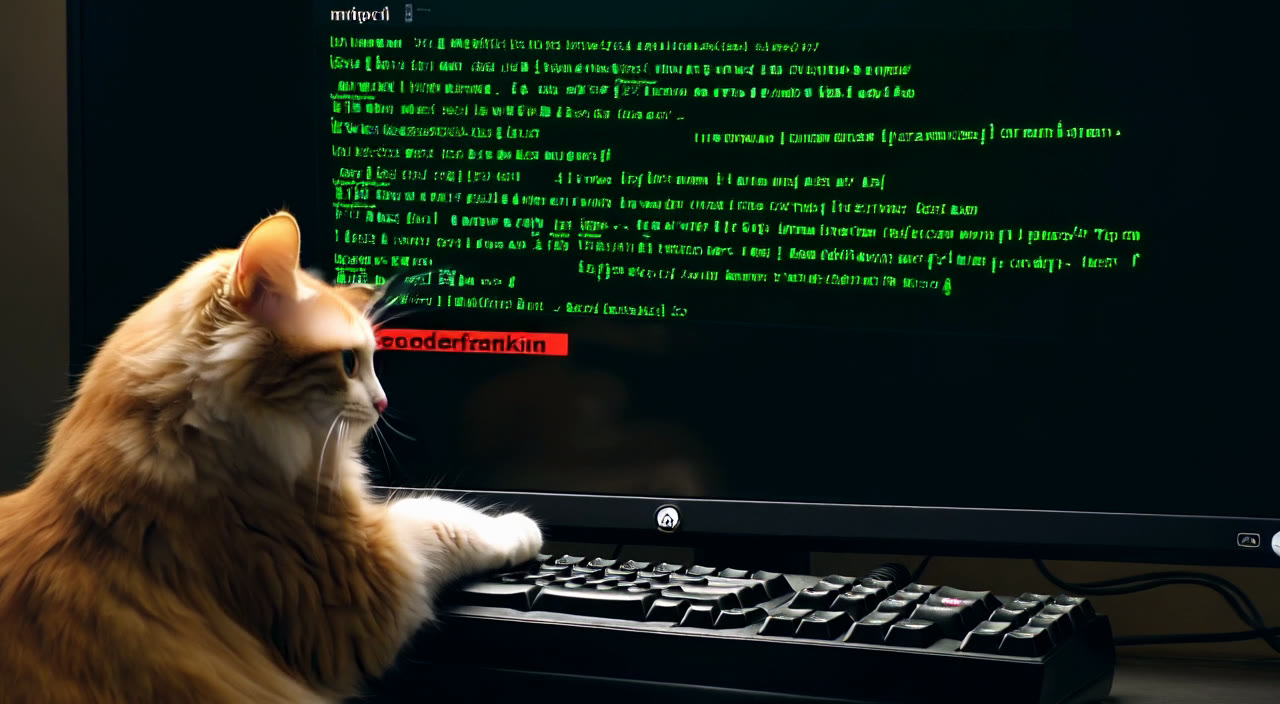
Das Ergebnis zeigt die Grenze deutlich. Der Code ist Zeichensalat, die Leiste ist ein kleines rotes Etikett in der Bildschirmmitte mit „coooderfrankin“. Die Zeilen stehen ab dem ersten Frame da, getippt wird nichts. Weil der Prompt ein anderer war, ist auch die ganze Szene eine neue. Gleicher Seed heißt bei anderem Text nicht gleiches Bild.
Was im Video lesbar sein soll, gehört deshalb ins Startbild. Genau dafür ist TI2V gebaut. Wir nehmen den ersten Frame unseres ersten Clips und setzen auf den Monitor den echten Befehl, mit dem wir die Videos erzeugen. Den grünen Balken am unteren Bildschirmrand ersetzen wir durch die rote Statusleiste.
Zuerst holen wir den ersten Frame aus katze.mp4. Das Paket imageio hat mlx-video bereits mitinstalliert:
.venv/bin/python -c "import imageio.v3 as iio; iio.imwrite('startbild.png', iio.imread('katze.mp4', index=0))"
Den Rest erledigt ein kurzes Python-Skript mit Pillow. Es zeichnet den Bildschirminhalt, verzerrt ihn perspektivisch auf die vier Ecken des Monitors und lässt die Pixel der Katze stehen, damit ihr Ohr vor dem Bildschirm bleibt.
Das Mockup-Skript: mockup.py
"""Setzt lesbaren Code und eine rote Statusleiste auf den Monitor im Wan-Vorschaubild."""
import sys

import numpy as np
from PIL import Image, ImageDraw, ImageFilter, ImageFont

SRC, OUT = sys.argv[1], sys.argv[2]
# Bildschirmecken im 1280x704-Bild (oben links, oben rechts, unten rechts, unten links),
# Höhe der Statusleiste in Texturpixeln und Bereiche, die vor dem Bildschirm stehen
SZENEN = {
    "seed42": dict(quad=[(424, 44), (1186, 36), (1172, 452), (442, 448)], bar_h=92, verdeckt=[]),
    "erstes": dict(quad=[(596, 112), (1140, 104), (1140, 438), (598, 440)], bar_h=118,
                   verdeckt=[(1022, 364, 1280, 704)]),
}
szene = SZENEN[sys.argv[3] if len(sys.argv) > 3 else "seed42"]
QUAD = szene["quad"]
W, H = 1532, 820  # Bildschirmtextur in doppelter Auflösung

CODE = [
    "$ python -m mlx_video.models.wan_2.generate \\",
    "    --model-dir Wan2.2-TI2V-5B-MLX \\",
    '    --prompt "hacker cat" \\',
    "    --width 1280 --height 704 \\",
    "    --num-frames 121 --steps 40 \\",
    "    --seed 42 \\",
    "    --output-path katze.mp4",
]

mono = ImageFont.truetype("/System/Library/Fonts/Menlo.ttc", 46)
bold = ImageFont.truetype("/System/Library/Fonts/Menlo.ttc", 52, index=1)

screen = Image.new("RGB", (W, H), (8, 18, 20))
d = ImageDraw.Draw(screen)
y = 70
for line in CODE:
    d.text((110, y), line, font=mono, fill=(90, 235, 120))
    y += 66
d.rectangle((110, y + 6, 136, y + 56), fill=(90, 235, 120))  # Cursor
bar_h = szene["bar_h"]
d.rectangle((0, H - bar_h, W, H), fill=(200, 16, 46))
d.text((110, H - bar_h + (bar_h - 60) // 2), "rotecodefraktion", font=bold, fill=(255, 255, 255))
screen = Image.blend(screen, screen.filter(ImageFilter.GaussianBlur(3)), 0.35)  # leichtes Leuchten


def coeffs(dst, src):
    """Koeffizienten für Image.transform(PERSPECTIVE), die dst-Punkte auf src-Punkte abbilden."""
    rows = []
    for (x, y), (u, v) in zip(dst, src):
        rows.append([x, y, 1, 0, 0, 0, -u * x, -u * y])
        rows.append([0, 0, 0, x, y, 1, -v * x, -v * y])
    return np.linalg.solve(np.array(rows, float), np.array(src, float).reshape(8))


base = Image.open(SRC).convert("RGB")
warped = screen.transform(
    base.size, Image.PERSPECTIVE, coeffs(QUAD, [(0, 0), (W, 0), (W, H), (0, H)]), Image.BICUBIC
)

quad_mask = Image.new("L", base.size, 0)
ImageDraw.Draw(quad_mask).polygon(QUAD, fill=255)
for box in szene["verdeckt"]:
    ImageDraw.Draw(quad_mask).rectangle(box, fill=0)
# Katzenfell und Schnurrhaare bleiben im Vordergrund (Rot deutlich über Blau oder alles hell); grünlich ist immer Bildschirm
px = np.asarray(base).astype(int)
screen_px = (((px[..., 0] - px[..., 2]) < 30) & (px[..., 0] < 150)) | (px[..., 1] > px[..., 0] + 10)
mask = np.minimum(np.asarray(quad_mask), screen_px * 255).astype(np.uint8)
mask = Image.fromarray(mask).filter(ImageFilter.GaussianBlur(1))

Image.composite(warped, base, mask).save(OUT)
print(OUT)
Wir speichern es als mockup.py im Arbeitsverzeichnis und rufen es mit dem Startbild auf:
.venv/bin/python mockup.py startbild.png mockup.png erstes
Die Ecken des Monitors stehen als Koordinaten im Skript. Sie passen auf die Szene aus unserem ersten Clip. Wer mit eigenem Prompt oder Seed eine andere Szene bekommen hat, ersetzt dort die vier Eckpunkte durch die seines Monitors.
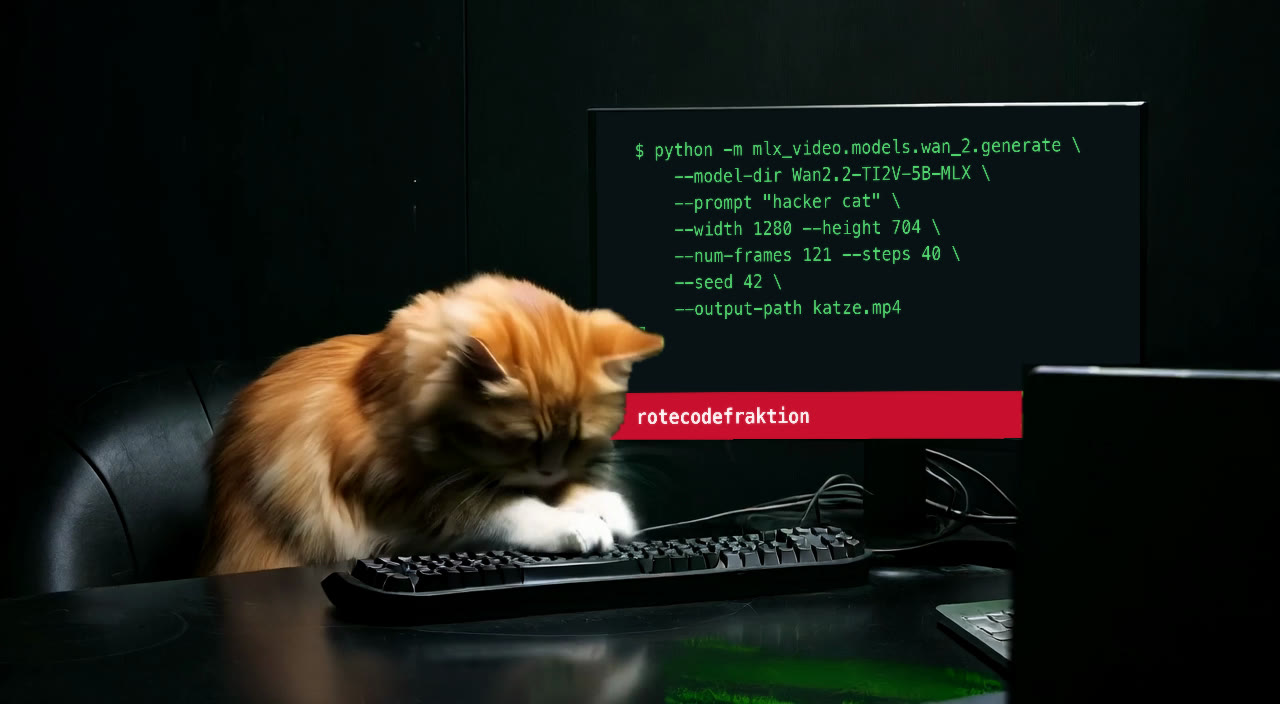
Dieses Bild geben wir Wan als Startframe mit. Im Prompt beschreiben wir nur noch die Bewegung:
.venv/bin/python -m mlx_video.models.wan_2.generate \
    --model-dir ~/models/Wan2.2-TI2V-5B-MLX \
    --image mockup.png \
    --prompt "The orange cat types rapidly on the keyboard with its paws and looks up at the monitor. The monitor shows a terminal with green code and a red status bar. Static camera, dark room, cinematic lighting." \
    --width 1280 --height 704 --num-frames 121 --steps 40 --seed 42 \
    --output-path katze-ti2v.mp4
Das Ergebnis ist zweigeteilt. Die Statusleiste mit „rotecodefraktion“ bleibt über alle fünf Sekunden scharf und lesbar. Der Code hält dagegen genau einen Frame. Nach knapp zwei Sekunden hat Wan ihn in Pseudoschrift aufgelöst, nur Zeilenstruktur und Einrückung bleiben stehen. Große, kurze Schrift übersteht die Animation, kleine und dichte nicht. Gerechnet hat unser Mac an diesem Clip 96 Minuten, bei 57 GB Spitzenspeicher.
Die Neural Engine rechnet nicht mit
Jeder M-Chip hat eine Neural Engine, einen eigenen KI-Beschleuniger. Für Wan bleibt sie ungenutzt. MLX und PyTorch rechnen auf der GPU, an die Neural Engine kommt man nur über Core ML, und eine Core-ML-Fassung von Wan gibt es nicht. Viel gewinnen würde man dort ohnehin nicht. Die Neural Engine ist für sparsame Inferenz kleinerer Modelle gebaut, für die großen Matrixrechnungen eines Videomodells ist die GPU mit ihren 40 Kernen die stärkere Einheit.
Neuere Chips: Faktor vier mit dem M5
Beim M5 hat Apple den Hebel an die richtige Stelle gesetzt. Jeder GPU-Kern hat dort einen eigenen Neural Accelerator für Matrixrechnungen, und MLX nutzt ihn. Für Bildgenerierung mit FLUX gibt Apple mehr als Faktor 3,8 gegenüber dem M4 an (Apple Machine Learning Research), für M5 Pro und M5 Max mehr als die vierfache KI-Rechenleistung der GPU gegenüber M4 Pro und M4 Max (Apple Newsroom). Genau davon profitiert die Diffusion, der teure Teil unseres Laufs.
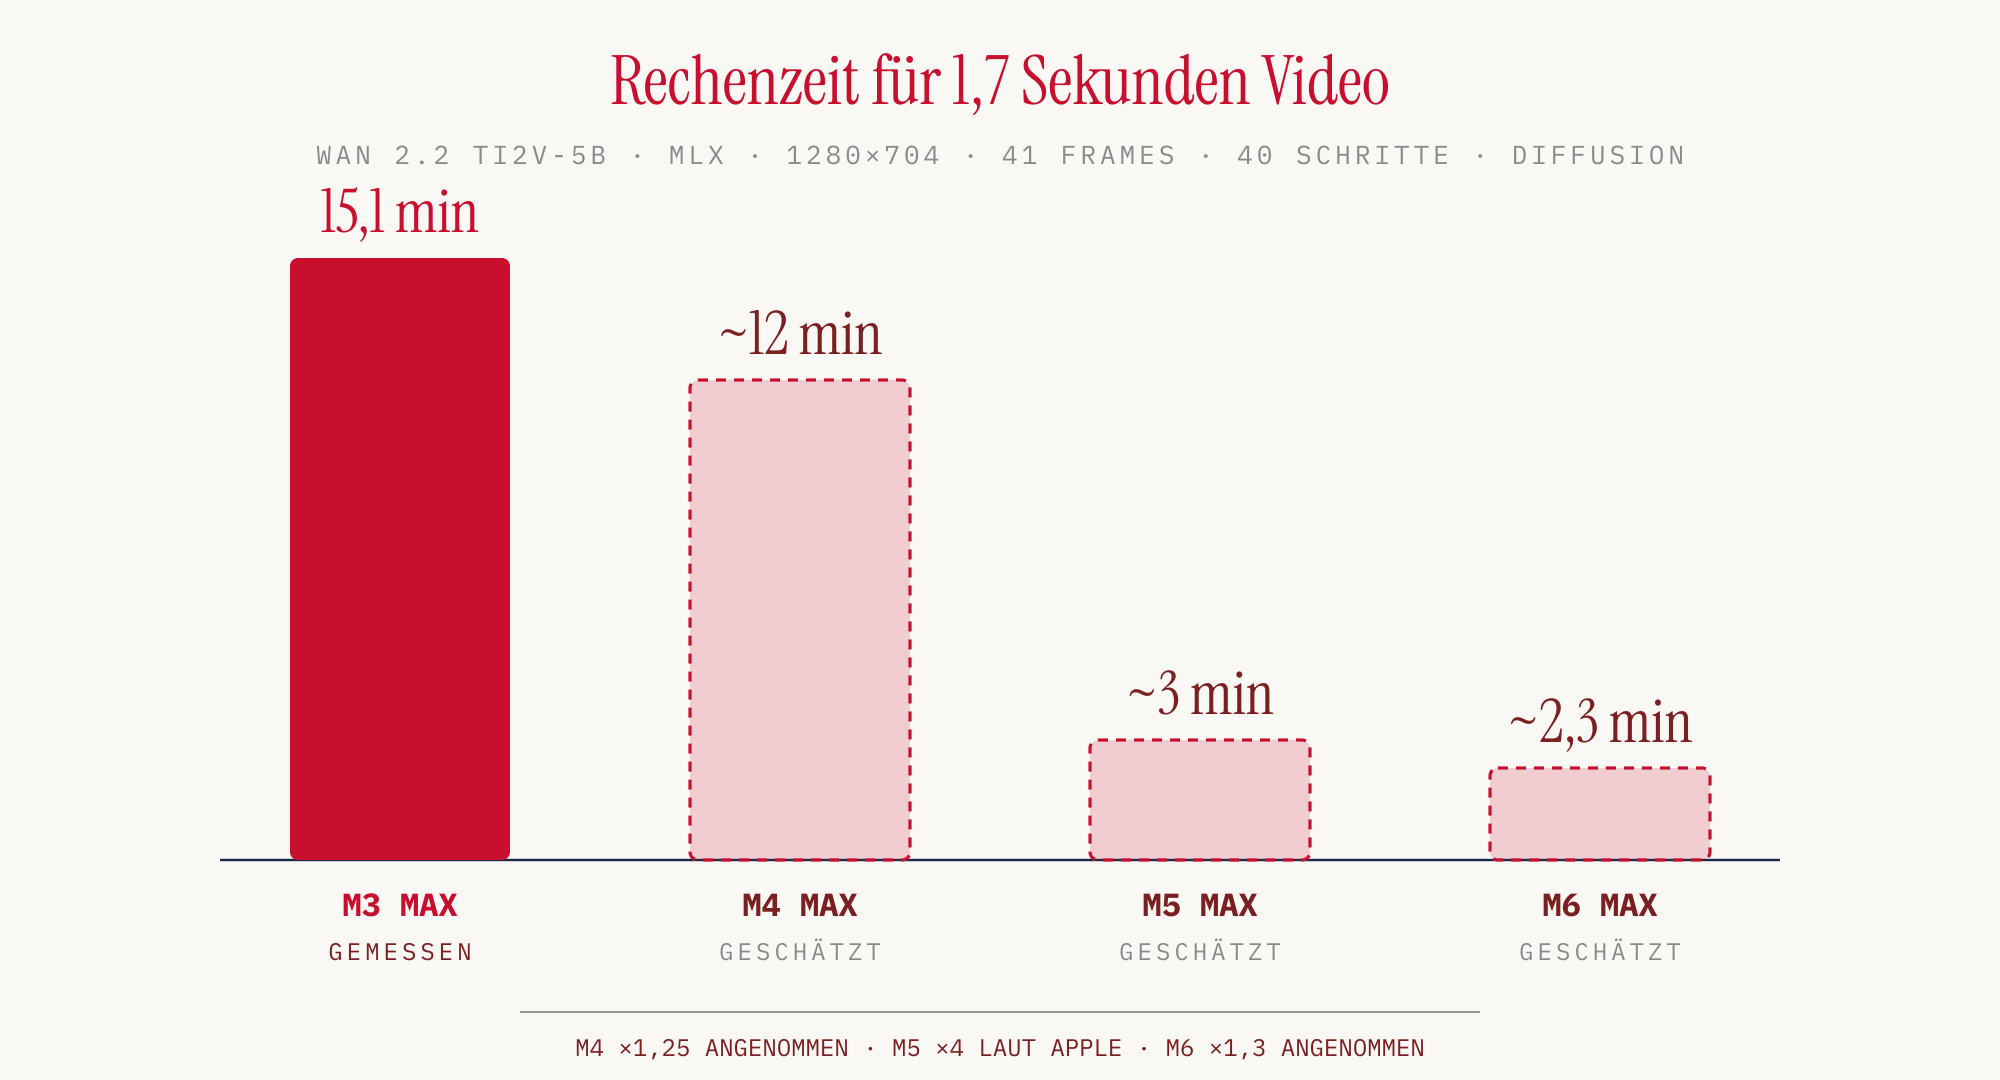
Gemessen ist nur der M3 Max. Für M4 Max und M6 Max haben wir je einen üblichen Generationssprung angenommen, für den M5 Max Apples Faktor vier. Auf einem M5 Max dürfte der Clip damit in rund drei Minuten fertig sein, ein 5-Sekunden-Video in etwa 20 Minuten.
Fazit
Ja, KI-Videogenerierung geht lokal. Ein Mac mit 64 GB, ein offenes Modell und eine Handvoll Befehle reichen für einen 720p-Clip, ohne Cloud und ohne Abo. Auf dem M3 Max kostet das Geduld, rund zehn Minuten Rechenzeit pro Sekunde Video bei kurzen Clips. Mit dem M5 schrumpft das auf ein Viertel.
Die Grenze liegt beim Text. Was im Video lesbar sein soll, muss als Startbild hinein. Aber auch dann bleibt nur große Schrift lesbar, kleiner Code und feine Details verschwimmen nach zwei Sekunden.
Die Katze tippt. Schreiben muss man selbst.
Quellen