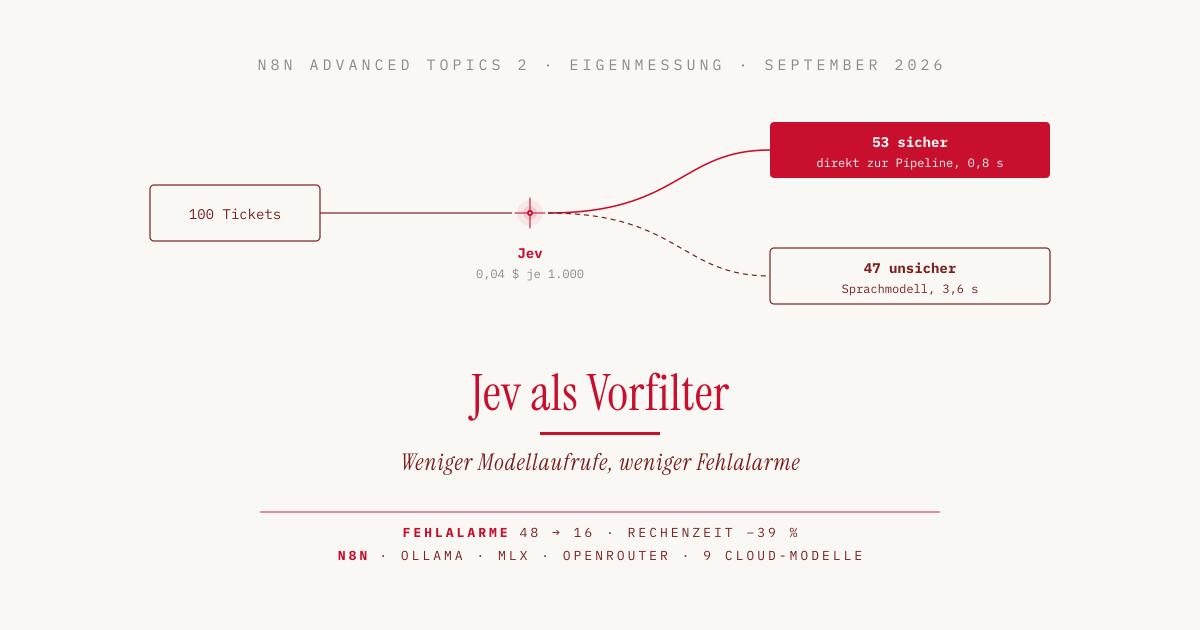
Jev als Vorfilter im Ticket-Workflow: weniger Modellaufrufe, weniger Fehlalarme
Advanced Topics 2 · Reihe: Einstieg in n8n
Bis Version 0.10 lief im Ticket-Workflow jedes Ticket durch ein lokales Sprachmodell. Ein Round-Robin verteilte die Tickets auf Ollama mit qwen2.5 und auf Qwen3-8B über MLX, so wie es Artikel 9 aufgebaut hat. Das Modell bestimmte die Kategorie und entschied, ob ein Ticket den Pager auslöst. Im Test von Jev hatte ich angekündigt, das Entscheidungsmodell von TypeSafe davorzuschalten. Jev beantwortet typisierte Fragen mit Wahrscheinlichkeiten. Ist sich Jev sicher, braucht das Ticket kein Sprachmodell mehr.
Das hat funktioniert, aber nicht im ersten Anlauf. Die Messung brauchte eigene Labels, die Priorität aus meiner Matrix widersprach Jevs P1-Verdacht, und der Pager schlug bei 32 von 100 Tickets falsch an, alle aus dem Zweig des Sprachmodells. Am Ende steht die Rechnung für 1.000 Tickets am Tag mit Cloud-Modellen statt lokaler. Mit DeepSeek V4 Flash hinter Jev sind das 67 Dollar im Jahr. Aber der Reihe nach.
Jev entscheidet zuerst, das Sprachmodell nur im Zweifel
Die Vorklassifizierung ist ein eigener Sub-Workflow mit vier Nodes. Ein Code-Node baut aus dem Ticket die Anfrage, ein HTTP-Node schickt sie an Jev über OpenRouter, ein zweiter Code-Node wertet die Antwort aus. Jev bekommt vier Fragen auf Deutsch zum selben Ticket:
| Frage | Typ | Antworten |
|---|---|---|
| Kategorie | Choice | sap-basis, sap-functional, infrastruktur, cloud, security-pki, sonstiges |
| Auswirkung | Choice | einzelne Person, Gruppe, viele oder alle |
| Dringlichkeit | Choice | später, heute, sofort |
| P1 | Noul (Ja/Nein) | Wahrscheinlichkeit, dass ein P1-Vorfall vorliegt |
Aus den Antworten entscheidet der Code-Node über den Weg. Liegt die Confidence der Kategorie unter 0,9, geht das Ticket ans Sprachmodell. Dasselbe gilt, wenn die P1-Wahrscheinlichkeit zwischen 0,5 und 0,9 liegt, also weder sicher ja noch sicher nein ist. In allen anderen Fällen entscheidet Jev.
Im Hauptworkflow sitzt die Vorklassifizierung direkt hinter der Validierung. Ein IF-Node schickt sichere Tickets sofort zur Pipeline und unsichere in den bestehenden Round-Robin, der unverändert bleibt. Fällt Jev aus, landet das Ticket ebenfalls beim Sprachmodell. Der HTTP-Node hat dafür ein Timeout von zwei Sekunden.
Jev kostet dabei fast nichts. Eine Anfrage mit vier Fragen hat im Schnitt 935 Input-Token, 1.000 Tickets kosten 0,039 Dollar (Eigenmessung über OpenRouter, September 2026).
Ohne eigene Labels kein Maßstab
Der Testdatensatz aus Artikel 3 hat eine Kategorie pro Ticket, die aus dem Generator stammt und sich messen lässt. Für die Priorität gilt das nicht. Das Feld priority hat der Generator zufällig gesetzt. Ein Ticket über einen kompletten Produktivausfall kann darin mit low stehen. Gegen diese Werte zu messen, hätte nur gezeigt, wie gut ein Modell den Zufall trifft.
Also habe ich die 100 Tickets nach P1 bis P4 neu bewerten lassen, von Claude Opus 5.5 in einer Claude-Code-Sitzung, Ticket für Ticket mit Begründung und nach einer schriftlichen Rubrik. Entscheidend sind die beschriebenen Fakten, nicht der Tonfall. P1 heißt, ein Produktivsystem oder zentraler Dienst ist für viele ausgefallen, ein Sicherheitsvorfall ist eingetreten oder ein zentraler Geschäftsprozess steht still. Was im Ticket fehlt, wird nicht angenommen. Heraus kamen 8 P1, 31 P2, 49 P3 und 12 P4. 15 Tickets habe ich als Grenzfall markiert, bei denen sich zwei Stufen vertreten lassen. Zum Abgleich hatten Opus 5.5 und Fable 5.1 die Tickets vorher schon einmal unabhängig voneinander nach derselben Rubrik eingestuft. Die Labels stammen damit nicht von Fachleuten aus dem Betrieb, die Grenzfälle sind die Stelle, an der ich sie zuerst prüfen würde.
Diese Labels dienen nur der Auswertung. Das Messskript schickt weder sie noch die zufällige Generator-Priorität an den Workflow. Die Pipeline aus Artikel 6 alarmiert nämlich auch, wenn der Einreicher critical setzt. Mit der Zufallspriorität im Request hätte der Pager öfter aus Zufall als aus der Klassifikation ausgelöst.
Die Priorität widersprach dem P1-Verdacht
Aus Jevs Antworten zu Auswirkung und Dringlichkeit berechnet der Code-Node eine Priorität. Die Stufen critical, high, medium und low entsprechen P1 bis P4. In der ersten Version setzte die Kombination „viele oder alle“ und „sofort“ die Priorität critical. Der P1-Verdacht kam aber aus der separaten P1-Frage. Beide Werte liefen auseinander. In 20 Fällen stand critical in der Priorität, der P1-Verdacht war nur bei 3 davon gesetzt. Gegen die Labels waren 13 dieser 20 Tickets gar kein P1.
Die Korrektur trennt beide Wege. critical kommt nur noch aus der P1-Frage, die Matrix setzt höchstens high. Danach tauchte die Priorität critical in allen 100 Fällen genau dann auf, wenn auch der P1-Verdacht gesetzt war.
Übrig blieb eine zweite Schwäche. Die Matrix stufte zu hoch ein, 36 P3-Tickets landeten auf P2. Ich habe sie deshalb durch die klassische ITIL-Matrix ersetzt, in der Auswirkung und Dringlichkeit gleich gewichtet sind:
| Auswirkung ↓ / Dringlichkeit → | später | heute | sofort |
|---|---|---|---|
| einzelne Person | low | low | medium |
| Gruppe | low | medium | high |
| viele oder alle | medium | high | high |
critical, also P1, kommt weiterhin nur aus der P1-Frage. Gegen die Labels stieg die exakte Übereinstimmung von 50 Prozent nach der critical-Korrektur (ursprünglich 40) auf 63 Prozent, alle 100 Tickets liegen höchstens eine Stufe daneben. Der Preis dafür sind 6 P2-Tickets, die jetzt als P3 durchgehen. Eine Matrix, die ich an genau diese 100 Tickets angepasst hatte, kam auf 67 Prozent. Ich habe sie verworfen, weil sie die Testdaten auswendig lernt und auf anderen Tickets nichts beweist.
32 Fehlalarme aus dem Sprachmodell
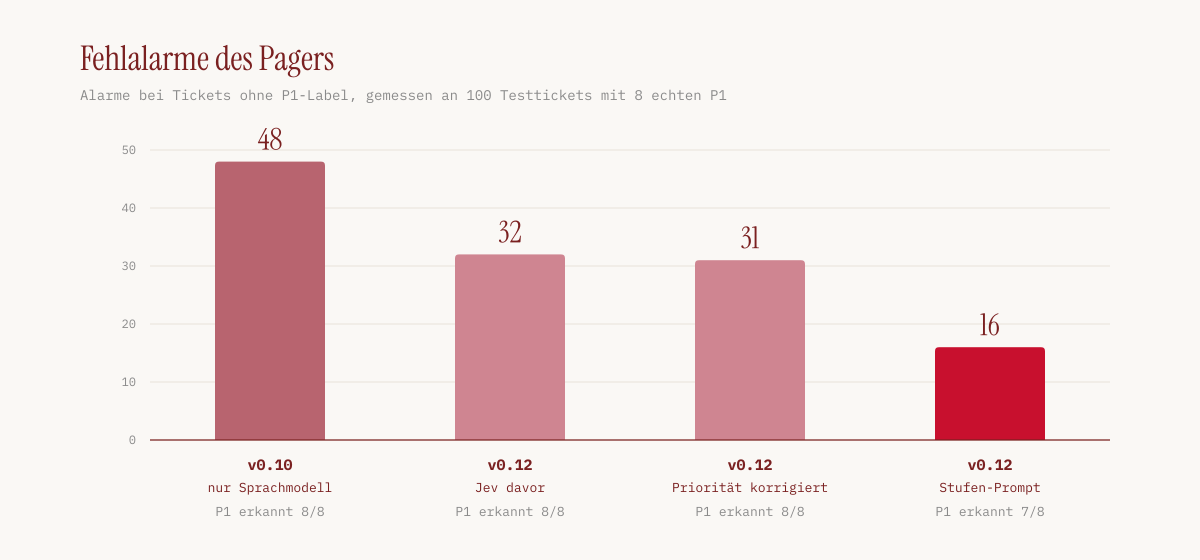
Der größere Befund betraf den Pager. Version 0.10 löste bei 48 Tickets einen Alarm aus, der kein P1 war. Mit Jev davor waren es 32, und alle 32 kamen aus dem Pfad, den weiter das Sprachmodell entscheidet. Die acht echten P1 wurden in beiden Versionen erkannt.
Die Ursache lag im Prompt aus Artikel 6. Er setzt p1_suspected, wenn ein Ticket auf einen Produktivausfall „hindeutet“, wenn Datenverlust „droht“ oder ein Monatsabschluss „gefährdet“ ist. Dazu kommt eine Klausel, die „URGENT“ im Betreff zusammen mit konkretem Schaden als P1 wertet. Das Feld selbst ist ein Boolean. Ein Ticket, das ernst ist, aber kein P1, hat keine Antwort außer ja oder nein. Die Modelle haben sich im Zweifel für ja entschieden, vor allem, wenn das Ticket laut formuliert war.
Um zu prüfen, ob das an der Größe der lokalen Modelle liegt, habe ich denselben Prompt an Claude Haiku 4.5 und Opus 5.5 geschickt (über das Abo mit claude -p, ohne Werkzeuge und mit dem Klassifikator-Prompt als System-Prompt). Opus kam auf 30 Fehlalarme, Haiku auf 50, qwen2.5 mit 7 Milliarden Parametern auf 31. Mit diesem Prompt macht die Modellgröße keinen Unterschied.
Das ändert sich mit strengerer Formulierung. Eine Variante, die nur eingetretene Zustände als P1 zählt, senkte die Fehlalarme bei Opus auf 0 und bei Haiku auf 1. Beide verpassten dafür drei oder vier der acht echten P1. Die lokalen Modelle blieben bei 26 und 41 Fehlalarmen.
Die Lösung war eine Skala statt eines Schalters. Der neue Prompt verlangt ein Feld severity mit den Stufen P1 bis P4, beschrieben nach denselben Fakten wie in meiner Rubrik, und sagt ausdrücklich, dass mögliche Folgen nicht als eingetreten zählen. Damit hat ein ernstes Ticket einen Platz unterhalb von P1. Im Offline-Vergleich sanken die Fehlalarme bei qwen2.5 von 31 auf 16, alle acht P1 blieben erkannt.
Eine Lücke blieb im Modell selbst. qwen2.5 setzte severity bei 13 Tickets auf P1, p1_suspected aber bei 24, obwohl der Prompt beides gleichsetzt. Deshalb entscheidet im Workflow nicht mehr das Modell über den Pager, sondern ein Code-Node hinter der LLM-Chain:
// Pager nur bei severity P1: kleine Modelle setzen p1_suspected sonst auch bei P2
const o = $json.output ?? {};
const p1 = o.severity === 'P1';
return { json: { ...$json, output: { ...o, p1_suspected: p1, p1_reason: p1 ? (o.p1_reason ?? '') : '' } } };
Der Rest der Pipeline liest weiter p1_suspected und bleibt unverändert.
Die Bilanz im Live-Workflow
Alle Werte stammen aus Messläufen mit den 100 Tickets gegen den laufenden Workflow, jeweils ohne mitgeschickte Priorität. Jev lief über OpenRouter, die Sprachmodelle lokal auf dem Mac.
| v0.10, nur LLM | v0.12 mit Jev, erste Fassung | v0.12 mit Jev, korrigiert | |
|---|---|---|---|
| Kategorie richtig | 96 | 98 | 97 |
| Tickets beim Sprachmodell | 100 | 45 | 47 |
| echte P1 alarmiert | 8 von 8 | 8 von 8 | 7 von 8 |
| Fehlalarme | 48 | 32 | 16 |
| Jev-Priorität exakt | n. v. | 40 % | 63 % |
| Summe der Antwortzeiten | 399 s | 269 s | 243 s |
| Median bei Jev-Entscheidung | n. v. | 0,93 s | 0,80 s |
| Median beim Sprachmodell | 2,62 s | 3,57 s | 3,57 s |
Jev entscheidet gut die Hälfte der Tickets selbst und braucht dafür weniger als eine Sekunde, gemessen über den ganzen Workflow samt Pipeline und SAP-Anreicherung. Die Summe der Antwortzeiten sinkt um 39 Prozent. Die Fehlalarme sind auf ein Drittel gefallen. Davon gehen 16 auf Jev zurück und 15 auf den neuen Prompt, der auch ohne Jev wirkt. Das Ticket, das jetzt durchrutscht, ist TKT-0020, ein Zertifikat, dessen Schlüssel vermutlich gestohlen und das bereits gesperrt ist. Jev gab es mit einer P1-Wahrscheinlichkeit von 0,59 ab, das Sprachmodell stufte es unter P1 ein. Es ist als Grenzfall markiert, Fable 5.1 hatte es beim Abgleich als P2 eingestuft.
Die Tickets, die beim Sprachmodell landen, brauchen länger als früher der Durchschnitt aller Tickets. Den größten Teil erklärt der Jev-Aufruf, der davor läuft und im Median knapp eine Sekunde dauert. Ob die unsicheren Tickets auch für das Sprachmodell länger dauern, habe ich nicht getrennt gemessen.
Acht Cloud-Modelle und ein Router am selben Prompt
Lokal kostet ein Modellaufruf keine Token, dafür Hardware und Strom. Für den Vergleich mit Cloud-Modellen habe ich den neuen Prompt mit denselben 100 Tickets über OpenRouter an sechs kleine Modelle geschickt, dazu an den Auto Router von OpenRouter, der das Modell pro Anfrage selbst wählt. Anthropic-Modelle habe ich dabei ausgeschlossen, auch beim Auto Router, weil ich Haiku und Opus schon über das Abo gemessen hatte. Zwei große Modelle kamen als Referenz für die Kostenrechnung dazu. Der Pager gilt wie im Workflow bei severity P1. Die Kosten meldet OpenRouter pro Anfrage mit.
| Modell | Kategorie | Stufe exakt | echte P1 alarmiert | Fehlalarme | Median | Dollar je 1.000 Tickets |
|---|---|---|---|---|---|---|
| gpt-oss-20b (OpenAI) | 99 | 49 | 8/8 | 23 | 7,8 s | 0,08 |
| Ministral 8B (Mistral) | 98 | 34 | 8/8 | 28 | 1,0 s | 0,09 |
| Qwen3-8B, ohne Reasoning (Alibaba) | 99 | 48 | 7/8 | 21 | 1,7 s | 0,17 |
| GPT-6 Luna (OpenAI) | 99 | 80 | 4/8 | 0 | 2,6 s | 0,21 |
| DeepSeek V4 Flash (DeepSeek) | 99 | 76 | 8/8 | 4 | 5,1 s | 0,25 |
| Auto Router (OpenRouter) | 99 | 67 | 7/8 | 7 | 3,6 s | 0,32 |
| Gemini 3.1 Flash Lite (Google) | 99 | 78 | 7/8 | 6 | 1,0 s | 0,38 |
| GPT-6 Sol (OpenAI) | 97 | 79 | 2/8 | 0 | 2,8 s | 3,85 |
| Gemini 3.1 Pro Preview (Google) | 99 | 82 | 7/8 | 1 | 8,5 s | 13,65 |
Eigenmessung, 26. September 2026, Preise laut OpenRouter an diesem Tag.
Die Kategorie trifft jedes Modell fast immer. Die Unterschiede liegen beim Pager. Die kleinsten Modelle verhalten sich wie die lokalen, sie finden alle P1 und schlagen dafür 21- bis 28-mal falsch an, öfter als die lokale Kombination mit 16. GPT-6 Luna und GPT-6 Sol sind das Gegenstück, kaum ein Fehlalarm, aber die Hälfte oder mehr der echten P1 verpasst. Für einen Pager ist das die schlechtere Richtung.
DeepSeek V4 Flash findet alle acht P1 mit vier Fehlalarmen und ist damit das einzige Modell, das beides gut kann. Es denkt vor der Antwort nach, daher die fünf Sekunden. Gemini 3.1 Flash Lite liegt knapp dahinter und antwortet in einer Sekunde.
Der Auto Router hat 84 Anfragen an DeepSeek V4 Flash gegeben und 16 an Gemini 2.5 Flash. Er kostet dabei mehr als DeepSeek direkt und trifft etwas schlechter. Für eine feste Aufgabe mit festem Prompt lohnt sich die automatische Wahl nicht.
Wer Tickets an Cloud-Modelle schickt, gibt ihren Inhalt an den jeweiligen Anbieter weiter. OpenRouter kann das Routing auf Anbieter mit passenden Datenrichtlinien beschränken. Für Kundendaten gehört diese Einstellung vor den Kostenvergleich.
1.000 Tickets am Tag über API-Token
Für die Hochrechnung habe ich jedes Modell zweimal gerechnet. Einmal bekommt es alle Tickets. Einmal sitzt Jev davor, und das Modell bekommt nur die 47 Tickets, die Jev im Live-Lauf abgegeben hat. Die Jev-Kosten sind dann für alle 1.000 Tickets eingerechnet. Kategorie und Pager des kombinierten Aufbaus sind aus den echten Antworten beider Seiten zusammengesetzt.
| Modell | nur LLM, pro Jahr | mit Jev, pro Jahr | Ersparnis | mit Jev: P1 / Fehlalarme |
|---|---|---|---|---|
| gpt-oss-20b | 31 $ | 30 $ | 2 % | 8/8 / 19 |
| Ministral 8B | 34 $ | 30 $ | 11 % | 8/8 / 25 |
| Qwen3-8B | 61 $ | 43 $ | 29 % | 7/8 / 17 |
| GPT-6 Luna | 77 $ | 53 $ | 31 % | 5/8 / 0 |
| DeepSeek V4 Flash | 92 $ | 67 $ | 27 % | 8/8 / 4 |
| Auto Router | 117 $ | 75 $ | 35 % | 7/8 / 7 |
| Gemini 3.1 Flash Lite | 139 $ | 80 $ | 42 % | 7/8 / 6 |
| GPT-6 Sol | 1.404 $ | 694 $ | 51 % | 3/8 / 0 |
| Gemini 3.1 Pro Preview | 4.982 $ | 2.482 $ | 50 % | 7/8 / 1 |
1.000 Tickets pro Tag, 365 Tage, Preise vom 26. September 2026. Jev allein kostet dabei 14 Dollar im Jahr.
Die Ersparnis liegt unter den 53 Prozent, die Jev dem Sprachmodell abnimmt. Die Tickets, die beim Modell bleiben, sind die schwierigen, und bei Modellen mit Reasoning kosten sie mehr Token als der Durchschnitt. Bei den billigsten Modellen frisst Jev seinen eigenen Vorteil fast auf, bei gpt-oss-20b bleiben 2 Prozent. Je teurer das Modell, desto näher kommt die Ersparnis an die Hälfte.
In absoluten Zahlen ist die Klassifikation mit kleinen Modellen billig. DeepSeek V4 Flash kostet für 1.000 Tickets am Tag weniger als 100 Dollar im Jahr, mit Jev davor 67 Dollar. Wer ein großes Modell einsetzt, weil es beim Pager verlässlicher sein soll, zahlt dagegen Tausende im Jahr. Dass sich das nicht auszahlt, zeigt die Tabelle. Gemini 3.1 Pro trifft die Stufe etwas öfter und schlägt seltener falsch an, verpasst aber ein P1, das DeepSeek V4 Flash findet. Für das Fünfzigfache der Kosten ist das kein Gewinn, und GPT-6 Sol verpasst die meisten P1.
Bei der Zeit ist der Unterschied deutlicher als beim Geld. Lokal brauchte Version 0.10 im Schnitt 4,0 Sekunden pro Ticket, bei 1.000 Tickets am Tag sind das 67 Minuten Rechenzeit. Mit Jev sind es 2,4 Sekunden und 40 Minuten. Mit DeepSeek V4 Flash in der Cloud spart die Hälfte der Tickets die fünf Sekunden Nachdenken, weil Jev sie in unter einer Sekunde erledigt.
Grenzen der Messung
Die Zahlen stammen aus 100 synthetischen Tickets und aus Labels, die ein Sprachmodell nach einer festen Rubrik gesetzt hat. Acht P1 sind wenig. Ein einziges Ticket verschiebt die Erkennungsrate um 12,5 Prozentpunkte, und von den 15 Grenzfällen hängt ab, ob ein Modell als vorsichtig oder als nachlässig dasteht. Die ITIL-Matrix habe ich nicht an die Daten angepasst. Der neue Prompt dagegen ist aus genau diesen Fehlalarmen entstanden, und auch der Cloud-Vergleich läuft mit ihm. Auf echten Tickets gehört beides neu gemessen.
Die Cloud-Preise gelten für den 26. September 2026. Einige der Modelle sind erst seit wenigen Wochen verfügbar, Preise und Verhalten können sich ändern. Die Hochrechnung setzt voraus, dass echte Tickets ähnlich lang sind wie die Testtickets und Jev einen ähnlichen Anteil selbst entscheidet.
Zwei Signale für den Grenzbereich
Der Workflow entscheidet jetzt gut die Hälfte der Tickets ohne Sprachmodell, alarmiert ein Drittel so oft falsch wie vorher und findet sieben von acht P1. Offen ist der Pager im Grenzbereich. Der P1-Verdacht von Jev und die Stufe des Sprachmodells sind zwei unabhängige Signale. Ob eine Kombination beider das verpasste Ticket findet, ohne die Fehlalarme wieder zu erhöhen, ist die nächste Messung. Ein Vorfilter spart Aufrufe. Weniger Fehlalarme gab es erst, als das Modell nicht mehr selbst über den Pager entschied.
Die Prüfskripte, die Labels mit Rubrik und der Sub-Workflow liegen im Demo-Repo n8n-einstieg unter dem Tag v0.12.
← Advanced Topics 1: Was ein Agent sich merkt
Quellen
- Jev im Test: ein Modell, das entscheidet, statt zu schreiben, eigener Artikel mit den Grundlagen zu Jev
- TypeSafe: Primitives, Fragetypen Choice, Score und Noul
- OpenRouter: Jev, Zugang über OpenRouter
- OpenRouter: Auto Router, Einschränkung der Modellwahl mit
allowed_models - OpenRouter: Provider Routing, Filter nach Datenrichtlinien
- OpenRouter: Modelle und Preise, Stand 26. September 2026