Next-Concept Modeling: Von der Skizze zum klaren Text
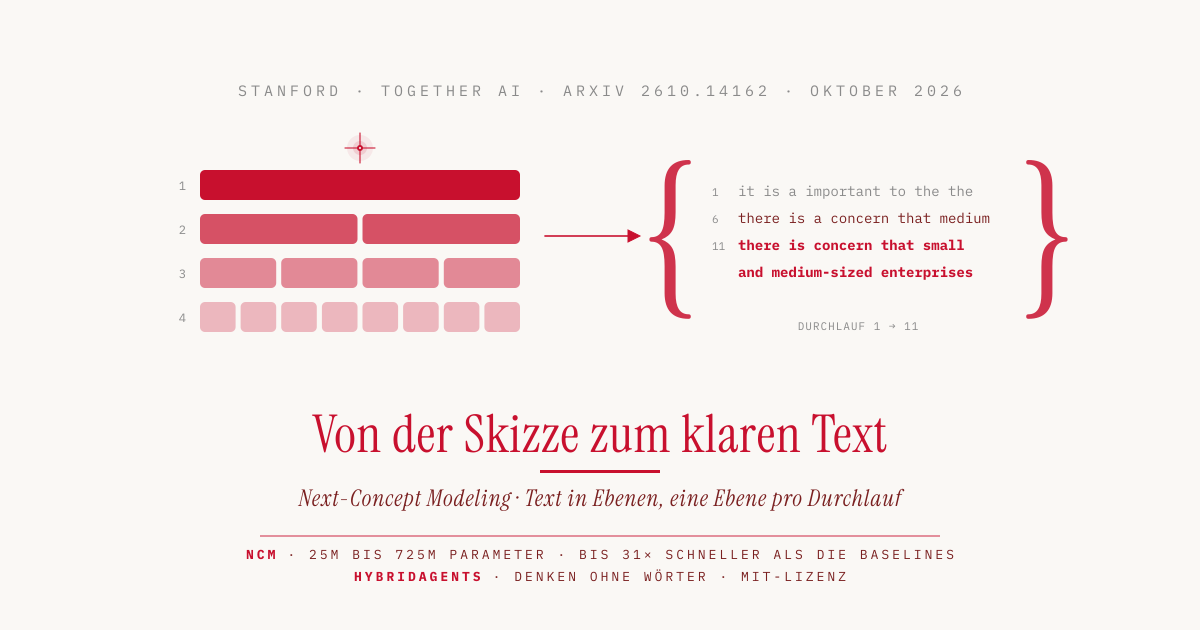
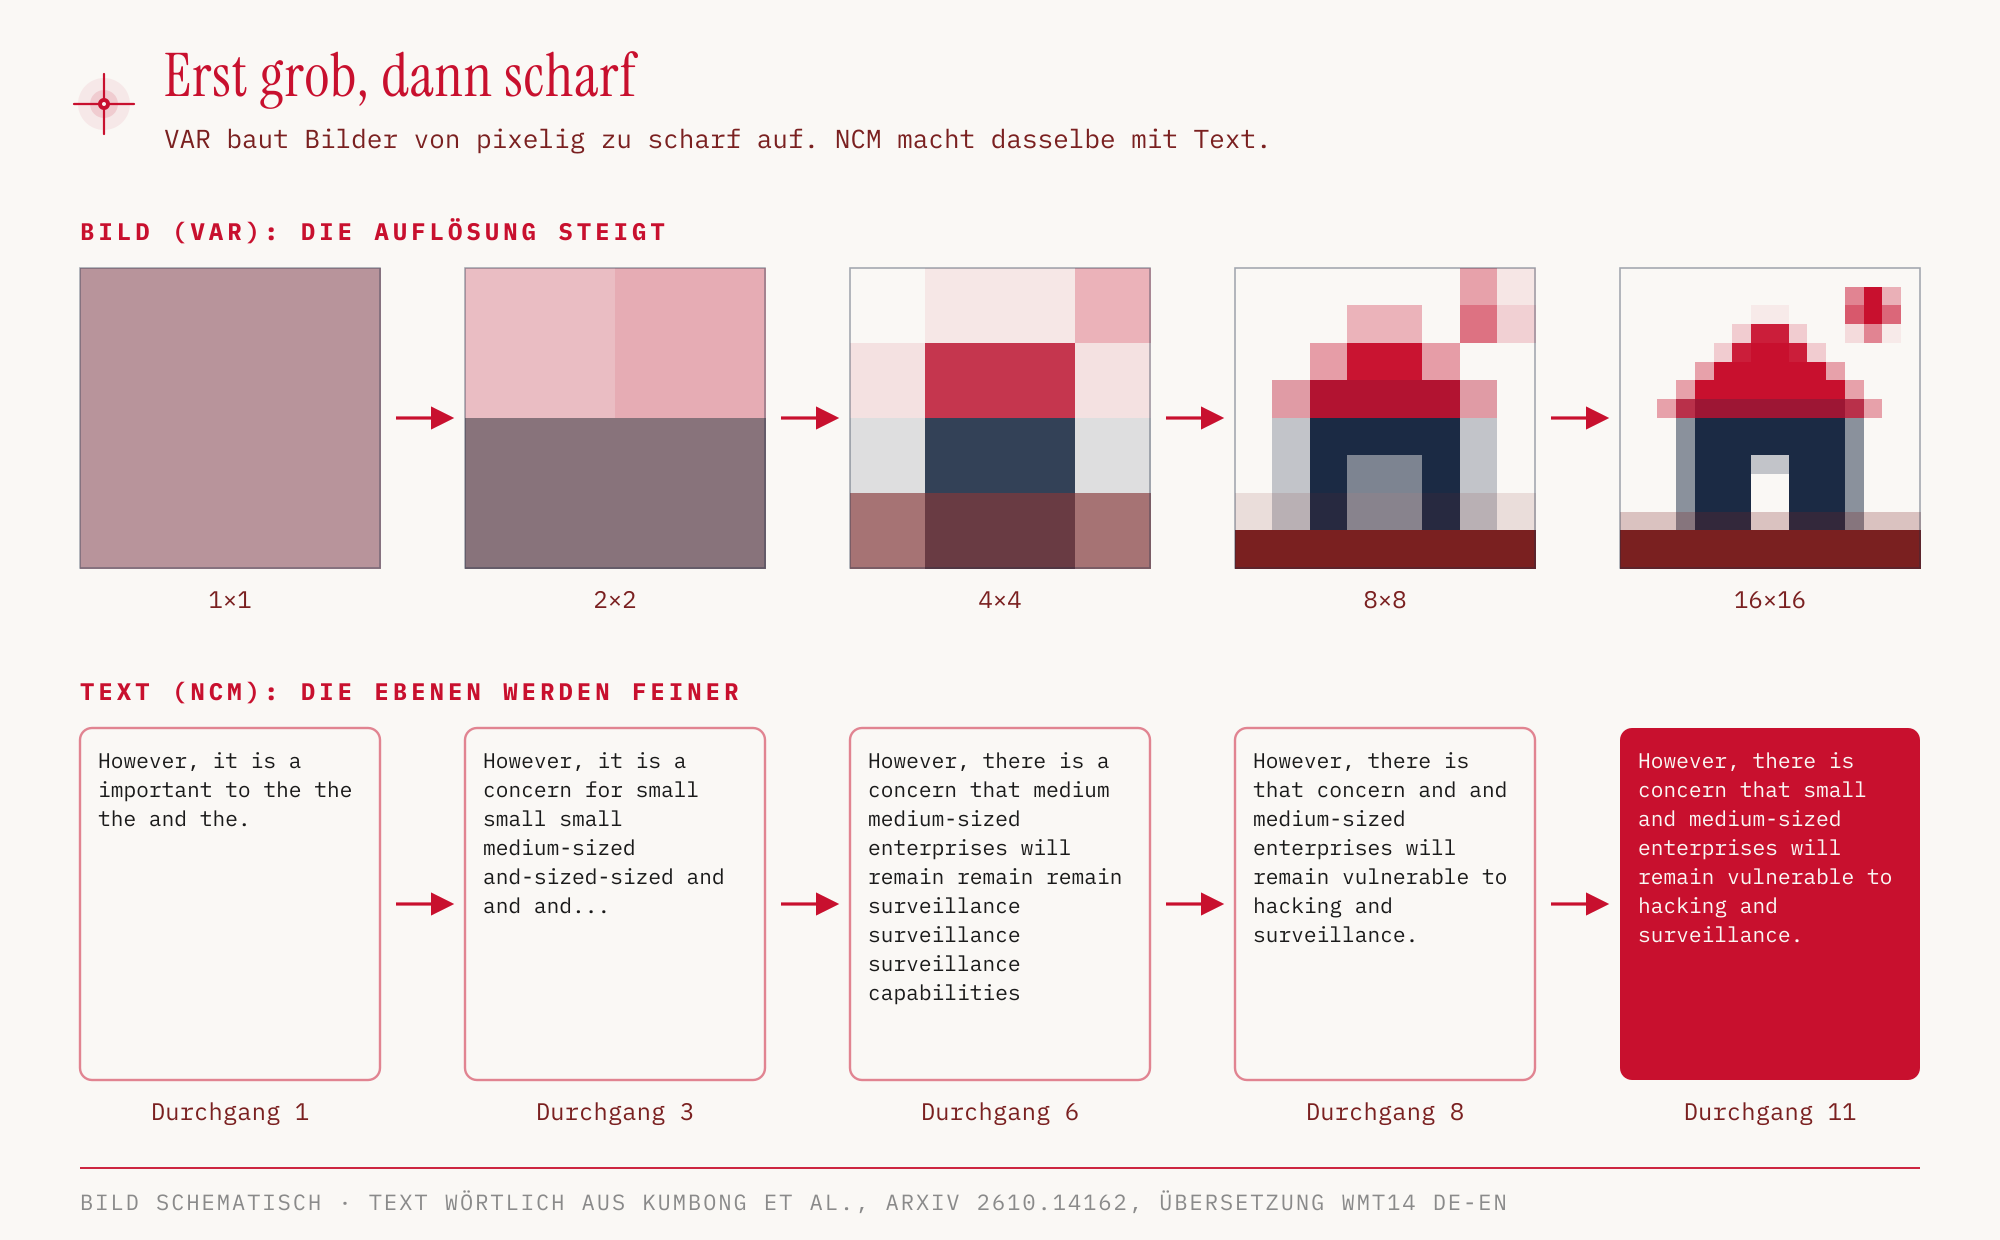
„However, it is a important to the the the and the." So sieht eine Übersetzung aus, nachdem ein Modell den ersten von elf Durchgängen erledigt hat. Nach dem elften steht da „However, there is concern that small and medium-sized enterprises will remain vulnerable to hacking and surveillance." Der Satz stammt aus dem Paper zu Next-Concept Modeling (NCM), das ein Team von Stanford und Together AI am 9. Oktober 2026 auf arXiv gestellt hat. Die Idee ist aus der Bildgenerierung entlehnt: erst eine grobe Skizze des ganzen Textes, dann schärfen, und zwar überall gleichzeitig.
Ein Token nach dem anderen
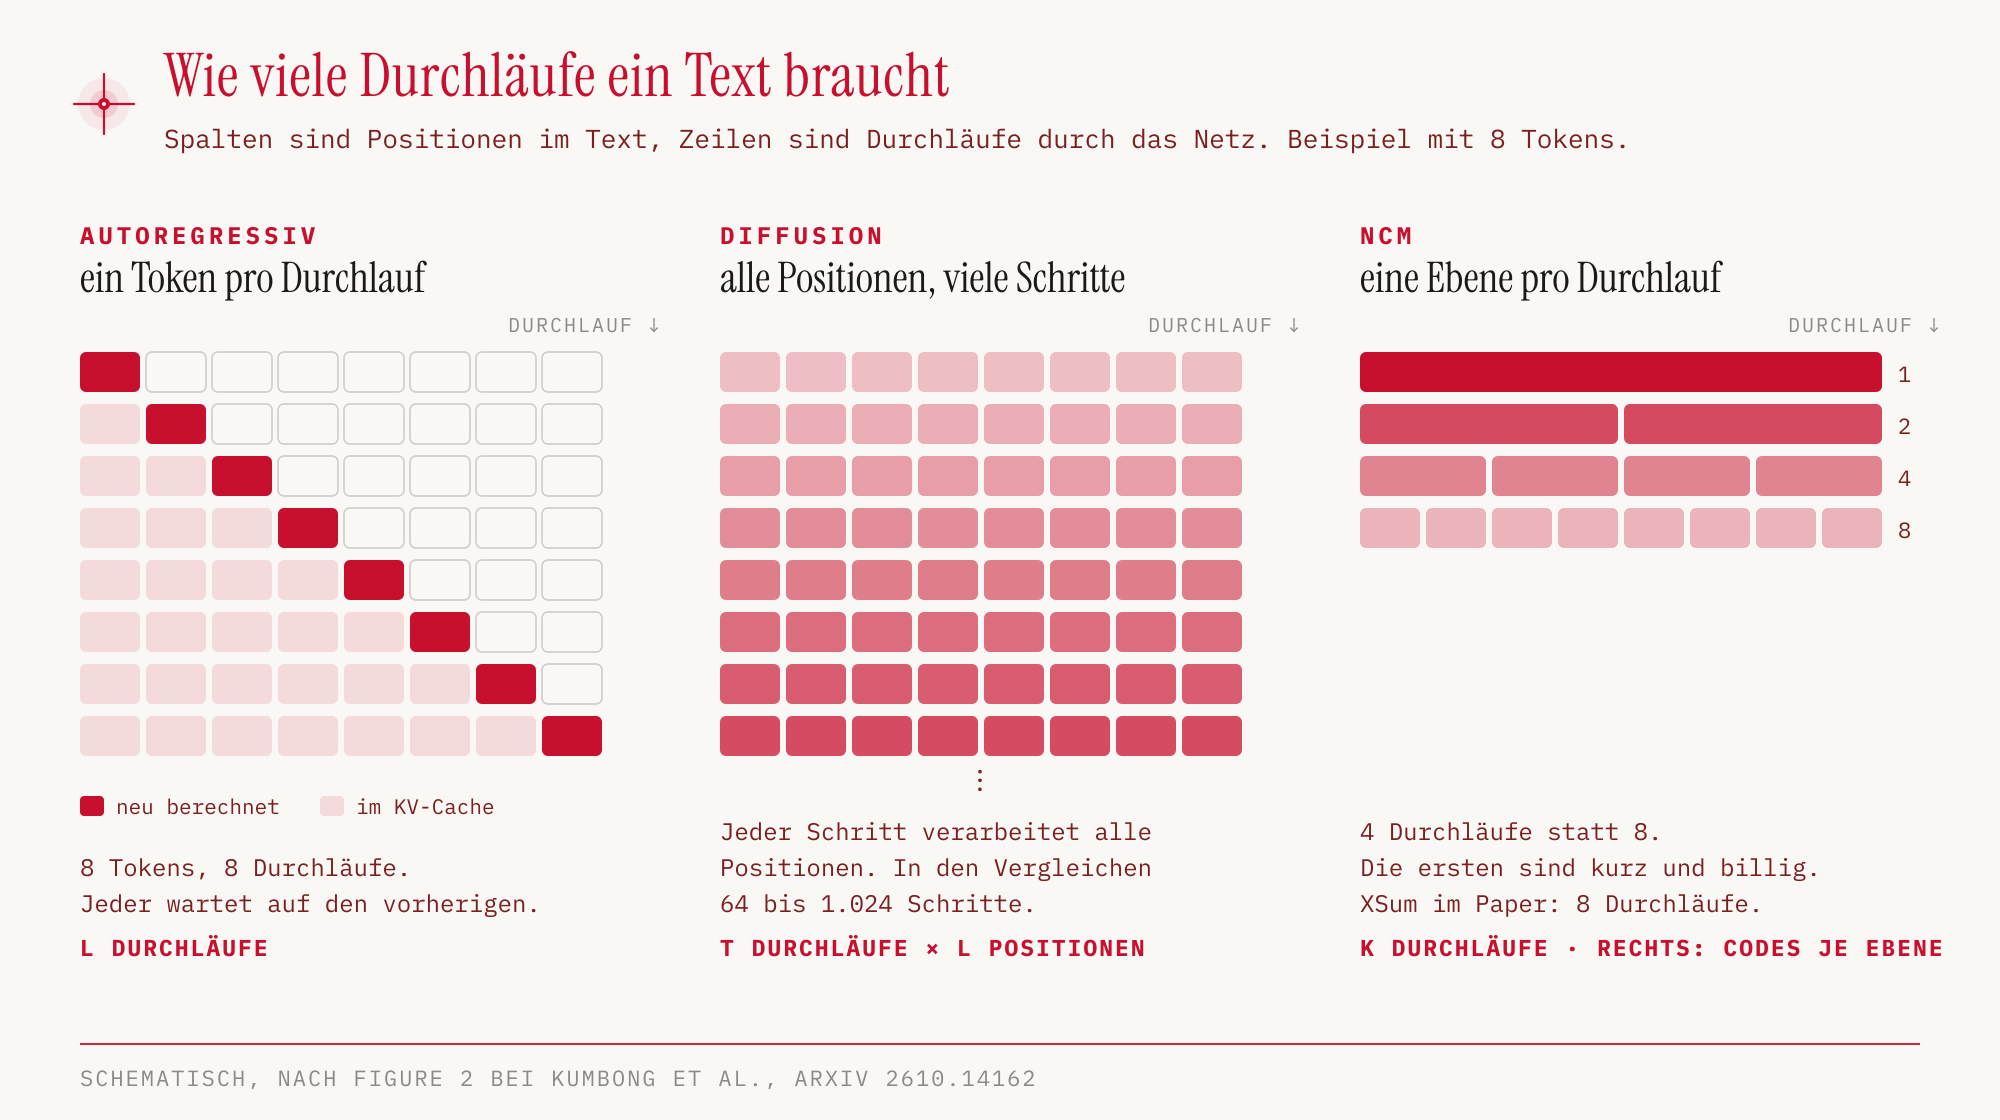
Fast jedes Sprachmodell, mit dem wir heute arbeiten, ist autoregressiv. Es sagt das nächste Token voraus, hängt es an den Text an und rechnet dann erneut. Ein Satz mit zwölf Tokens braucht zwölf Durchläufe durch das Netz, und jeder wartet auf den vorherigen. Reasoning-Modelle verlängern diese Kette, weil sie auch ihr Nachdenken in Tokens schreiben. OpenAI hält in seinem Reasoning-Leitfaden fest, dass diese Tokens über die API nicht sichtbar sind, trotzdem Platz im Kontextfenster belegen und als Output abgerechnet werden.
Die Kette ist das Grundproblem. Speculative Decoding und Multi-Token-Prediction mildern es, indem sie mehrere Tokens raten und in einem Durchlauf prüfen (wie das lokal aussieht, steht im MTP-Test auf dem M3 Max). Am Prinzip ändern sie nichts. Der Text entsteht von links nach rechts, und ein Token, das einmal steht, bleibt stehen.
Diffusion als bisherige Alternative
Die bekannteste Alternative sind Diffusions-Sprachmodelle. Sie beginnen mit einer Sequenz aus maskierten oder verrauschten Positionen und entrauschen alle Positionen in mehreren Schritten gleichzeitig. Das ist längst keine reine Forschung mehr. Das NCM-Paper nennt LLaDA als offenes Modell mit Milliarden Parametern sowie Mercury und DiffusionGemma als Systeme im Produktivbetrieb.
Die Autoren sehen bei diesen Modellen folgende Schwächen, die NCM beheben soll:
- Viele Schritte. Wer die Zahl der Entrauschungsschritte senkt, verliert schnell an Qualität.
- Teure Schritte. Jeder Schritt verarbeitet die volle Sequenzlänge, und die bidirektionale Attention verhindert, dass der KV-Cache, also der Zwischenspeicher für bereits berechnete Positionen, wie bei autoregressiven Modellen wiederverwendet wird.
- Großes Trainingsbudget. Starke Baselines wie MDLM und DUO laufen auf OpenWebText eine Million Schritte und sehen dabei über 500 Milliarden Tokens.
Entsprechend sind die Geschwindigkeitsvergleiche im Paper aufgebaut. NCM tritt gegen Diffusions- und Flow-Modelle ähnlicher Größe an. Flow-Modelle sind eng verwandt mit Diffusion, sie lernen einen kontinuierlichen Weg vom Rauschen zum Text. Autoregressive Modelle tauchen nur in den Qualitätsvergleichen auf, nicht in den Laufzeitmessungen.
Text als Stapel von Korrekturen
NCM arbeitet in zwei Stufen. Die erste ist ein eigener Tokenizer, der Text nicht in Wortstücke zerlegt, sondern in eine Hierarchie diskreter Codes. Technisch ist das ein multiscale residual VQ-VAE. Der Name klingt schwerer, als die Idee ist.
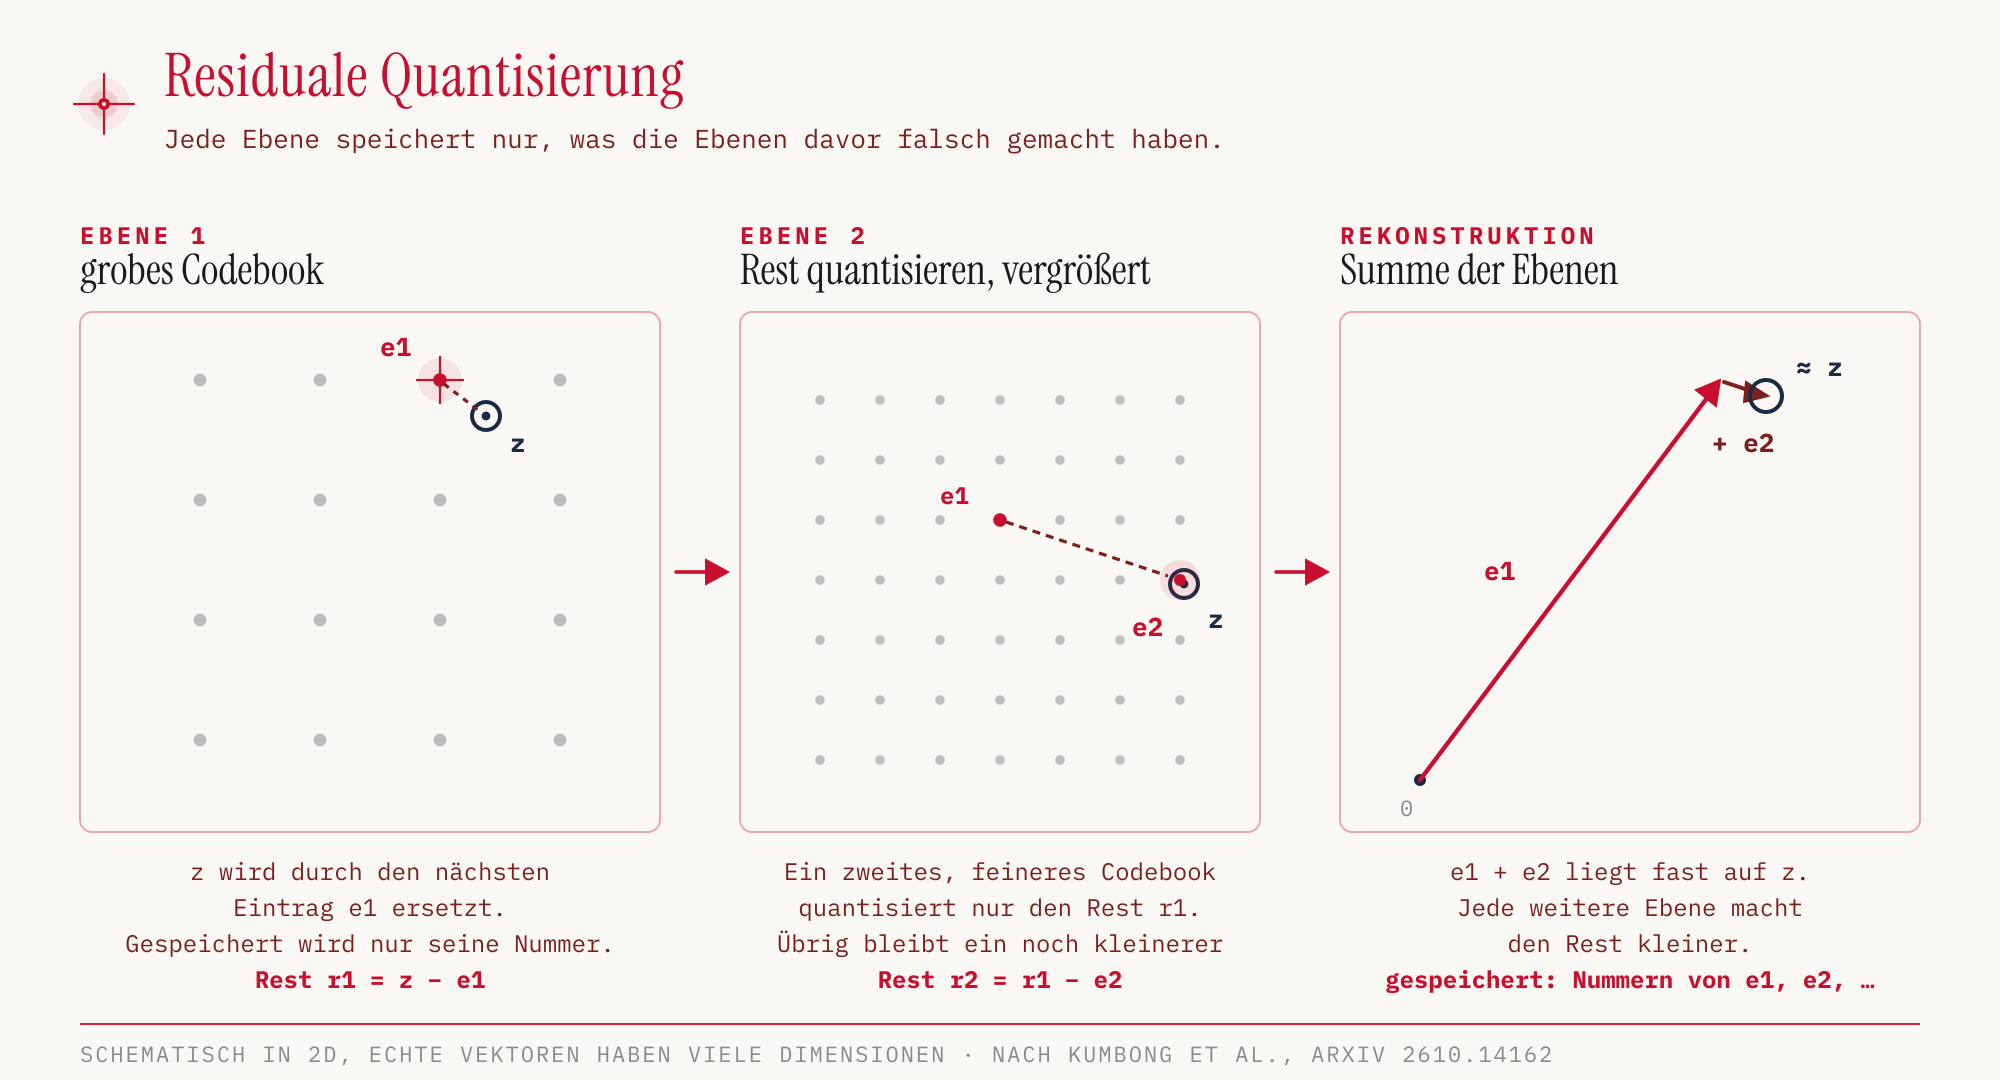
Ein Encoder macht aus jedem Token einen Vektor, also einen Punkt im Raum, wie bei Embeddings. Vektorquantisierung ersetzt jeden dieser Vektoren durch den nächstgelegenen Eintrag aus einem festen Wörterbuch von Vektoren, dem Codebook. Danach genügt die Nummer des Eintrags.
Das ist verlustbehaftet, es bleibt ein Rest. Residuale Quantisierung nimmt genau diesen Rest und quantisiert ihn mit einem zweiten Codebook, dann den Rest davon mit einem dritten und so weiter. Jede Ebene speichert nur, was die Ebenen darüber falsch gemacht haben. Das Verfahren stammt aus Bild- und Audio-Codecs.
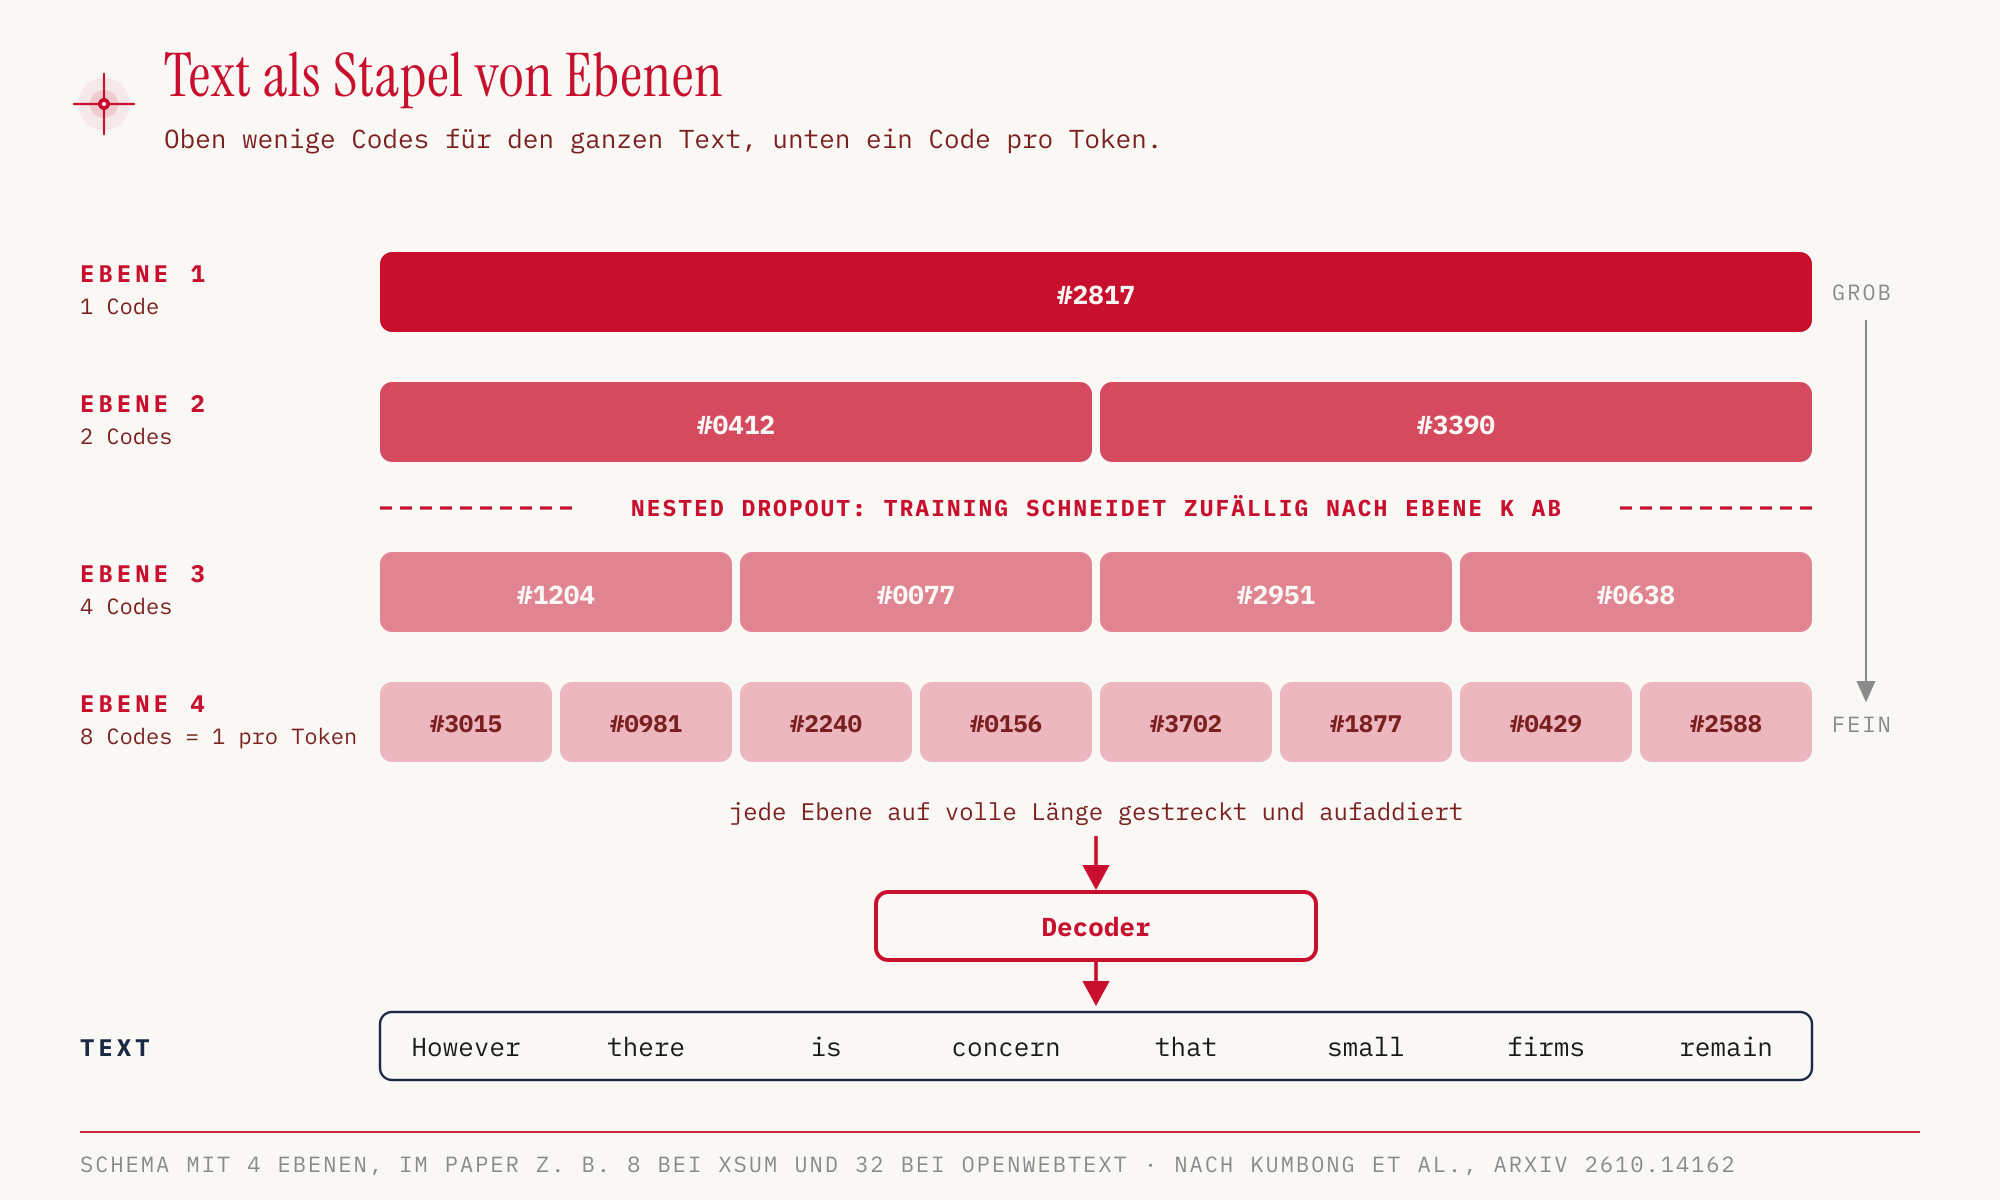
NCM kombiniert das mit unterschiedlichen Längen. Die oberste Ebene besteht nur aus wenigen Codes für den ganzen Text, jede tiefere Ebene ist länger, die unterste hat genau einen Code pro Token. Bevor eine Ebene quantisiert wird, wird der Rest auf ihre Länge heruntergerechnet, danach wieder auf volle Textlänge gestreckt und zur bisherigen Rekonstruktion addiert. Die Summe aller Ebenen ergibt den Text. Die oberen Ebenen enthalten das, was die Autoren „Konzept" nennen, also die grobe Information über den ganzen Abschnitt. Mit Konzepten im Sinne von Begriffen oder Ideen hat der Name nur lose zu tun.
Damit die groben Ebenen tatsächlich etwas Sinnvolles speichern, trainieren die Autoren mit nested dropout. Im Training wird die Hierarchie zufällig nach der k-ten Ebene abgeschnitten, und der Decoder muss den Text aus diesem Teilstapel rekonstruieren. Die oberen Ebenen können sich deshalb nicht darauf verlassen, dass die unteren die Arbeit erledigen.
Die Rekonstruktion ist fast verlustfrei, gemessen als exakt wiederhergestellte Tokens auf zurückgehaltenen Daten (Angaben der Autoren):
| Datensatz | Rekonstruktion | Codebook-Nutzung |
|---|---|---|
| OpenWebText | 99,99 % | 83 % |
| LM1B | 99,86 % | 89 % |
| TinyStories | 99,98 % | 90 % |
| XSum (Zusammenfassungen) | 99,79 % | 86 % |
| WMT14 (Übersetzung De-En) | 98,79 % | 62 % |
| Sudoku | 100 % | 81 bis 84 % |
Die Autoren weisen selbst darauf hin, warum das wichtiger ist als bei Bildern. Ein falsches Pixel sieht niemand, ein falsches Token kann den Sinn eines Satzes ändern oder eine Sudoku-Lösung ungültig machen. Die beobachteten Fehler sind meist Verwechslungen verwandter Wörter oder Namen.
Eine Ebene pro Durchgang
Die zweite Stufe ist der eigentliche Generator, ein Transformer, der bei eingefrorenem Tokenizer trainiert wird. Er erzeugt die Hierarchie von oben nach unten. In jedem Schritt sieht er die bisherige Rekonstruktion aus allen gröberen Ebenen und sagt alle Codes der nächsten Ebene gleichzeitig voraus. Bei K Ebenen braucht ein Text K Durchläufe, egal wie viele Tokens er hat. Die ersten Durchläufe sind zudem billig, weil die groben Ebenen kurz sind. Am Ende übersetzt der Decoder des Tokenizers die vollständige Rekonstruktion zurück in Tokens.
Das Vorbild ist VAR (Tian et al., 2024), ein Bildmodell, das ein Bild erst in sehr niedriger Auflösung und dann Stufe für Stufe feiner erzeugt. Für Text fehlt allerdings das natürliche Gegenstück zum Herunterskalieren eines Bildes. Was „grob" bei einem Satz bedeutet, muss der Tokenizer erst lernen.
Gegen Fehler, die sich beim Generieren aufschaukeln, setzen die Autoren einen weiteren Trick ein. Im Training sieht der Generator immer die korrekten gröberen Ebenen, beim Generieren nur seine eigenen, womöglich falschen Vorhersagen. Die Autoren ersetzen deshalb im Training einen Teil der Eingabe-Codes absichtlich durch andere Codes desselben Codebooks, bei groben Ebenen öfter als bei feinen. Die Zielwerte bleiben korrekt. Laut den Ablationsversuchen, in denen jeweils ein Baustein verändert wird, verbessert moderates Verfälschen die Qualität deutlich, zu viel davon schadet.
Wie das beim Generieren aussieht, zeigt der Übersetzungsverlauf aus dem Anhang des Papers. Die BLEU-Werte messen die Übereinstimmung mit der Referenzübersetzung:
| Durchgang | Ausgabe | BLEU |
|---|---|---|
| 1 | However, it is a important to the the the and the. | |
| 3 | However, it is a concern for small small small medium-sized and-sized-sized and and and… | |
| 8 | However, there is that concern and and medium-sized enterprises will remain vulnerable to hacking and surveillance. | 51,7 |
| 9 | However, there is that that small and medium-sized enterprises will remain vulnerable to to and surveillance. | 38,9 |
| 11 | However, there is concern that small and medium-sized enterprises will remain vulnerable to hacking and surveillance. | 77,8 |
Die Zwischenstände werden nicht stetig besser, Durchgang 9 ist schlechter als Durchgang 8. Das Paper vermerkt das ausdrücklich. Meine Lesart: Jede Ebene korrigiert die Summe der vorherigen, und eine Korrektur kann vorübergehend etwas verschlechtern, das am Ende stimmt. Das Paper vermerkt außerdem gelegentliche Artefakte an den Übergängen zwischen groben Ebenen.
Die Zahlen gegen Diffusionsmodelle
Die Hauptmodelle haben etwa 100 Millionen Parameter. Gemessen wurde die Laufzeit für 1.024 Sequenzen bei Batchgröße 16 auf einer einzelnen Nvidia H100 SXM. Alle Zahlen sind Angaben der Autoren aus einem Preprint ohne Peer Review.
| Datensatz | Stärkste Baseline | Durchläufe (NFE) | Tempo | Qualität |
|---|---|---|---|---|
| LM1B | DUO (Diffusion) | 11× weniger | 21× schneller | bessere Perplexity |
| OpenWebText | stärkstes Diffusionsmodell | 32 statt 1.024 | 10× schneller | vergleichbar |
| XSum | AURORA-LM (Flow) | 16× weniger | 31× schneller | vergleichbares ROUGE-L |
NFE steht für number of function evaluations, also die Zahl der Durchläufe durch das Netz. Die Geschwindigkeit kommt aus weniger und aus billigeren Schritten. ROUGE-L misst, wie gut eine Zusammenfassung mit der Referenz übereinstimmt. Bei XSum braucht NCM ohne weitere Tricks 8 Durchläufe für ein ROUGE-L von 28,0, AURORA-LM braucht 128 für 26,6.
Die gesparte Zeit lässt sich wieder in Qualität umsetzen. Mit Minimum Bayes Risk Decoding erzeugt NCM mehrere Kandidaten und wählt den, der den anderen im Schnitt am ähnlichsten ist. Mit 16 Kandidaten kommt NCM auf XSum auf ein ROUGE-L von 29,6 bei 128 Durchläufen und liegt damit vor AURORA-LM mit Guidance (28,6 bei 184 Durchläufen).
Beim Training spart NCM ebenfalls. Auf LM1B verarbeiten Tokenizer und Generator zusammen 13,36 Milliarden Token-Positionen, die Diffusions-Baselines 66 Milliarden, also etwa 4,9-mal mehr. Die Autoren vermuten als Grund, dass eine feste Reihenfolge von grob nach fein leichter zu lernen ist als die vielen möglichen Reihenfolgen eines Diffusionsmodells. Das ist als Vermutung formuliert, nicht als Befund.
Bei der Übersetzung liegt NCM hinten:
| Modell | Größe | BLEU (WMT14 De-En) | Durchläufe |
|---|---|---|---|
| Autoregressiv | 99M | 25,2 | 64 |
| E2D2 (Diffusion) | 99M | 24,8 | 64 |
| NCM | 120M | 22,6 | 11 |
| NCM mit MBR | 120M | 25,2 | 132 |
| ELF mit Guidance (Flow) | 140M | 26,4 | 128 |
Ohne Zusatzverfahren verliert NCM gegen ein kleines autoregressives Modell und gegen das beste Diffusionsmodell, braucht dafür aber nur ein Sechstel der Durchläufe. Wer die Qualität des autoregressiven Modells will, landet mit MBR wieder bei mehr Durchläufen als dieses.
Sudoku als Härtetest
Der auffälligste Befund betrifft kein Sprachproblem. Bei Sudoku muss jede Zahl gleichzeitig Zeile, Spalte und Block erfüllen, und eine einzige falsche Ziffer macht die Lösung wertlos. Die Modelle sind hier winzig, rund 25 Millionen Parameter. Die Schwierigkeit ergibt sich aus der Zahl der vorgegebenen Felder (40, 35 und 30).
| Modell | Größe | Durchläufe | Leicht | Mittel | Schwer |
|---|---|---|---|---|---|
| Autoregressiv (greedy) | 25M | 128 | 14,6 % | 5,1 % | 1,0 % |
| MDLM (Diffusion) | 29M | 128 | 92,0 % | 77,1 % | 30,2 % |
| FMLM+ (Flow) | 29M | 16 | 97,7 % | 92,8 % | 81,3 % |
| NCM | 25M | 12 | 99,5 % | 96,5 % | 86,1 % |
Das autoregressive Modell löst ein Prozent der schweren Rätsel, NCM 86 Prozent. Die Erklärung der Autoren ist plausibel. Ein Modell, das von links nach rechts schreibt, legt sich auf jede Ziffer fest, bevor es den Rest des Bretts kennt, und kann sie nicht mehr zurücknehmen. NCM arbeitet auf jeder Ebene am ganzen Brett und kann frühere Teillösungen korrigieren. Im Beispiel aus dem Anhang stimmen im dekodierten Brett nach den ersten drei Schritten nur 15 bis 16 der 81 Felder mit der Lösung überein, die Vorgaben mitgezählt. Nach dem zwölften stimmen alle.
Der Abstand zu den Diffusions- und Flow-Modellen ist allerdings deutlich kleiner als zum autoregressiven Modell. FMLM+ löst 81 Prozent der schweren Bretter. Der Sudoku-Befund spricht vor allem gegen strenges Links-nach-rechts bei Aufgaben mit globalen Abhängigkeiten. Er zeigt nicht, dass NCM allen parallelen Verfahren weit voraus ist.
Wie praxistauglich ist NCM heute
NCM entwickelt die parallele Textgenerierung weiter und steht damit noch am Anfang. Die Grenzen benennt das Paper größtenteils selbst:
- Größe. Die Hauptmodelle haben rund 100 Millionen Parameter, das größte getestete 725 Millionen. Aktuelle Chatmodelle sind um Größenordnungen größer. Ob die Vorteile mit der Größe wachsen, schrumpfen oder bleiben, ist offen. Die Skalierungsergebnisse bis 725M nennen die Autoren selbst vorläufig.
- Feste Form. Die Zahl der Ebenen und die Länge jeder Ebene sind fest. Jeder Datensatz hat eine feste Ziellänge, und auch eine kurze Fortsetzung durchläuft die ganze Hierarchie. Für einen Chat, dessen Antwort mal einen Satz und mal drei Seiten lang ist, fehlt damit ein wesentlicher Baustein.
- Ein Modell pro Aufgabe. Für jeden Datensatz wurden ein eigener Tokenizer und ein eigener Generator trainiert. Ein allgemeines Modell, das übersetzt, zusammenfasst und Rätsel löst, gibt es nicht.
- Zwei getrennte Trainingsstufen. Der Tokenizer wird unabhängig vom Generator gelernt. Ein gemeinsames Training nennen die Autoren als Verbesserungsmöglichkeit.
- Vergleichsklasse. Alle Geschwindigkeitsvergleiche laufen gegen Diffusions- und Flow-Modelle. Gegen ein optimiertes autoregressives Modell mit KV-Cache gibt es keine Laufzeitmessung.
Als eine Richtung nennen die Autoren einen Ablauf, bei dem Zahl und Länge der Ebenen von der Eingabe abhängen, damit einfache Texte weniger Rechenaufwand kosten als schwierige. Erst so ein Baustein könnte NCM für offene Textlängen brauchbar machen.
Ein Agent, der ohne Wörter denkt
Vier Tage nach NCM, am 13. Oktober 2026, erschien ein zweites Preprint, ebenfalls mit Stanford und Together AI, dazu UIUC und Meta. Hybrid Reasoning Agents (Projektleitung laut Paper: Jiaru Zou) setzt nicht beim Schreiben an, sondern beim Denken. Die beiden Arbeiten teilen keine Technik, aber sie greifen dieselbe Gewohnheit an, alles in Tokens auszuformulieren.
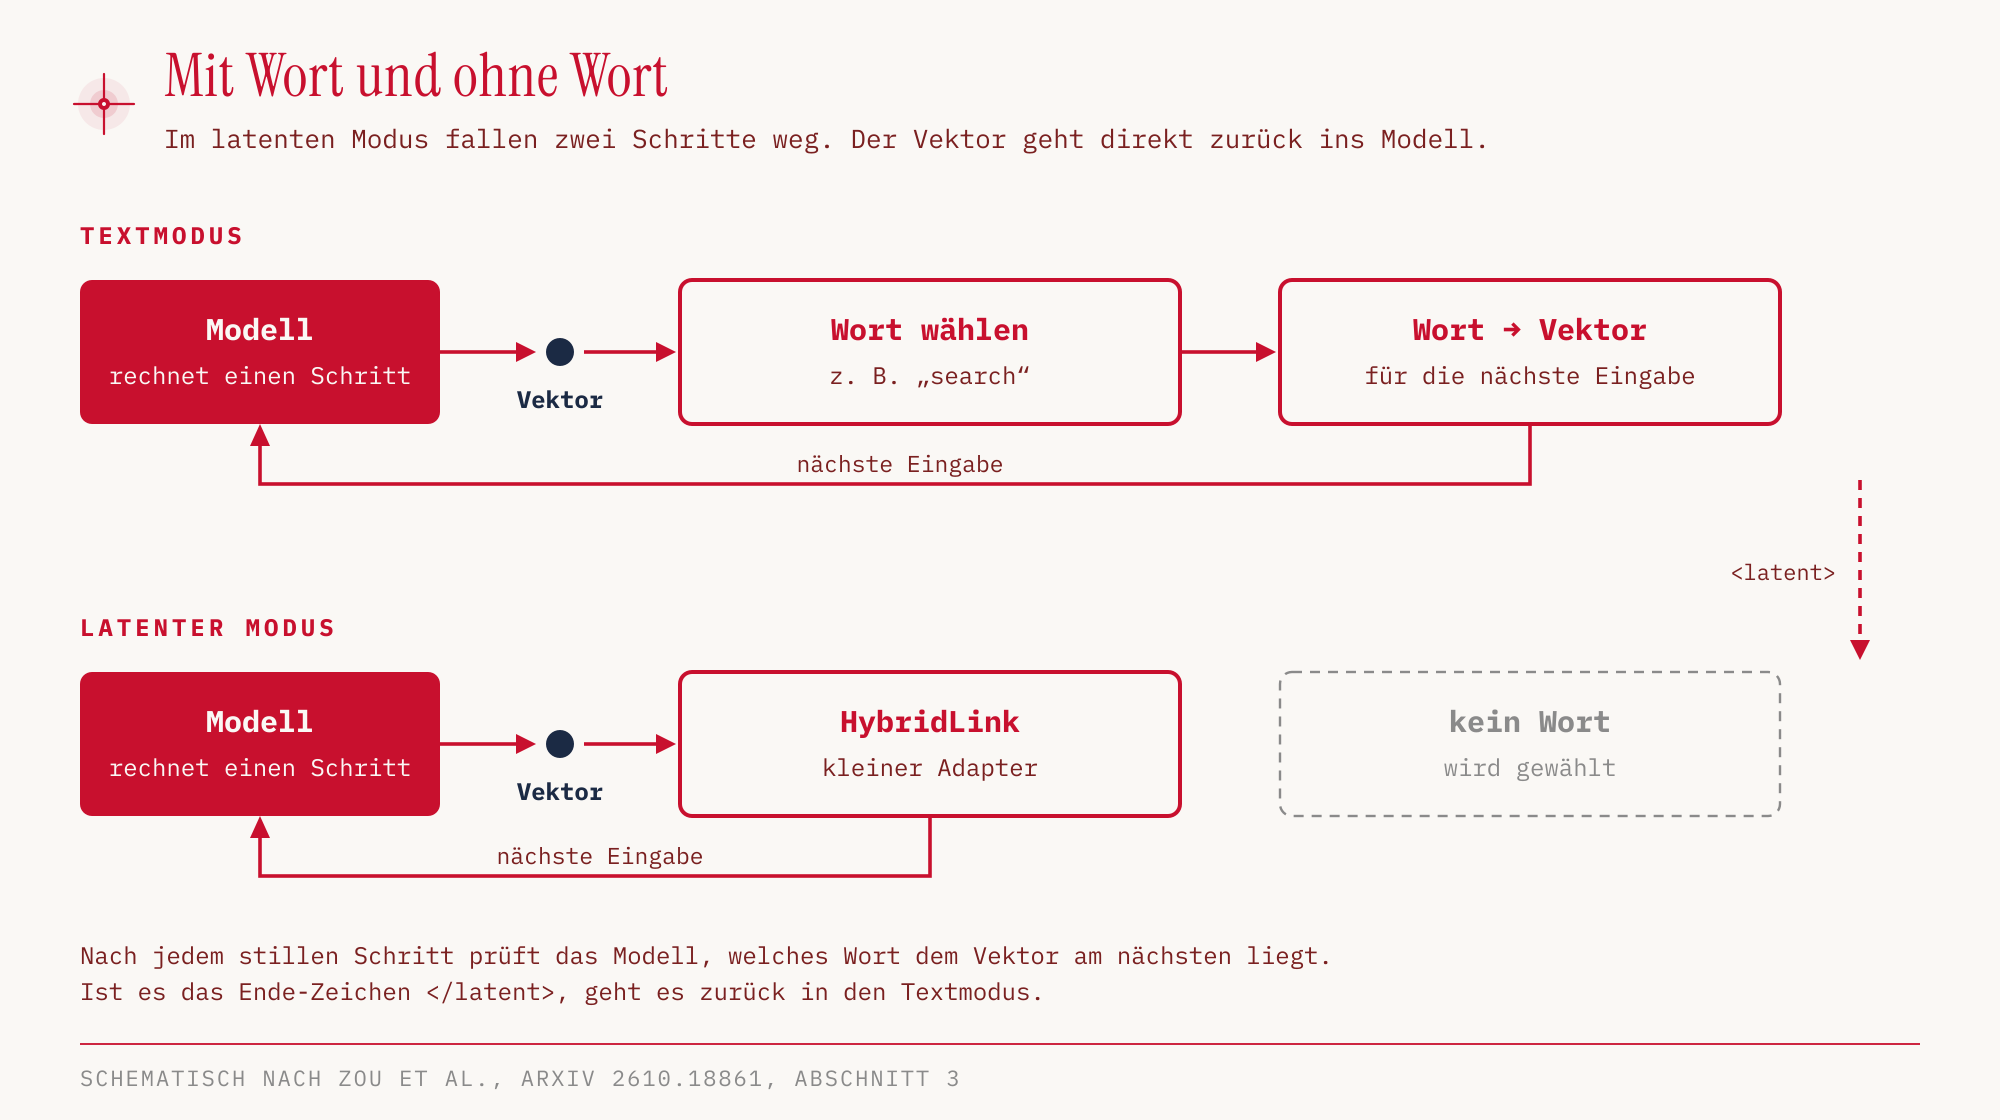
Ein HybridAgent arbeitet in zwei Modi. Im Textmodus verhält er sich wie ein normales Sprachmodell. Schreibt er das Sondertoken <latent>, wechselt er in den latenten Modus.
Dort wird kein Token mehr ausgewählt. Der letzte Hidden State, also der Vektor, den das Modell nach der letzten Schicht berechnet hat, geht durch einen kleinen Adapter namens HybridLink und wird direkt als nächste Eingabe verwendet. Der Adapter ist ein Residualblock aus zwei linearen Schichten mit etwa 10 Millionen Parametern bei einem 4B-Modell. Er übersetzt den Hidden State zurück in den Raum der Eingabe-Embeddings.
Nach jedem stillen Schritt prüft das Modell, welches Token aus seinem Vokabular dem aktuellen Vektor am nächsten liegt. Ist es </latent>, geht es zurück in den Textmodus, etwa um eine Websuche abzusetzen oder die Antwort zu schreiben. Über mehrere Runden hinweg bleibt der gesamte Verlauf aus Text, stillen Schritten und Tool-Ergebnissen im KV-Cache, den die Autoren als Arbeitsgedächtnis bezeichnen. Standard-Inference-Server können diesen Wechsel nicht abbilden, deshalb hat das Team seine eigene Infrastruktur erweitert.
Trainiert wurde auf Qwen3-Base mit 4, 8 und 14 Milliarden Parametern. Die 54.000 Trainingsverläufe entstanden automatisch aus vorhandenen Text-Agentenverläufen. Externe Sprachmodelle und die Unsicherheit des Zielmodells entschieden, welche Denkschritte still werden und welche als Text bleiben. Tool-Aufrufe und für die Prüfung wichtige Schritte blieben Text. Im anschließenden Reinforcement Learning gab es Belohnung für richtige Antworten, korrektes Format und Tool-Nutzung, aber keine für das stille Denken selbst. Wann der Agent still denkt, hat er dabei selbst gelernt.
Die Ergebnisse auf dem Agenten-Benchmark GAIA sind deutlich (Angaben der Autoren, jeweils Gesamtwert):
| Modell | GAIA | HLE |
|---|---|---|
| HybridAgent 14B | 52,4 | 16,0 |
| Kimi-K3 | 41,7 | 31,4 |
| GPT-5.6-Luna | 37,9 | 29,0 |
| Coconut (14B, älteres Latent-Verfahren von Meta) | 6,8 | 4,2 |
Bei Humanity’s Last Exam (HLE) erreichen mehrere Frontier-Modelle fast doppelt so viel. Gegenüber gleich trainierten reinen Text-Agenten nennen die Autoren 35,5 bis 54,7 Prozent weniger Tokens, 1,8- bis 2,6-mal schnellere Inferenz und 2,7- bis 3,7-mal niedrigere Kosten. Die Kosten sind eine Schätzung aus der Rechenleistung pro Frage, mit angenommenen 2,50 Dollar pro H100-Stunde und 10 Prozent Auslastung. Eine API-Rechnung ist das nicht.
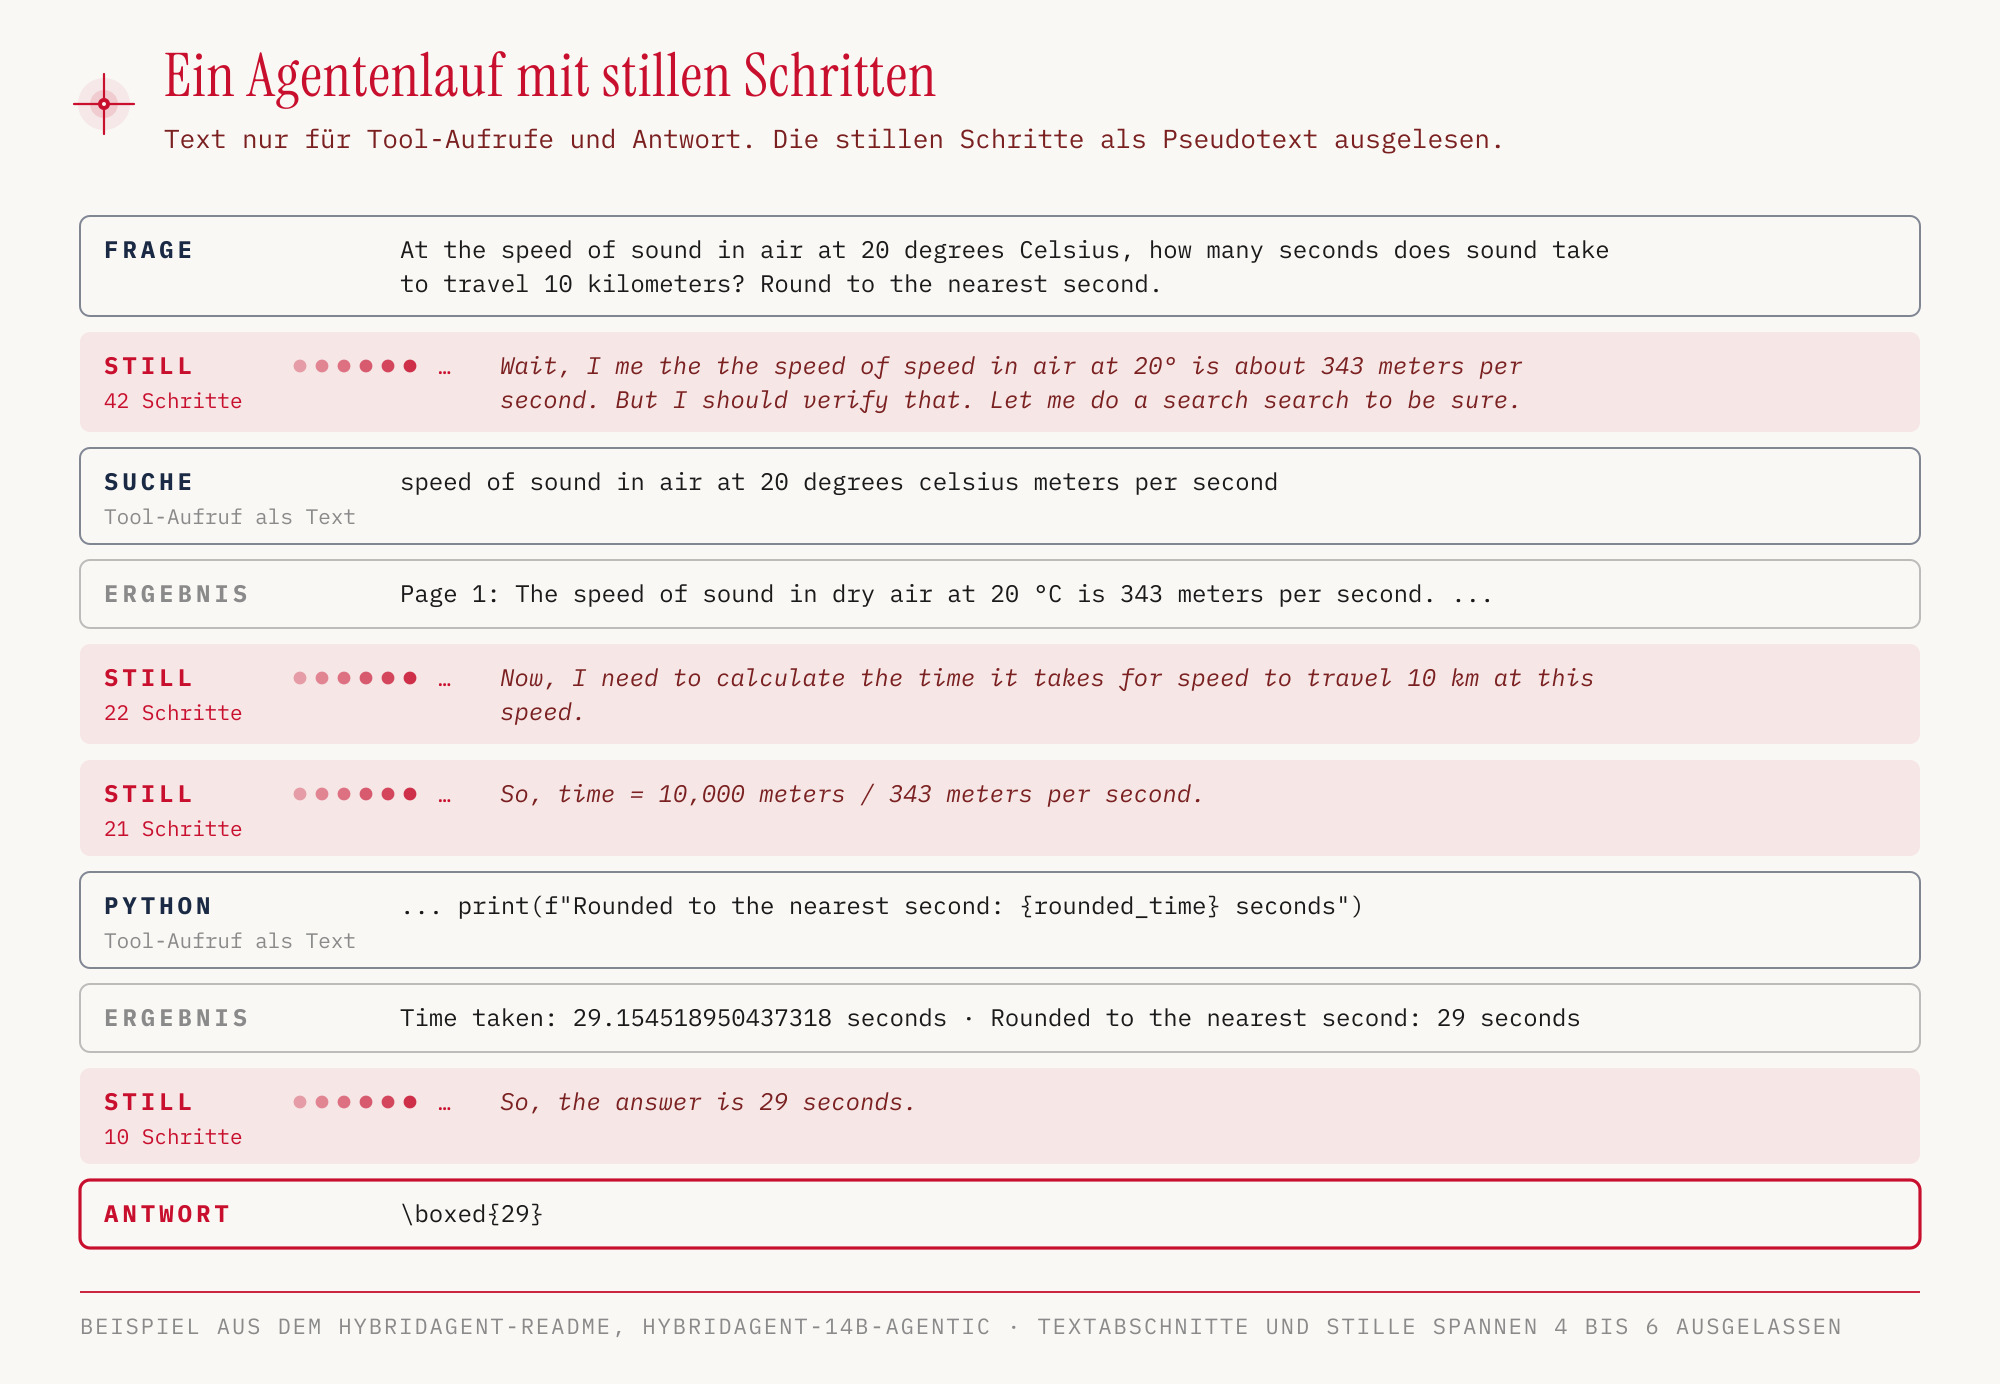
Dass die stillen Schritte tatsächlich etwas bedeuten, prüfen die Autoren mit Eingriffen. Ersetzt man beim 14B-Modell die stillen Schritte durch die einer anderen Aufgabe, fällt die Trefferquote auf MATH500 von 88,2 auf 48,6 Prozent. Ersetzt man jeden stillen Vektor durch das nächstgelegene echte Token, sinkt sie nur auf 87,2 Prozent. Die stillen Gedanken liegen also nahe an Wörtern, und genau darauf beruht die Lesbarkeit. Über den nächstgelegenen Token lässt sich jeder stille Schritt als holpriger Pseudotext ausgeben. Das Repository zeigt dafür ein Beispiel: „Wait, I me the the speed of speed in air at 20° is about 343 meters per second. But I should verify that."
Stille Gedanken, nur für den Betreiber lesbar
An dieser Stelle wird das HybridAgents-Paper politisch. Die Autoren schreiben, Frontier-Labs wie OpenAI und Anthropic hielten die Chain of Thought ihrer Reasoning-Modelle zurück, um geistiges Eigentum zu schützen. Bei HybridAgents existierten die stillen Gedanken nur als Hidden States, lesbar allein über den HybridLink des Anbieters. Es gebe also keinen Text, der abfließen könne. Gleichzeitig könne der Anbieter die vollständige Auslesung auf Sicherheitsprobleme prüfen.
Für einen Anbieter ist das ein Geschäftsargument. Für alle anderen bedeutet es, dass ein großer Teil des Denkens nur noch für den Betreiber sichtbar ist. Eine Arbeit von Forschenden aus OpenAI, Google DeepMind, Anthropic, Meta und weiteren Einrichtungen (Korbak et al., 2025) beschreibt die Überwachbarkeit von Gedankenketten in natürlicher Sprache als neue, aber fragile Chance für die KI-Sicherheit und empfiehlt Entwicklern, die Folgen ihrer Designentscheidungen für diese Überwachbarkeit zu bedenken. Latentes Denken geht in die entgegengesetzte Richtung.
Bei den offen veröffentlichten Modellen liegt der HybridLink allerdings mit im Download, dort kann jeder die Pseudotexte erzeugen. Das Exklusivitätsargument gilt nur für geschlossene Modelle.
Code und Modelle unter MIT-Lizenz
Beide Projekte sind unter MIT-Lizenz auf GitHub veröffentlicht.
NCM (HazyResearch/ncm) enthält den Modellcode und ein Auswertungsskript. Tokenizer und Generator für jede Aufgabe aus dem Paper, also XSum, WMT14, Sudoku in drei Stufen, LM1B in drei Größen, TinyStories und OpenWebText, liegen samt Testdaten auf Hugging Face. Ein Trainingsskript enthält das Repository nicht. Empfohlen werden Python ab 3.10 und PyTorch mit CUDA.
HybridAgents (togethercomputer/HybridAgent) enthält den Code für Training, Inferenz und den Pseudotext-Inspektor. Die Agentenmodelle mit 8 und 14 Milliarden Parametern und die Trainingsdaten für beide Trainingsstufen liegen auf Hugging Face. Für die Websuche braucht das Tool einen Tavily-API-Schlüssel. Für HybridSFT empfehlen die Autoren 8 bis 16 GPUs, für HybridRL 32 GPUs auf vier Knoten.
Fazit
NCM ist eine saubere Übertragung einer Bildtechnik auf Text. Ein Tokenizer zerlegt Text in Ebenen von grob nach fein, ein Generator füllt jede Ebene in einem einzigen Durchlauf, und das Ergebnis ist bei kleinen Modellen schneller und sparsamer als die Diffusionsmodelle, mit denen es sich misst. Das Sudoku-Ergebnis zeigt, wo parallele Verfahren insgesamt stark sind, bei Aufgaben, in denen jede Stelle von jeder anderen abhängt. NCM liegt dort knapp vorn.
Bis zum Einsatz in großen Sprachmodellen fehlt noch viel. Feste Längen, ein Modell pro Aufgabe und eine Größe weit unter einer Milliarde Parameter sind keine Kleinigkeiten, die sich nebenbei erledigen. Weiter reicht das HybridAgents-Paper. Wenn Modelle beim Denken die Sprache verlassen, wird schnelleres Denken mit weniger Einblick erkauft.
NCM ist eine Fortentwicklung, kein fertiges Werkzeug. Eine Skizze dessen, was nach dem Token-für-Token-Schreiben kommen kann.
Quellen
- Kumbong, Khare et al.: Next-Concept Modeling: Fast, Parallel Coarse-to-Fine Text Generation, arXiv 2610.14162, Oktober 2026
- NCM-Code und Modelle, GitHub, MIT-Lizenz
- Zou et al.: Hybrid Reasoning Agents, arXiv 2610.18861, Oktober 2026
- HybridAgent-Code und Modelle, GitHub, MIT-Lizenz
- Tian et al.: Visual Autoregressive Modeling: Scalable Image Generation via Next-Scale Prediction, arXiv 2404.02905, 2024
- Hao et al.: Training Large Language Models to Reason in a Continuous Latent Space (Coconut), arXiv 2412.06769, 2024
- Korbak et al.: Chain of Thought Monitorability: A New and Fragile Opportunity for AI Safety, arXiv 2507.11473, 2025
- OpenAI: Reasoning models, API-Dokumentation